


 您尚未登录账户
 您的企业账号申请正在审核中


排好文档还不够,Rerank 5把证据细化到段落
检索系统找到了正确文档,大模型却仍要读完一大段无关内容。Cohere于10月21日正式推出Rerank 5,试图把这个问题再往前解决一步:除了给候选文档排序,还能在同一次调用里标出与问题相关的文本片段。对企业知识库而言,变化不是再换一个聊天模型,而是重新决定哪些证据应该进入它的上下文。
快速看点:新系列分为Pro和Fast两档,均支持段落筛选;Context Focus默认关闭,需要显式开启;输入仍然只有文本,PDF和表格必须先转换为可用内容。文档相关分数也不等于答案正确率,更不意味着系统可以越过原有数据权限。
搜索之后,多一道细选证据的工序
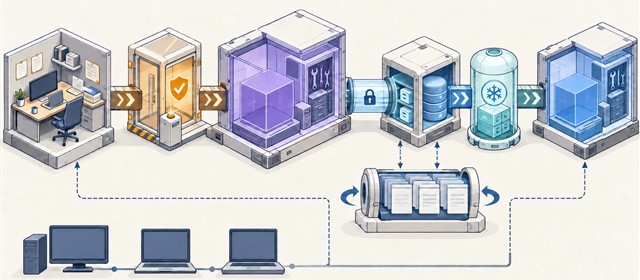
在常见的检索增强生成流程中,关键词或向量搜索先找出一批候选,重排模型再比较这些内容与问题的关系。Rerank 5接在已有搜索之后,不要求重建索引,也不替代最前面的召回。没有被搜索系统找回的关键材料,不会因为增加重排而自动出现。
这次的两个模型分别面向质量优先和低延迟、高吞吐场景。Pro适合需要推理或专业知识的复杂查询,Fast侧重频繁搜索的工作负载。哪一档更适合业务,仍要结合候选数量、文本长度与服务响应时间测量,不能直接把厂商测试吞吐当作自己的容量承诺。
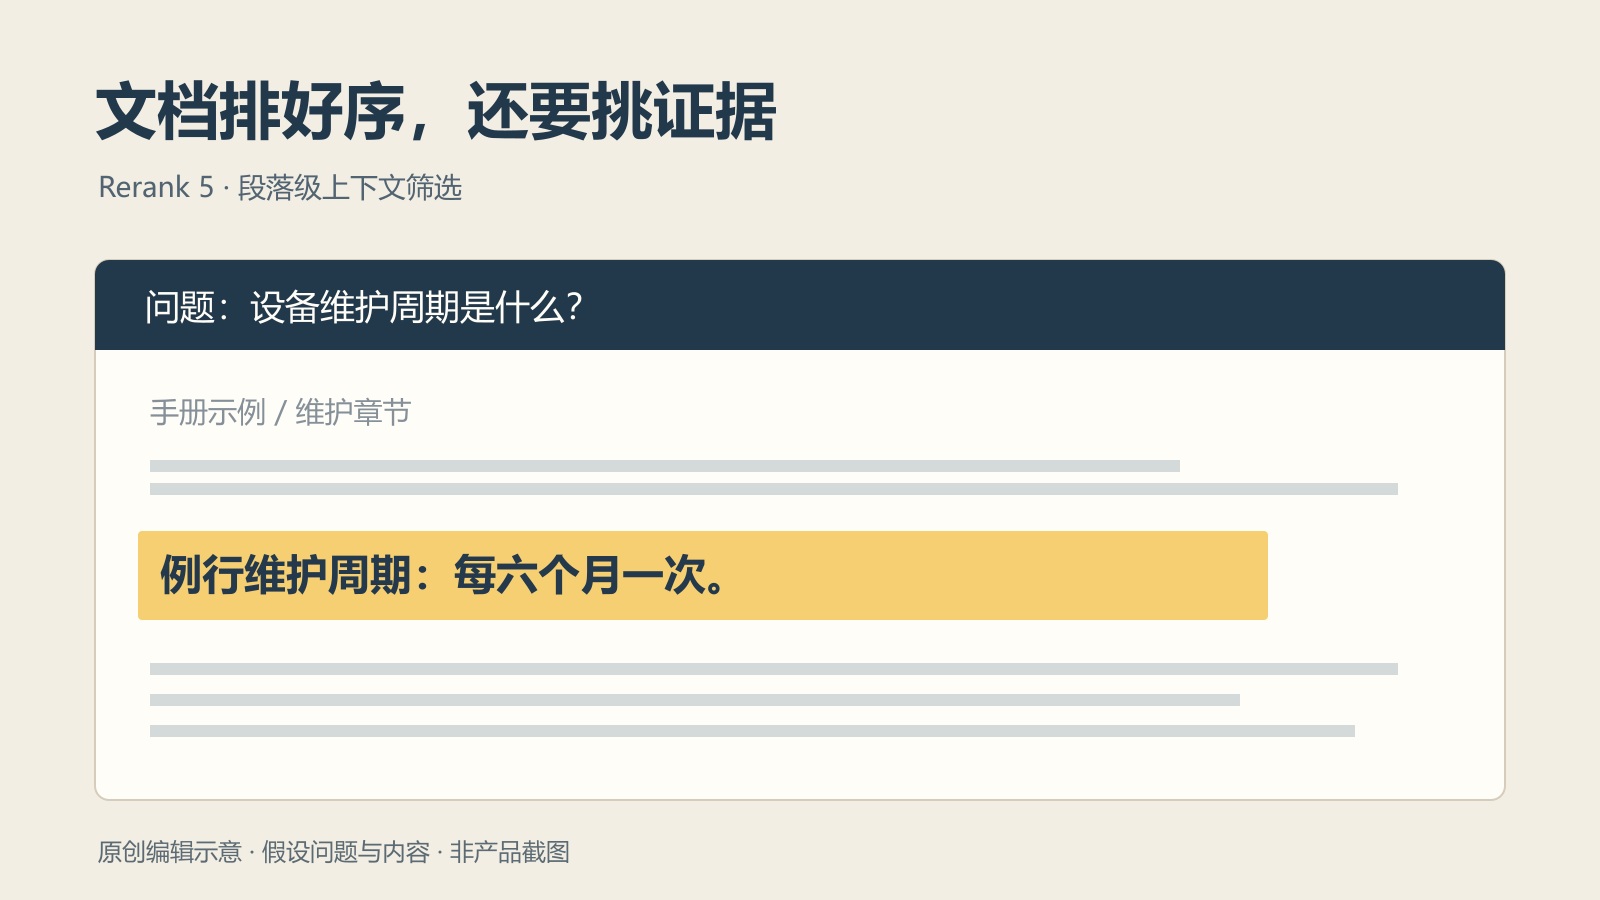
新增的Context Focus把筛选粒度推进到文档内部。例如,用户只问某台设备的维护周期,整份手册里还可能包含运输、安装和保修条款。系统可以把相关句子交给生成模型,或在界面上高亮,而不必每次把整份手册都放进去。这只是说明机制的假设场景,不是已验证的客户收益。
默认不开启,返回位置也要正确处理
开发者需要在请求中启用relevant_spans,并设置筛选阈值及每份文档返回片段的数量上限。结果中的start、end是相对于原始文档的字符位置,另有片段得分。接入程序应保留文档身份和原始文本,不能先随意删改文本,再用旧位置去截取证据。
如果没有片段达到阈值,对应结果会省略relevant_spans字段。因此,“字段不存在”需要成为正常分支,而非一律认定接口故障。业务可以继续搜索、保留更完整上下文,或拒绝回答;具体策略应事先定义,避免模型在没有证据时自行补全。
模型支持的上下文上限为32768个token,口径是单个问题与单份文档合计,不是整批搜索结果,也不是回答长度。同时,接口中的每文档token上限默认是4096,长文本会按该参数截断。接入者不能只看到32k标签,就假设所有长文档已被完整阅读。
另一项容易混淆的设置是top_n:它限制返回的重排结果数量,不等于输入候选的数量,更不是召回率保证。相关片段能力目前在Cohere API有明确说明,不能据整个模型系列的渠道清单,推定每个平台、每个SDK版本都已暴露完全相同的参数。
少读一些,不等于总成本一定下降
产品文档明确列出文本输入,半结构化记录可整理为YAML字符串。所谓面向PDF的检索评测,使用的是解析后的文本,不代表重排接口原生接受扫描图片。若解析阶段丢失表头、单位或跨页关系,后面的排序无法凭空修复这些信息。
片段筛选更适合目标明确的问题。对整篇总结、跨段推理,以及表格、表单和代码,切得太细可能丢掉条件、否定词或依赖关系。降低送入大模型的token数,应与证据完整性一起验收,而不是只追求上下文越短越好。
Cohere同时强调相关分数校准,但它衡量的是文档是否有用,而非生成答案必然正确。企业仍需检查自己的数据分布、错误类型和拒答策略。本次报道没有调用付费接口做独立复测,也不把厂商的内部评测提升改写成普遍准确率。
总成本同样需要重新算账:重排服务、文档解析、网络等待、失败重试与后续人工检查都在链路里。即使生成模型少读了内容,系统总时延和总费用也未必同比下降。私有VPC或本地部署需要联系供应商,并非下载开放权重后立即可用。
小编判断:把证据留存纳入上线标准
值得关注的不是“又有一个检索模型”,而是企业可以更细地控制模型读什么。实施团队可先用一组真实业务问题,对照完整上下文与筛选后上下文,分别观察答案是否有据、关键条件是否丢失、人工介入次数,以及端到端延迟和费用。
还应保存候选文档、筛选位置和最终交给模型的内容,让出错时能区分是召回遗漏、片段切错,还是生成环节误解。上述是交付建议,并非产品已经提供的全部治理功能。能少传无关内容只是第一步,能解释为何保留这些证据,才更接近可运维的企业知识系统。