


 您尚未登录账户
 您的企业账号申请正在审核中


500页文档按页结算,OpenDocRouter让换模型少改接口
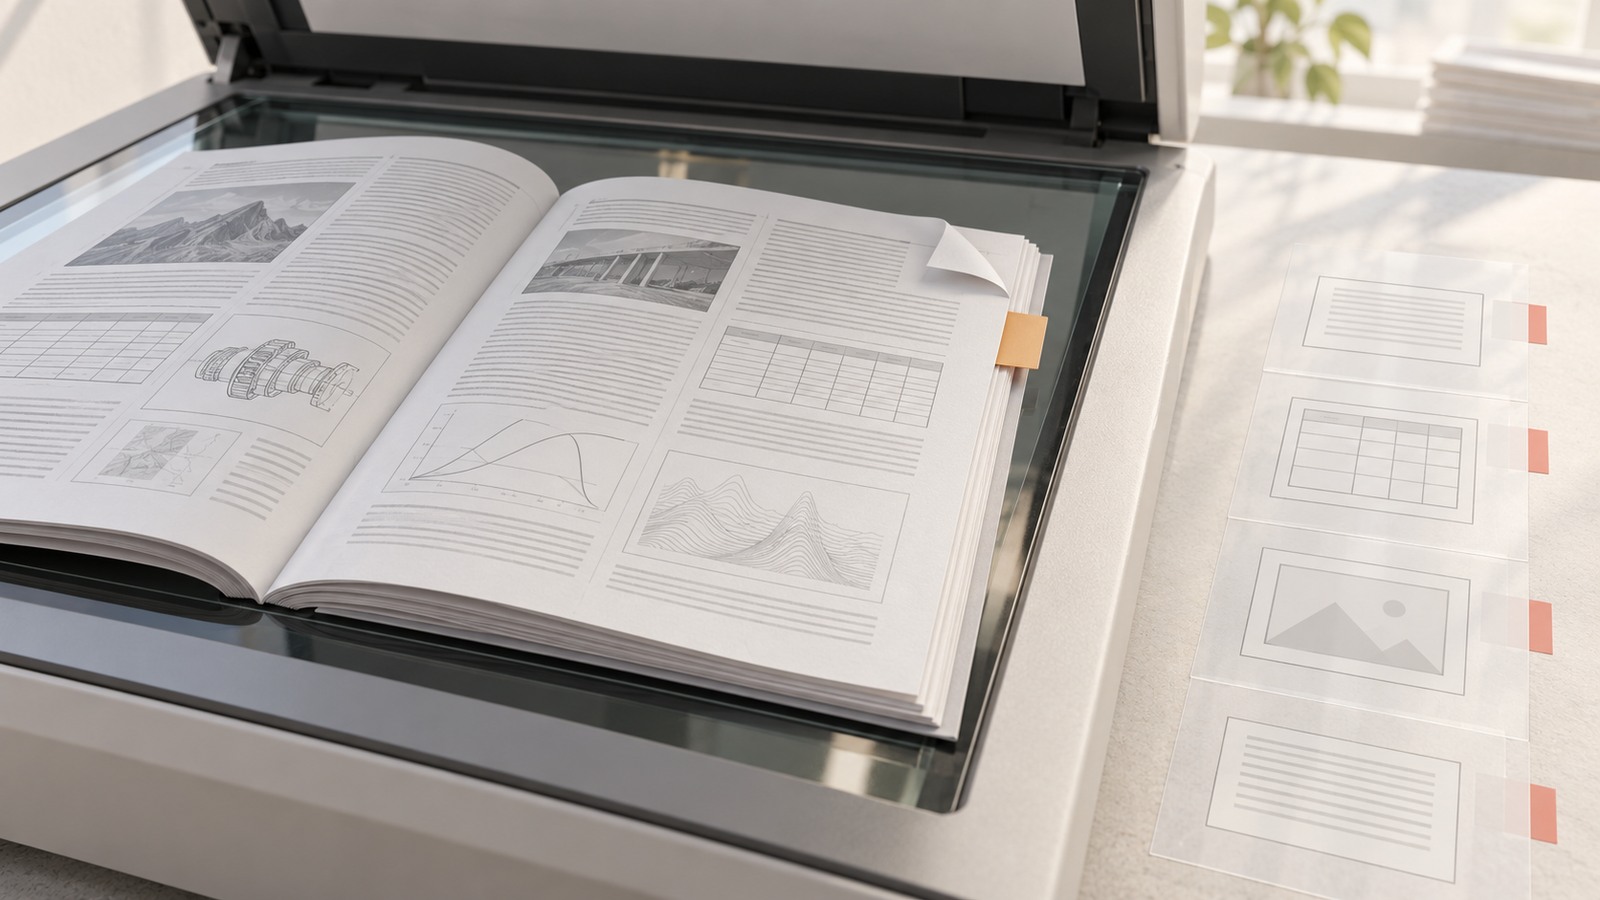
把整份PDF转成Markdown,不等于所有页都已经处理成功。LlamaIndex于10月7日上线OpenDocRouter,将多种开放和前沿文档模型放在同一API之下,每页单独记录状态和费用;最大请求支持500页或50MB。对需要反复比较OCR模型的企业,这项产品的价值不仅是少写几个接口,还在于能把失败页、布局、缓存与模型版本纳入同一交付流程。
统一入口之后,模型差异仍然存在
OpenDocRouter为每个模型配置版本化解析配方,配方包含提示词、处理过程与设置;只要可能改变输出,配方版本就变化。企业可以在同一个调用结构里切换模型,但同一输入经过不同配方,结果仍可能不同,模型名不能独自承担复现责任。
接口接受PDF、PNG和JPEG,也可读取公开HTTPS链接。发布时同时接入前沿模型与开放OCR模型,包括MinerU、PaddleOCR等,选型不再只围绕一个供应商。平台用ParseBench比较质量与成本,但企业仍需用自己的票据、扫描件、表格和专业符号补测。
需要强调,统一API不是自动替业务选择最优模型的证明。公开接口要求调用者指定模型ID;不同价格、速度、语言与布局能力,需要由实施团队建立选择规则。正式上线前还应核对当时的模型目录,避免把发布时列表当成永久可用承诺。
按页记录,让局部失败可被追踪
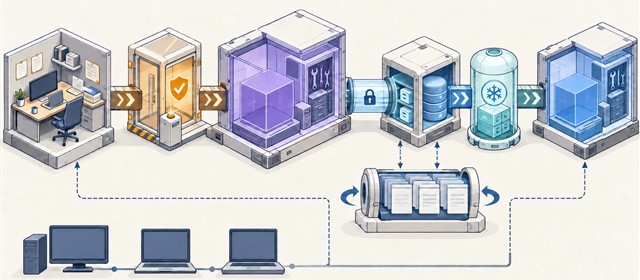
同步模式支持最多50页,返回每页结果。整项状态可以是completed、partial或failed,分别表示全部成功、部分成功或全部失败。一个请求有返回,并不意味着每页都可直接入库;只拼接成功页会让遗漏悄悄进入知识库。
超过50页使用异步任务,并必须开启cache,最多500页或50MB。接口先返回任务ID,再通过轮询取得进度和结果;较大输出还会分段返回,需要继续读取下一游标。输入大小限制、页数限制和输出分页是三个不同问题。
文档页会针对超时、限流、供应商错误、容量不足或重复输出自动重试一次。仍失败时,可以只指定那些页重跑或更换模型。上传文件只能被使用一次,需要重传或采用URL;平台内置重试也不等于任何失败都能恢复,损坏、加密或不可读输入先需处理。
布局和缓存,把便利变成明确的条件
开启layout可给Markdown补充页内定位,使用统一类别表示标题、正文、表格、图片和公式等元素。坐标以页面为基准,部分元素可能有多块区域,也可能没有可定位框。统一类别便于下游使用,但并不会自动消除阅读顺序或表格结构错误。
如果布局解析失败,页面仍可保留Markdown,布局状态单独标错,且不收布局费用。正文成功和布局成功应分别检查:面向检索可能只需要可靠文本,面向原文高亮、审计和人工复核,则需要坐标与对应页一致。
不启用缓存时,同步结果只在响应中返回;开启缓存后,结果加密保存24小时。异步解析期间保留文档,结束后按约定清理;状态、页数与费用仍留在历史。这里描述的是平台公开条款,底层模型供应商的数据处理条件仍需另外核对。
小编判断:用成功页成本,而不是接口次数选型
产品按token收费,失败、缓存和空白页不收费;布局额外每百万token0.20美元。新账户有5美元额度,充值从10美元起并收5%手续费。这些是发布时条款,实际项目还需看各模型价格、重复处理比例与人工复核成本。
知识工程团队可以保存文档指纹、模型与配方版本、页级状态、费用和布局结果,并让失败页进入复核队列。在更换配方前,用一批固定样本比较字段遗漏、表格结构、阅读顺序和语言错误,避免把接口升级误认为质量升级。
公开材料提供了文档、OpenAPI和Python/TypeScript客户端,接口行为可检查,但没有给出广泛企业部署的ROI、人工介入率或长期可靠性。真正的选型单位应是通过业务验收的一页,而不是完成的一次API调用;更低token价格,也可能被返工和漏页抵消。