


 您尚未登录账户
 您的企业账号申请正在审核中


一页读出文字与图表,LightOnOCR-3把布局一起开放
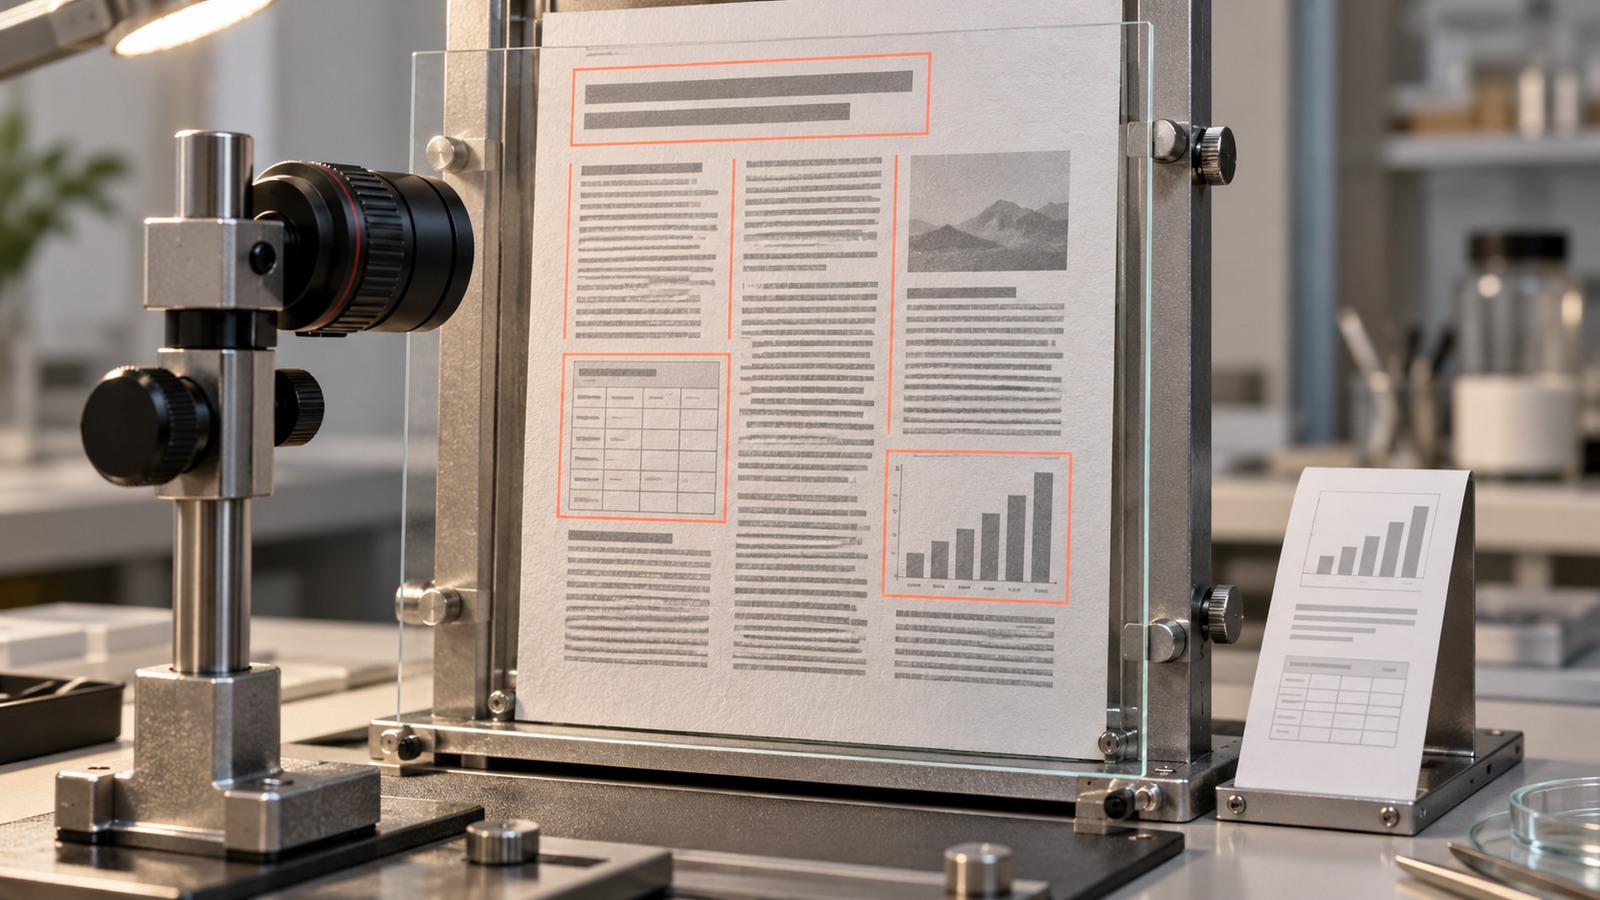
一页文档不仅需要“读出来”,还需要知道每段文字在哪里、图表中的数值是什么。LightOn在10月8日发布LightOnOCR-3,提供三种容量的开放模型,把转写、区域定位和视觉内容理解放进一次输出。4B版本的ParseBench五类综合得分为75.1,但图表和旧扫描件仍有明显短板;对于企业知识工程,这项发布更重要的价值是可下载、可检查和可复测。
一个模型,读文字也定位文档区域
LightOnOCR-3提供0.8B、1B和4B三个命名版本。1B保留上一代架构,0.8B与4B采用Qwen3.5视觉语言架构。三款都能使用空文本提示完成传统转写,也能以grounding提示增加区域类别、边界框、图片描述和图表数据。
布局坐标归一化到0~1000,文字块带上区域标记,图片得到简短描述,图表则转成HTML数据表。下游可以把段落和原页位置对应起来,让知识库回答支持原文高亮和人工核查,而不只是给出一段无法追踪的文本。
它试图减少检测、识别、版面分析和图表理解之间的管线拼接。模块变少有助于部署和维护,但一次生成里的文字、位置和数据仍可能分别出错;统一输出并不意味着每个任务都自动正确,验收需要保留这些不同维度。
75.1综合分,没有覆盖全部文档短板
LightOn公布的ParseBench五类综合成绩中,4B为75.1,0.8B为74.6,1B为71.4;4B图表类得分66.1,视觉定位68.3。不同模型在表格、图表、内容忠实度和位置定位上各有优势,整体平均不能替代具体业务的关键字段正确率。
在olmOCR-Bench中,4B综合为86.3,但旧扫描件子类仅52.5;法语文档测试中,手写与表单子类也明显低于普通页面。企业处理历史档案、手写备注或低清扫描件,应单独设立抽样,而不是把一项综合分写成所有文档的准确率。
官方提醒,OCR评价会受格式影响:同一脚注用HTML、LaTeX或普通文字表示,对人可以等价,对编辑距离却不同。团队发布了评分前的规范化函数和复现脚本。上一代olmOCR综合成绩排除了页眉页脚,新版包含该类,因此两行总体分数不能直接比较。
少生成token和少看像素,省的是不同成本
在相同512页上,官方比较的grounding完整输出比部分对照模型少9%~14%token。这里包含区域标记、图片描述和图表数据,并非只测格式包装开销。减少解码量可能降低服务负担,但结果必须先通过内容完整性检查。
速度测试采用每模型一张H100、vLLM 0.30.0和相同服务器参数,页面按各模型对应评测设置渲染,再改变负载。0.8B与4B最佳评分采用400 DPI、5百万像素上限,单页图像约4.8千token;降低渲染尺寸会改变输入工作量。
改为长边1540像素后,官方峰值吞吐分别达到4.78和3.36页每秒,较各自高分辨率配置提高44%和66%。这不是硬件白得了更多算力,而是图像token减少了。小字体、细线和图表可能随降分辨率丢失,需要同时重测质量与吞吐。
小编判断:先把内容和坐标分开验收
权重以Apache 2.0开放,并提供转换、可视化和评测代码,企业可以自行运行与复测。本轮核验确认模型卡和公开权重文件存在,没有下载整套模型或在本地GPU重跑,因此文中成绩仍属于发布方测量,不是ATYUN独立复现。
生产试点应保留原文件、页码、渲染参数、模型版本与原始输出,分别检查文字遗漏、阅读顺序、表格关系、边界框和图表数值。若回答涉及金额、单位或时间,错误坐标和估计的图表数值都可能成为下游风险,不能只验文字看起来流畅。
公开训练说明也承认,图表标注中未印出的数值可能依据坐标轴估计,读不出的格子应保留为空。实际业务同样需要区分抄录、估计和缺失;对需要精确数字的报表,应回到图表原数据或交由人复核,不把模型推测默认为事实。
这次发布的实用价值,在于开放一个可检查的文本与布局联合模型,为本地文档AI提供更多容量选择。是否能替代现有管线,仍取决于企业数据、质量阈值、硬件、并发和复核费用。最有价值的优化,是让通过验收的文档更便宜,而不是只让转写更快。