


 您尚未登录账户
 您的企业账号申请正在审核中


单请求不提速,ReplaySSM把混合模型优化押在高并发
模型每生成一个词,都要搬动一份状态,速度可能卡在内存而不是计算上。NVIDIA与普林斯顿Dao AI Lab研究团队提出ReplaySSM:先保存最近输入,再周期更新检查点。在作者四模型测试中,批大小256的标准解码提速1.20至1.47倍,批大小1却没有加速。10月9日提交的论文与12日技术解读,把混合模型服务优化的适用边界摆上台面。
固定状态,也会成为带宽负担
状态空间层把历史信息压入固定大小的状态,避免注意力缓存随上下文不断增长。但固定不代表免费:常规实现每一步读取旧状态、更新,再写回。大量请求同时运行时,反复搬运矩阵可能比计算下一步输出更费时间。
混合模型同时使用状态空间层和注意力层,瓶颈不能只凭架构名称判断。对部署团队而言,关键问题是某个模型在目标并发下,时间究竟花在状态读写、算子执行,还是请求排队。优化一个局部环节,不保证用户等待时间同比缩短。
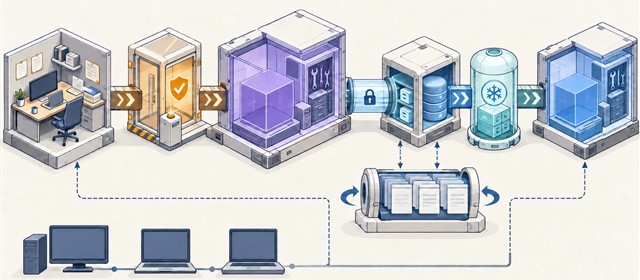
ReplaySSM保存一个检查点和短输入缓冲,多数步骤只计算输出,缓冲填满后才把记录合并到检查点。可以把它理解为保留底稿与最近修改,暂不每次重写整份档案。该比喻只解释存储关系,不意味着可以随意删掉历史信息。
提速数字必须带着测试条件读
作者测试两类架构的四个模型:4B模型使用单张H100,120B级模型使用单张B300;标准性能比较保持FP32状态,窗口长度为16,与调优后的vLLM基线对照。结果来自研究团队,不是所有硬件与生产负载的独立认证。
批大小256时,状态内核提速1.46至1.80倍,整个解码步骤提速1.20至1.47倍。两个口径已经展示了局部收益被其他环节稀释的现象。企业做成本预算应采用完整服务测量,而不是挑最大的内核数字作为全站吞吐承诺。
单请求没有提速尤其值得注意。内部工具若流量很低,主要开销可能来自启动、网络或工具等待;高峰服务则需测不同并发、输入长度与输出长度。合理试点应同时看吞吐、尾部延迟、显存占用和失败率,不能只看平均生成速度。
回滚更轻,精度仍要独立验证
推测解码先提出几个候选token,再让目标模型验证。传统状态更新若已经吃进被拒绝的候选,就需要恢复快照。保存输入后,可以通过移动缓冲指针丢弃未接受记录,避免每个候选都保存一份完整状态,减轻高并发下的显存压力。
这种优化没有取消目标模型的验证,也不等于允许较差答案通过。实施测试需要确认候选接受行为、边界刷新和恢复路径一致;普通解码与推测解码应各自建立基线,不能把不同批大小、候选长度或精度设置的结果拼成同一条收益曲线。
低精度也是另一条独立路径。方案让低精度副本供输出读取,高精度检查点负责后续递推,减少舍入误差反复进入状态更新的机会。但它并非所有模型都无损,上线前还应检查长序列、任务正确率,以及缓存迁移或请求恢复后是否出现漂移。
小编判断:先确认实现,再讨论采购收益
公开仓库提供Apache 2.0代码和性能脚本,但其完整实验环境是基于特定vLLM提交的研究分支。仓库说明,上游已合并Mamba2普通解码内核,其他部分路径仍在分支或开放中的合并请求里。支持某个组件,不等于完整方案随任一正式版本自动到位。
因此,试点应固定引擎提交、模型权重、精度和硬件,保存正确性测试与压测结果,再逐步扩大流量。关注的不只是成功请求速度,还包括取消、重试、前缀复用、显存紧张时的迁移和恢复;这些路径经常决定优化能否留在生产环境。
ReplaySSM的价值在于把状态管理拆成可验证的工程问题,而不是再给出一个无条件的加速倍数。若业务确实受高并发状态带宽限制,值得评估;若工作流主要等待外部系统,先把时间花在哪里测清楚,往往比急着更换推理内核更有用。评估还应纳入回退版本与值班处置,把升级失败后的恢复时间记进总成本,避免吞吐提高却让运维风险被遗漏。