


 您尚未登录账户
 您的企业账号申请正在审核中


最快的引擎也要先过精度关,NVIDIA拆解推理调优
一条推理路线跑得最快,可能只是它没有保住所需的输出质量。NVIDIA在10月23日的技术拆解中,把TensorRT全局性能调优的关键问题说得更具体:不是无条件追求最快,而是先定义哪些候选可以接受,再比较它们的性能。相关能力此前已在TensorRT 11.1引入,这次是架构与使用边界说明,并非今天又发布一个新版本。
快速看点:一,把不同编译设置组成可搜索的构建路线;二,精度校验需要用户提供参考输出并显式启用,不会自动理解业务质量;三,最优结果只属于已测候选及对应环境,换模型、输入形状或硬件后不能直接沿用原结论。
同一个模型,未必只有一条编译路径
TensorRT会把模型转换为可执行引擎,过程中涉及算子融合、代码生成和内核选择。默认设置是一套经过设计的通用路径,但不同模型的瓶颈不同,同一项优化可能帮助一个网络,却对另一个网络没有作用,甚至使它变慢。
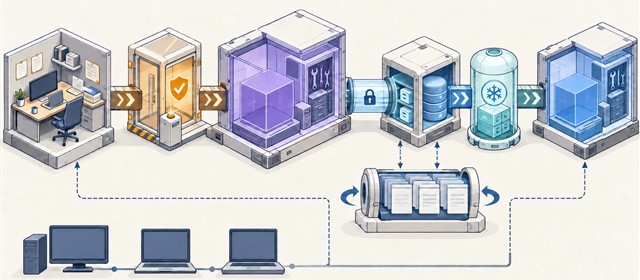
全局性能调优将可调整的编译选项组合成构建路线,围绕选定范围逐个构建、测量和记录。trtexec提供现成搜索循环,构建配置接口则允许开发者检查和设置路线。它比较的是实际运行的候选,不是仅凭某个局部算子更快就判断整套引擎一定受益。
现有开源示例把单次候选交给独立子进程,父进程收集结果;候选崩溃或结果缺失会被记录为失败,而不是自动成为优胜者。这使一次失败不必被当作整个搜索空间的结论,但也不代表工具能够修复模型、驱动或所有构建错误。
精度是准入条件,不是调优器自带的业务判断
当前文档明确,参考输出与误差阈值是激活精度校验的重要输入。只启动搜索,并不能假定已经完成质量验证。团队需要准备与真实任务相关的输入、可信参考结果和适当的误差度量,再让超出阈值的候选退出最终选择。
例如,数值误差可以用不同方式衡量:平均误差较小,不代表每个关键输出都稳定;某些任务更关心最大偏差或特定边界案例。调优器不会替业务负责人决定什么错误可以容忍。一次通过只说明候选满足已提供样本、指标与阈值,不是对所有未来请求的准确性承诺。
技术文章给出了多个工作负载的厂商性能比较,但本轮没有复现实验所用完整环境,也没有把那些倍率采用为通用提速数字。尤其不能把引擎内部的GPU测量结果直接写成完整应用响应时间:数据读取、检索、排队、网络和后处理都可能仍占主要耗时。
搜索预算、恢复能力与平台条件都要检查
搜索空间会随选项数量增加而迅速膨胀。fast先测默认路径,再逐项变化;full枚举组合,更适合较小范围;mixed利用先前测量筛选有帮助的设置后继续探索。较少候选有利于控制时间,但同时意味着不能宣称已经找遍所有可能路线。
缓存可以保存已完成轮次的路线和测量结果,帮助继续中断的任务。不过,当前主分支实现对mixed第二阶段注明会重新开始,并非每个搜索阶段都能原位接续。保存全部候选引擎也会占用存储,恢复和调试选项应按具体版本验证,不宜从“支持缓存”推导任意中断都无损续跑。
平台支持同样有限。当前开源循环依赖Linux进程机制,Windows路径不支持这套调优;所需内部选项数据库也有发行形态限制。这里说的是已阅读示例的条件,不能扩大成任何TensorRT环境、任何显卡和任何系统都能照同一条命令工作。
模型、输入形状、GPU、驱动、CUDA或相关软件版本改变,都可能改变路线收益。文档还提示构建并非严格逐位确定,因此最终保存的引擎文件比一串路线文本更能代表真正验收过的对象。应同时保留模型、环境、样本、测量和引擎身份,而不只记录“某个参数组合最好”。
小编判断:优化交付要把质量证据一起保存
这次说明的价值不在于承诺每个模型都会加速,而是把优化拆成可以复核的实验:哪些候选失败、哪些通过质量门槛、最终比较的到底是什么。默认路径可能已经足够好,没有找到收益也应是允许出现的结果,而不是放松精度要求直到得到漂亮数字。
实施团队可以先固定一个有代表性的基线,限制搜索预算,保存实际交付引擎,再到目标环境验证业务负载。代码主分支与当前文档不是某个旧版本的永久合约,迁移时仍需对应核对。只有速度、质量和环境三者都能对上,调优结果才有资格进入生产发布,而不是停留在一次演示里。