


 您尚未登录账户
 您的企业账号申请正在审核中


少同步一张表,Databricks让三类数据直接接入AI检索
库存刚变化,AI助手却还在推荐旧商品,问题未必出在模型不够聪明,也可能是检索索引尚未同步。Databricks在10月26日的技术说明中,介绍AI Search如何直接连接流式表、物化视图和使用Iceberg格式的托管表。它想减少的是源数据与检索之间的一层中转工程,而不是宣布企业从此不再需要考虑数据更新、权限或验收。
快速看点:既有Delta表之外,三类表可以直接作为索引来源;Iceberg范围是v3及以上的托管表,并非任意外部Iceberg数据;直接接入仍要选择同步模式和端点,实时性与访问控制不能自动画等号。
少一份中间数据,少维护一条自建同步链
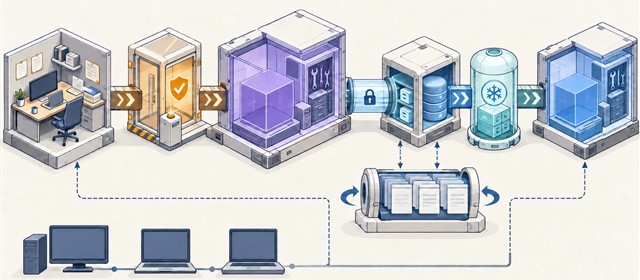
过去,这些来源若要进入AI Search,客户通常需要先创建单独的Delta表示,再维护它与源数据之间的同步。这样一来,团队既要关心原始表,也要检查中间数据和索引:字段映射、更新遗漏、同步失败都可能变成额外运维工作。原生支持减少的是这部分重复管道,而不是取消索引本身。
操作入口仍沿用已有方式,从源表创建Delta Sync索引,可以通过界面或API完成。数据团队不必仅为接入这三类来源另设计一套检索工作流。需要特别区分的是,Delta Sync是索引的同步类型名称,不能因此把所有源数据都理解成必须先被用户复制为一张独立Delta中间表。
这次10月26日文章属于机制与接入说明,相关产品文档已标注10月21日更新,不能据此断言所有能力都在26日首次上线。对已有部署,真正要核对的是当前工作区、源表与端点是否满足条件,而不是只按一篇文章的日期判断自己已经完成迁移。
三类来源,解决的是三种不同业务状态
流式表适合持续到达的事件,比如新商品、库存或可用性记录。物化视图则可以聚合、筛选和连接多个来源,把近期活动转成更适合查询的状态。前者偏向不断新增的事实,后者偏向经过计算的上下文;它们进入检索后,都还需要应用检查记录是否符合当前业务问题。
使用Iceberg的托管表,则让采用开放表格式的数据直接成为索引来源,减少为搜索单独转换格式的需求。但支持范围明确包含“托管”和“v3及以上”两个条件。开放格式不等于任何引擎、任何版本或任何外部表都可以无差别直连,跨环境应用也不能跳过平台要求。
例如,一个库存助手既需要最新到货记录,也需要经过聚合的商品可售状态。直接连接可以缩短接入链路,却不会替团队定义什么叫“可售”。数据质量、业务口径与检索相关性仍需分别测试,不能把管道少了就直接推导为推荐准确率或收入提高。这里的场景是用途举例,不是已量化客户收益。
原生接入以后,同步和权限仍要自己验收
标准端点可以选择持续或触发式同步;持续模式会为同步流水线配置计算资源,费用相应更高。触发式需要主动发起同步。存储优化端点则只支持触发式,每次同步会重建部分索引,未变化行的已有嵌入可以复用。选择了更大容量,不能同时默认它也提供持续同步。
创建过程还有实际前提:工作区需启用Unity Catalog与无服务器计算,标准端点要求源表使用变更数据馈送;物化视图需要先开启外部元数据。创建索引需要相应模式下的建表权限。接入虽然统一了工作流,并没有把数据准备和授权检查从部署清单里拿掉。
权限尤其不能想当然。AI Search索引不支持行列级权限自动保护这类细粒度访问,应用可以利用过滤接口实现自己的访问控制。哪些人可以查询端点,与某次查询应该返回哪些记录,是两道不同的检查。员工身份、可见数据和过滤条件应在应用层形成可验证的约束,不能把“进入统一目录”当作天然继承全部源表规则。
本次没有运行云端样例或测量同步延迟,也没有采用厂商索引提速数字。企业可以按数据更新到可检索的时间、漏同步情况、查询权限和任务相关性建立回归,再比较减少中间管道后的运营成本。只看接口创建成功,还不能宣布知识库始终最新且安全。
小编判断
企业AI常常不是缺少一个更强模型,而是缺少一条稳定、可解释的数据通路。Databricks这次说明的价值,是减少来源到检索之间不必要的搬运;剩下的同步选择、业务口径和权限责任也因此更应清楚。链路变短只是交付起点,能证明数据何时更新、谁能看到什么,才是落地质量。