


 您尚未登录账户
 您的企业账号申请正在审核中


一台相机一个模型,AWS把质检扩容变成版本管理问题
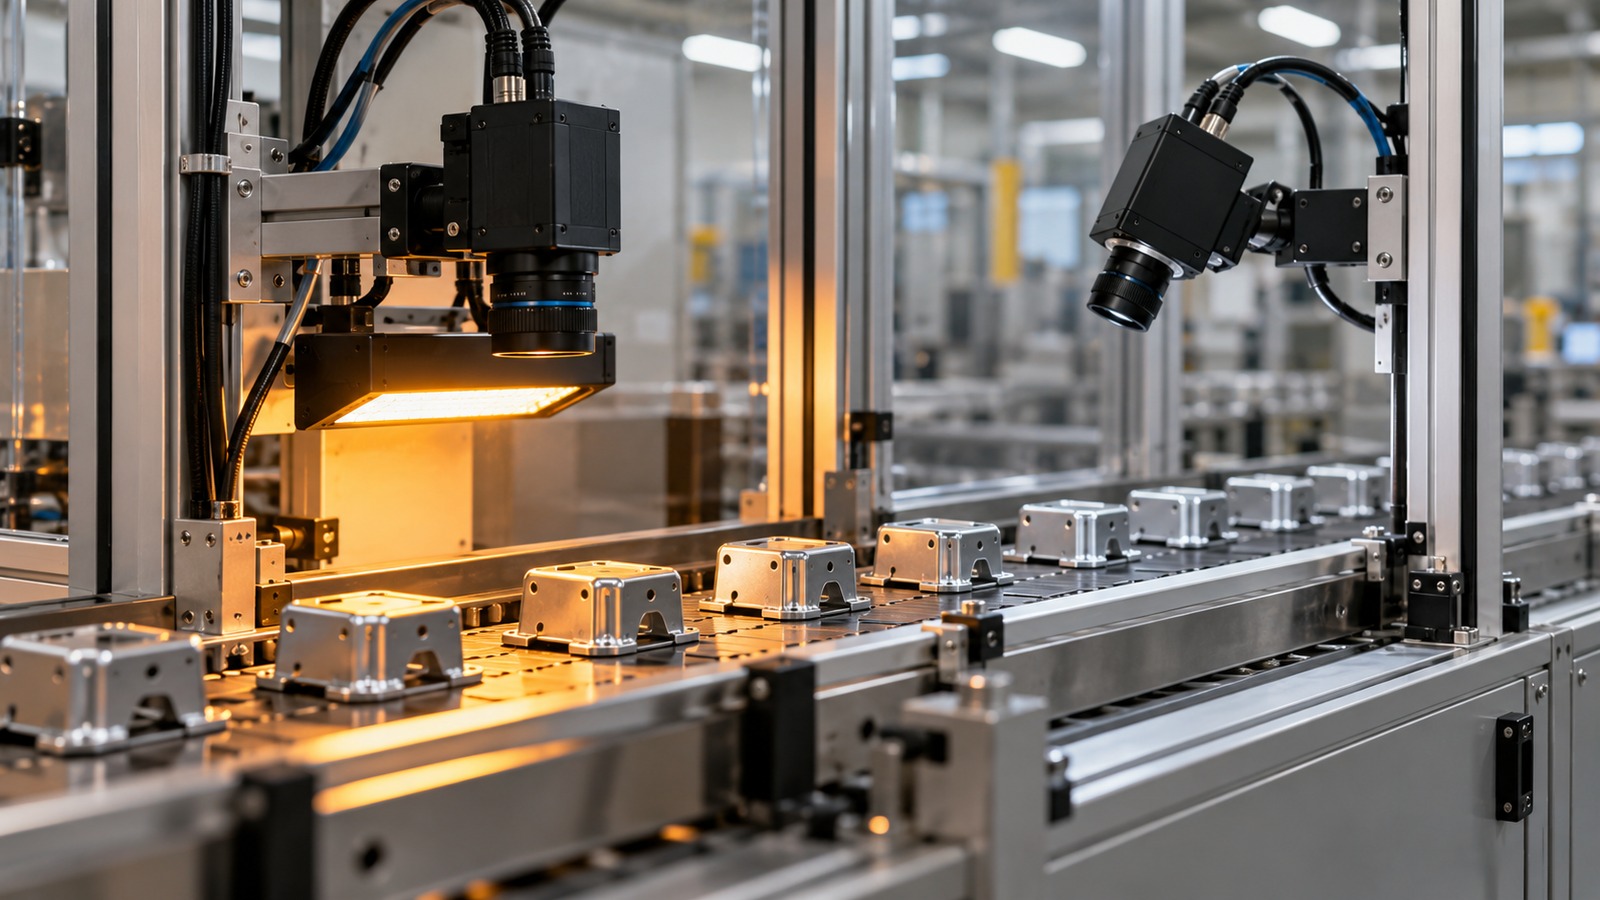
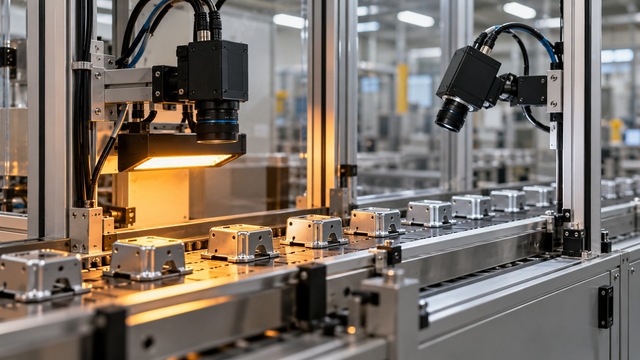
一条产线上的质检模型跑通,并不意味着换到几十条线还能直接复制。相机角度、金属反光和环境照明一变,同一种零件也可能呈现不同图像。AWS在10月26日公开的SageMaker SDK v3参考架构,把问题从“训练一个好模型”转向“管理每台相机自己的模型历史”。它给出了可检查的样例代码,也明确留下设备交付与实际规模验证的边界。
快速看点:一是异常检测与缺陷分类分成两条训练分支;二是先评测导出的ONNX产物,通过门槛后再编译、登记;三是设备下发不在样例内,训练并发控制也不等于已经证明千台设备的生产吞吐。
相机身份进入模型历史,才有持续迭代
这套方案延续了早期边缘视觉MLOps的思路,但面向当前SDK v3重整流程。每次执行由相机标识参数化,分别训练异常检测器和缺陷分类器。前者学习正常图像并识别偏离,后者进一步判断缺陷;两条分支不是“任意一个过关就能证明整套系统合格”。
模型包保留相机身份与评测信息。再次训练时,系统寻找同一台相机此前合适的模型作为起点,而不是把另一台设备的最近版本随意接过来。没有历史版本时则走初始训练路径。这种做法让设备差异和模型演进可以被追踪,也把数据拆分、父模型和产物版本变成了交付的一部分。
对于实施团队,这里真正可复用的是身份与谱系管理。设备名称、数据版本和模型版本如果在试点时靠人工记忆,扩容后就很难回答“这台相机现在用的是哪批数据训练的模型”。先把这些关系明确下来,通常比继续增加一个训练按钮更重要。
评测的是要发出的产物,不只看训练成绩
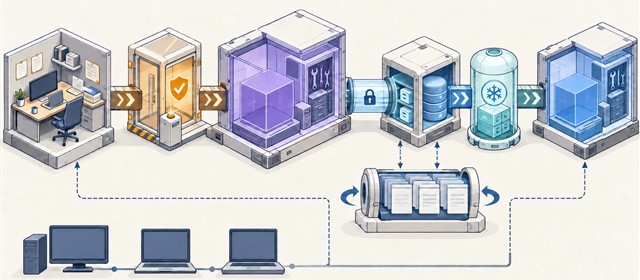
训练脚本导出ONNX后,质量门槛评估的是该导出产物,而不是仅在内存中表现正常的训练模型。通过后再交给SageMaker Neo编译,登记步骤依赖编译完成。流程因此把“训练成功”“导出可用”和“有目标平台编译产物”分成不同检查点,减少只凭训练日志就宣布完成的风险。
分类分支同时检查平衡准确率与缺陷召回率。道理很直接:如果绝大多数零件正常,一个总说“正常”的模型也能得到好看的总体准确率,却漏掉真正要抓的少数缺陷。当前仓库提供的门槛是演示参数,不能照搬为工厂质量标准;企业仍需按自身缺陷类型与漏检代价制定验收。
两条分支各自判断,通过的一支仍可能登记,另一支失败不代表所有产物自动回滚。登记项引用的训练容器也没有推理服务,不能直接当成可部署的在线端点。默认Linux x86-64用于验证,其他设备还要单独编译并验证运行时;把文件送到设备、切换版本和回退,仍需下游系统接手。
数据验收同样不能只看文件是否重复。样例按解码后的图像内容分配数据拆分,能防止完全相同图像跨集合,但无法自动识别近似重复、相邻视频帧或同一生产批次的关联。真实项目仍应先按这些关系划分数据,避免测试结果被相似样本抬高。
并发控制要处理丢失响应,而不只是计数
可选的设备群编排通过队列、Lambda、Step Functions和DynamoDB控制训练准入。当前配套文档建议先从并发1开始,再按训练、处理与编译配额调整。它限制的是经此编排启动的执行;直接启动流水线会绕开这一限制,而且拿到名额不等于已经预留到云端算力。
故障恢复尤其值得注意。当前实现保留执行所有权与启动标识,释放名额前确认父流水线和相关编译任务结束;状态读不到时继续保留,而不是只因时间到了就清空。这样处理的是请求可能成功、响应却丢失的窗口,不能简化成一次失败就重加、结束就减一的计数器。
样例还提醒,大量等待请求会消耗状态转换并可能超时,持续数千设备场景需进一步改造调度。合成数据与小样本图像示例也不是实际产线验证。本次不采用介绍中的低价单次运行数字作为总成本,更不把说明里的默认参数、无需提额等口径当成所有账号都成立的承诺。
小编判断
这份参考的价值,在于把“模型能跑”拆成可交接、可追踪、可恢复的工程环节,而不是宣称质检已经无人化。对企业AI交付来说,真正难复制的往往不是训练代码,而是设备差异、错误窗口与版本切换。先把这些边界写进验收,再谈扩大设备数量,才有机会把试点变成稳定运营。