


 您尚未登录账户
 您的企业账号申请正在审核中


价格减半,GPT-6.1 Terra把视觉操作推向日常任务
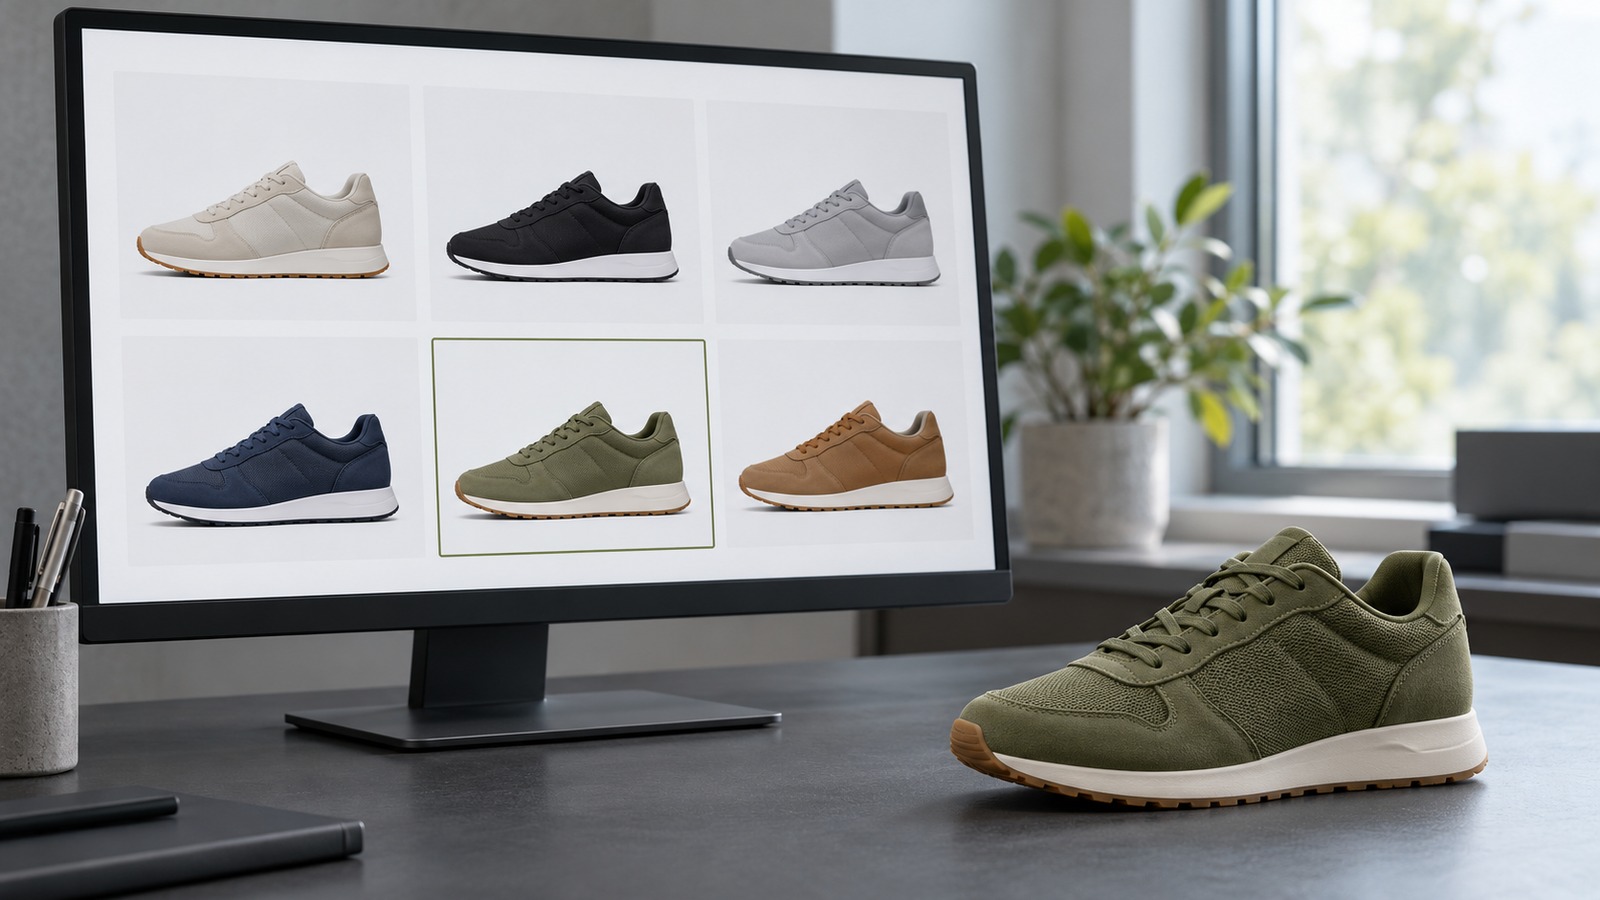
把图片看懂,再把结果填进业务系统,正在成为模型厂商争夺的日常工作。10月26日,OpenAI发布GPT-6.1 Terra,主打视觉推理、计算机操作和自然写作。它的标准API输入、输出单价均为GPT-6.1 Sol的一半,但这不意味着企业账单自动减半:长上下文、缓存写入、工具调用,以及失败后需要多少次返工,都要另算。
快速看点:一是标准API每百万输入、输出token分别为1美元和5美元;二是图像输入与工具协作构成主要能力,调用工具需要Responses API;三是模型已进入Work和Codex,但普通Chat入口、企业权限与地域条件不能混为一谈。
从识别图片,走向完成一段业务流程
Terra的定位不是单纯回答“图里有什么”。商品照片与目录条目匹配、阅读技术图纸、理解应用屏幕,再把判断转成操作,才是其瞄准的工作链路。对企业而言,识别环节只是入口,后续字段是否写对、对象是否匹配、变更能否复核,决定这条链路有没有交付价值。
API模型标识为gpt-6.1-terra。模型支持文本和图像输入、文本输出,音频和视频并不是该模型的原生输入输出模态。能参与视频编辑类任务,不等于它本身就是视频生成模型;调用图像生成工具,也不能理解为该模型直接输出图像。工具、宿主应用和模型各自承担不同职责。
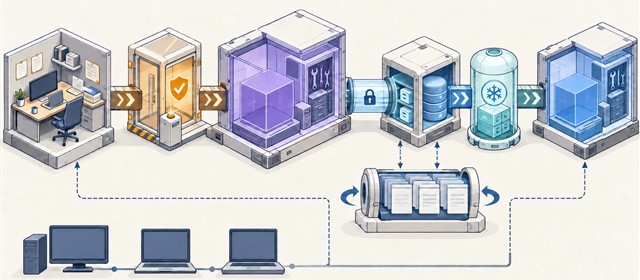
推理强度提供从none到max的多个选项,默认medium;上下文窗口为105万token,最大输出12.8万token。这些是接口规格,不是任何业务一次就能完成的保证。接入团队还要为可操作的应用、账号、数据与工具建立边界,模型换新不会替代这层系统集成。
低单价之外,长上下文和缓存要分开算
标准计费下,每百万普通输入token为1美元,缓存读取为0.05美元,输出为5美元。30分钟缓存写入为1.25美元,12小时缓存写入为2.50美元,不能把便宜的缓存读取价格套在全部输入上。缓存能否命中,也取决于实际请求是否满足使用条件。
当输入超过27.2万token时,整个请求的输入及缓存费率变为两倍,输出费率为1.5倍。也就是说,支持百万级上下文并不代表长短请求同价。Fast模式又有不同费率;企业在做预算时,应先固定上下文区间、运行模式与输出长度,再比较同一个任务的成本。
一个更实用的测算方法,是把“读图、定位业务对象、执行、检查、必要时重试”看成一次完整任务。只看单token价格,无法说明哪种方案更省钱。还需要分别记录成功率、人工介入、耗时和重试次数,避免把更低单价误写成已经实现的ROI。
上线范围明确,评测也不能替代生产验收
产品文档列出,Terra已可用于Plus、Pro、Business、Enterprise和Edu方案中的ChatGPT Work及Codex;Work也支持移动端。它并不在普通Chat中提供。企业访问还取决于工作区开放情况及管理员控制,浏览器和计算机操作分别有自己的配置与访问要求,不能把模型上线等同于所有设备立即可用。
能力改善仍应按测试条件理解。例如,OpenAI公布Terra在最高推理强度下的Terminal-Bench 4.0成绩为50.3%;这是厂商评测中的命令行工程任务表现,不是企业软件的交付通过率,也不是所有视觉操作任务的准确率。本轮没有独立复跑该基准,不据此承诺真实系统无人值守。
对复杂程度更高的编程任务,发布说明仍把Sol和Astra列为更合适的选择。企业试点可以先选低风险、可撤销、可抽样复核的流程,再测它在自己数据和工具上的表现。涉及资金、权限和对外提交时,审批与审计不能因为模型更快、更便宜而省略。
小编判断
Terra值得关注的不是“廉价替代旗舰”这一句口号,而是让图像理解与操作执行有机会进入更密集的日常流程。它降低的是尝试成本,不会自动消除流程设计和验收成本。谁能在同样质量要求下,把失败、人工接管和完整任务账单一起压下来,谁才真正把模型价格优势转成了交付优势。