


 您尚未登录账户
 您的企业账号申请正在审核中


79.9分仍非全过,BlenderWorld拆开3D交付验收
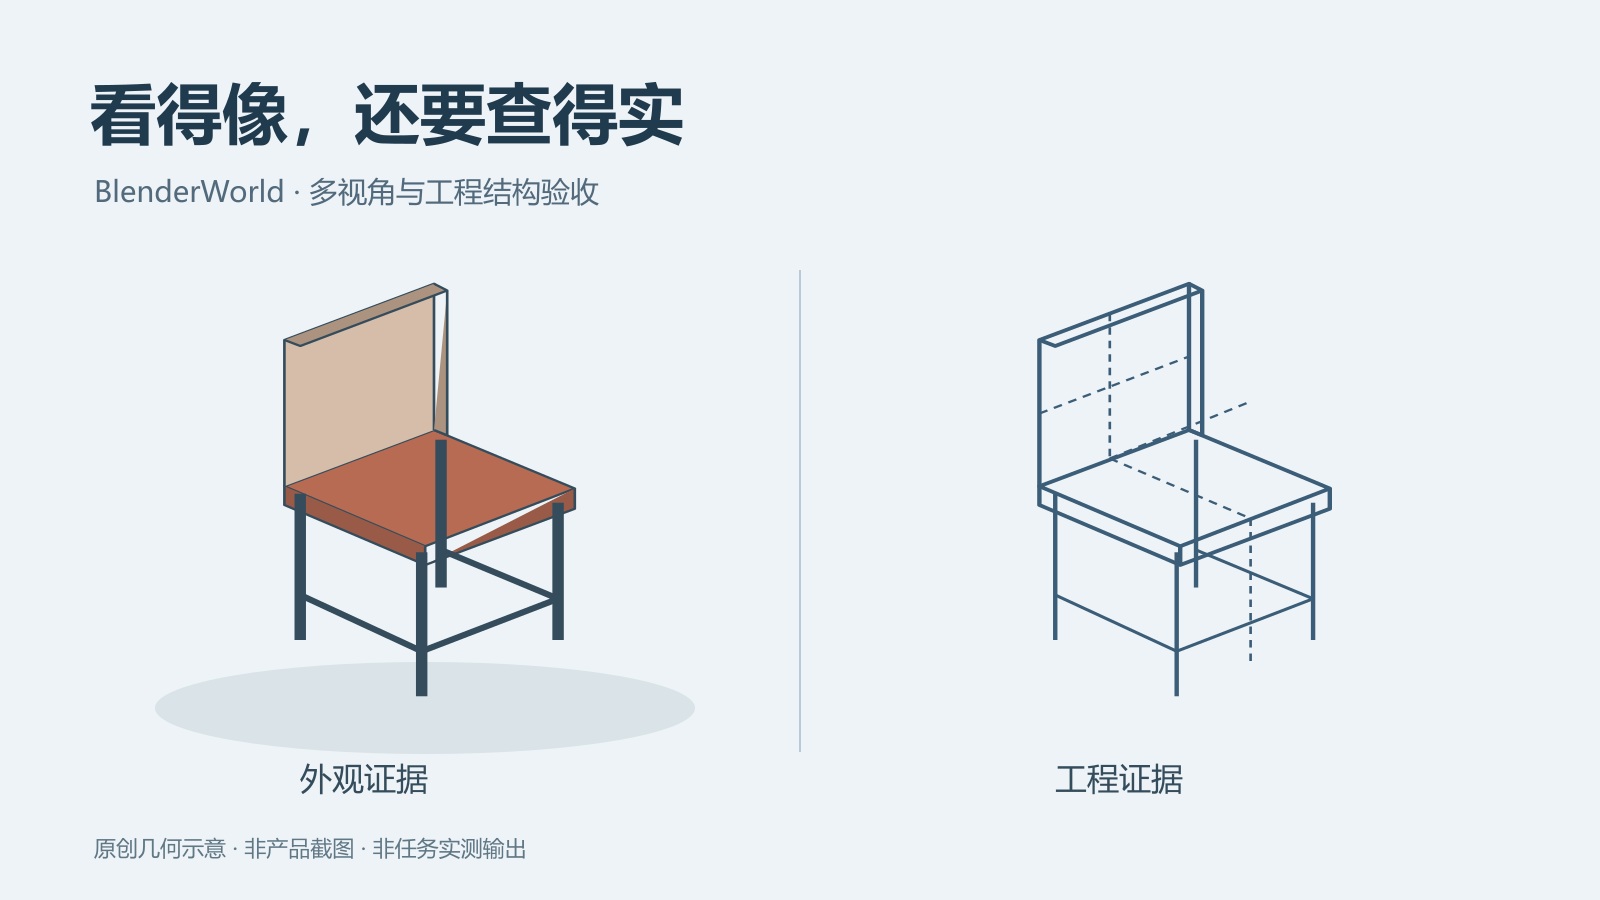
拿到79.9分,仍有超过一半任务没有满足全部要求。BlenderWorld给3D智能体出了一道更接近交付的问题:它做出的椅子、建筑或科学示意,不仅要在一张图里看着合理,还要保存成可编辑工程,经得起换个角度和检查内部结构。论文于10月14日提交,作者来自阿里巴巴及浙江大学、香港中文大学等机构;这不是今天刚发布的新模型,而是一套检验创作结果的研究基准。
快速看点:223项任务覆盖9个大类、22个子类,配有2651条二元判定标准;提交物包含可编辑的.blend工程与任务要求的导出文件;多视角图像和工程检查分别提供证据。综合分数与所有要求全部通过,是两种不同口径,不能把前者直接改写成交付成功率。
为什么一张漂亮图片不够
现有智能体已经能够写脚本、调用工具,在Blender中搭建和修改场景。但实际委托往往混合了外观与结构要求:产品需要指定材质,建筑要保留空间关系,教学模型要呈现内部组件。正面看上去接近参考图,并不证明遮挡处、背面或对象关系同样正确。
BlenderWorld把任务组织为重建、修改及参考驱动的设计,覆盖建筑、产品、自然环境和科学可视化等场景。输入有78项纯文本、130项图文及15项视频加文本任务;其中59项还附带结构化规格文件。这59项与前面的输入类型交叉,并不是另加59道题。
任务要求最终交出可编辑Blender项目,而不是只提交一张渲染图。这样,下游才能继续调整对象、查看层级或导出所需媒体。缺失工程文件会带来明确失败,失败任务也不能从总体统计中悄悄去掉,否则漂亮样例会掩盖无法交付的部分。
八个视角负责看,结构检查负责查
评测首先打开提交的工程,根据任务挑选八个互补视角,每个视角采用1024×1024分辨率、64次采样的Cycles渲染。视角根据任务决定,而非所有任务套同一机位,目的在于让关键要求能够被看见。
取证阶段可以调整相机和构图,却不能修复作者提交的几何、材质、灯光或动画。否则,评测工具就成了第二个创作者,测出来的不再是原智能体完成了什么。场景存在的缺陷,应留在证据中,而不是为了截图好看被重新布置。
随后,两条检查路径分工:视觉模型判断图像中的外观和空间属性,检查智能体直接读取工程的结构与文件属性。某个部件是否属于指定对象、规格是否真的写进场景,不能只靠一张图片猜测。两条路径依旧使用模型判断,不等于所有结果都经过人工验收。
79.9分与42.2%,不能混成一个结论
研究比较了13个前沿模型组成的智能体系统。GPT-6-Astra获得最高79.9的综合分数,但全部二元要求均通过的任务比例为42.2%。综合分数由任务标准得分与整体视觉质量评分各占一半组成,部分条件达标或画面质量较好,都可能抬高平均分。
因此,79.9并不表示79.9%的任务完全交付合格,42.2%也不能直接推广为所有现实3D项目的成功率。任务集合、工具链、推理设置和评委选择共同限定了这个结果;用户自己的素材、验收规范和预算可能完全不同。
比较还包含执行框架差异:部分系统使用Codex,其他系统使用Claude Code,测试采用单次任务尝试及较高推理设置。这个排名展示的是当时协议下的系统表现,不是隔离其他变量后只比较模型权重。换工具、增加重试或人工修订,都可能改变结果与成本。
错误分析指出,智能体可能做出依赖某个视角才能成立的几何,或无法把看到的缺陷转成有效结构修改。能发现“好像不对”,与定位哪个对象、参数或空间关系需要修复,仍是两种能力。观看更多截图不自动等于完成闭环。
小编判断:先把交付物写进验收合同
这套研究最值得企业实施团队借鉴的,是把展示效果与可复用成果拆开验收。试点时就应说明交付的是图片、视频、可编辑工程,还是三者组合;哪些要求可以从画面判断,哪些必须检查文件与场景状态,也要在执行之前固定。
团队可以从少量真实业务任务建立自己的检查清单,保留原始工程、失败结果和评测环境,再分别统计全部通过率、缺陷类型、人工修订量与总成本。这些是实施建议,并非论文已经证明的企业收益,也不意味着基准分数足以替代专业设计审核。
公开任务与评测协议提供了可以检查的方法,但本次报道没有自行运行全部基准。对准备把3D智能体送进生产的团队,真正需要回答的不是“最高能拿几分”,而是下一位同事接过文件之后,是否还能理解、修改并可靠使用它。