


 您尚未登录账户
 您的企业账号申请正在审核中


机架可扩到250千瓦,NVIDIA把部署与验收一起开放
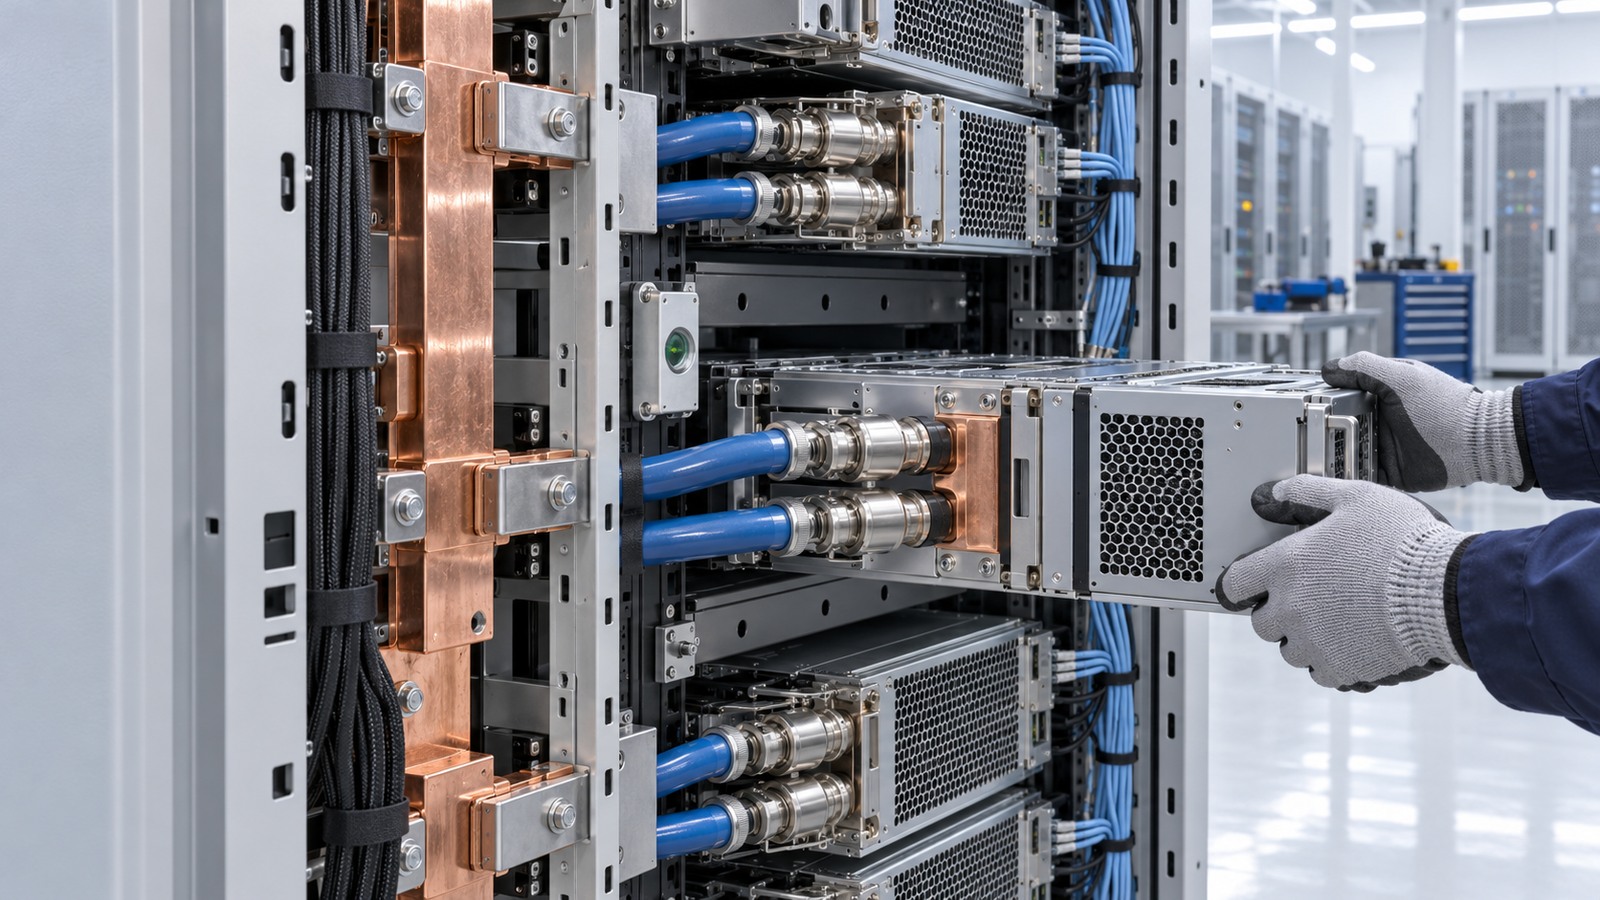
大型AI集群最昂贵的故障,可能发生在训练开始之后。NVIDIA在10月12日OCP活动中开放新的机架与设施设计,并推出DSX的软件组件,把网络配置、上线前验收、机架管理与裸金属部署放进同一交付链。它想解决的不只是更多GPU怎样装进机柜,还包括怎样在昂贵作业开跑前发现坏节点,以及怎样让不同供应商按共同接口制造和维护。
开放接口,把设施变化提前到设计阶段
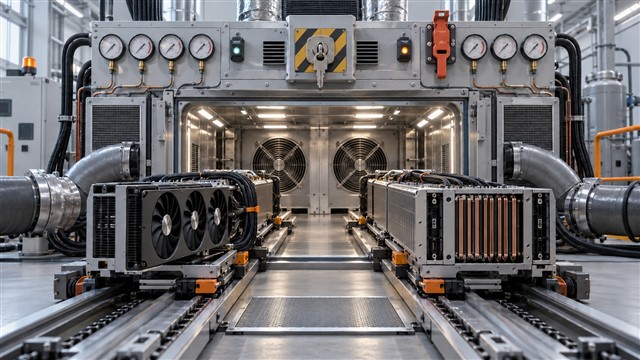
MGX 1.2新增机架级盲配液冷、可互操作机架互连和液冷5000安母排,支持原生19英寸设备、可配置I/O区和无风扇液冷计算托盘。不同设计项服务于功率密度、装配和维护,不能把某一个电流规格直接换算为所有机架的实际耗电。
最高250千瓦是架构支持范围,不是每台部署都以这个功率运行。供电、管路、水质、冗余和维护空间需要一起规划;采用开放接口有助于减少单一供应商的定制依赖,但部件互操作仍需逐项认证。
同轮还发布Open Data Center Specification v0.7和电网扰动响应规格。它们分别描述设施设计与面对电网扰动时的行为,不能和完整产品认证混为一谈。开放文件提供共同目标,实际设备、控制系统和响应能力仍需现场验证。
四类组件,补齐从裸机到运行集群的链条
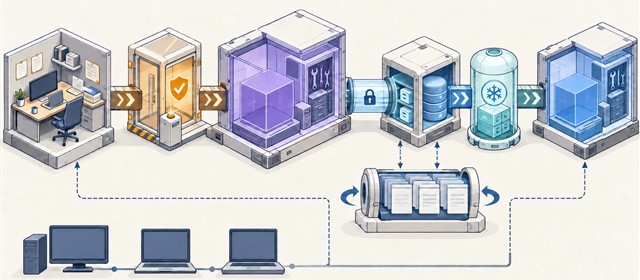
DSX新增组件包括Config Manager、Cluster Readiness Engine、Rack Management Service,以及面向NVIDIA Infrastructure Controller的Cluster API Provider。它们分别负责交换机配置、集群验收、机架操作和裸金属部署,不是一个安装后即可自动接管所有运维的单体平台。
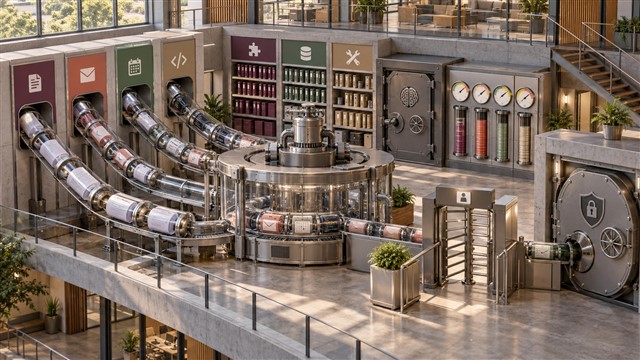
统一交换机配置有助于降低拓扑漂移;机架管理把机柜看成可以管理固件与状态的单元;裸金属部署组件则承接硬件发现和集群建立。企业集成时应先划清各组件的权限、配置来源和故障责任,避免多个控制器互相覆盖状态。
官方将这些能力与DGX Cloud运行经验联系起来,但没有披露可普遍外推的迁移成本、停机降幅或上线时间分布。“小时而非天”的部署描述需要在本地镜像、网络、设施和安全流程条件下验证,不能直接作为项目合同里的保证。
验收能发现坏节点,不等于已经隔离
可检查的Cluster Readiness Engine仓库显示,它是Kubernetes控制器:按拓扑组织节点,运行真实训练与通信工作负载,从日志提取有效产出和带宽,同时记录节点健康状态和失败原因。相比只检查设备能否被识别,这种负载验收更接近真正运行时的压力。
一个重要边界是,验收引擎不会自动给节点打污点、封锁调度或改变节点状态。发现故障之后,隔离动作留给上层平台。企业因此需要另外设计告警、人工判断、节点退出、修复和复验流程,否则“发现了坏节点”仍可能无法阻止下一个作业使用它。
仓库还提供按需WorkloadRun、拓扑感知分组、检查点重启和逐节点结果。它可以成为上架、维修后回归和容量交付的证据生成器,但需要配置正确的测试与日志解析规则。代码公开并不代表任意硬件组合已经通过生产认证。
小编判断:可重复的验收比一次跑通更有价值
AI基础设施交付应保存一个可回放的验收包:硬件与固件清单、网络拓扑、测试版本、负载参数、通过阈值和失败处理。每次升级或维修后重跑同一组检查,团队才能区分硬件退化、软件变化与测试本身的差异。
开放机架设计和开源运维组件为这一流程降低了重复建设成本,但它们不会替企业决定服务目标。训练集群更关心通信、有效训练产出和检查点恢复;推理集群还需看延迟尾部、并发、排队与实际任务完成率,验收模板应该按负载拆分。
同一OCP事件中的USFP光模块仍属于规划中的新形态,开放行业规格和多源生态尚在推进,不能写成客户已经可采购的成熟标准。本轮更明确的交付变化,是公开设计文件与可检查的软件;长期可靠性、费用和运维收益,仍应由具体部署回答。