


 您尚未登录账户
 您的企业账号申请正在审核中


录音能转写,也能追问:NVIDIA新模型先划清离线边界
一段会议录音,用户要的往往不只是逐字稿:谁提出了问题、专业名词有没有写对、某句话出现在第几分钟,都会影响后续使用。NVIDIA于10月28日发布Nemotron 3.5 Transcribe,把转写、翻译、说话人标记和音频问答放进同一个开放权重模型。但这次发布首先要看清一个边界:它处理的是录好的音频,不是实时流式语音服务。
快速看点:模型可结合文字指令处理录音,支持最长一小时音频;不同语言的任务支持并不相同,中文转写不能直接推导为中文音频问答同样可靠。自托管已有部署说明,但长音频接入、时间戳和运行环境仍需要显式配置,不能只下载权重就承诺业务可用。
从固定逐字稿,走向按任务输出
这是一类“音频加文字指令、输出文字”的模型。调用方可以要求保留语气词和重复,也可以请求更便于阅读的文本;还可以提供姓名、术语等上下文,帮助处理业务词汇。对同一份录音,转写、翻译与针对内容提问是不同任务,不应把生成的答案混成原始发言。
模型卡建议,转写和翻译关闭推理,音频理解则使用不同的采样与推理设置。这意味着接入方应按任务保留配置,而不是用一个默认请求覆盖所有用途。对于需要存档的会议材料,原始音频、逐字记录与二次归纳最好分开保存,便于发生争议时回到声音本身核对。
词级时间戳可以把文本连接到录音位置,方便回听与编辑,但不是所有调用自动返回。部署文档明确,它需要相应的CTC适配器并主动启用;当前示例还对模型运行器有专门设置。接入时应验证时间戳字段实际存在、单位正确,再把它用作播放器跳转依据。
例如客服质检团队可以先按时间定位一段争议对话,再由审核人员回听,而不是仅凭摘要作结论。这是可采用的工作流示例,并非本文验证过的客户上线成果;是否减少复核时间、是否漏掉关键语句,仍需用企业自己的标注样本建立基线。
语言支持,不是一张通用通行证
官方公告列出40种转写语言,同时区分与英语互译、多人转写等任务范围。当前模型卡将中文普通话列入转写、与英语互译、多人转写和语码切换支持项,但音频理解、推理及口头指令跟随只在英语上评估,其他语言未必可靠。不能把列表中的一个勾扩展成全部能力都已验证。
说话人标签也只是区分同一录音中的发言者,不是在确认现实身份。“说话人0”不应自动绑定为某位员工或客户。多人重叠、换麦克风、强口音或背景声都值得单独抽检;如果发言归属关系会影响业务决定,就应保留人工确认,而非直接使用标签作身份依据。
上下文词表同样有两面性:正确的专业词可能改善书写,错误提示也可能把输出带偏。模型卡提醒,面对误导上下文的稳健性尚未在所有支持场景充分确立。实施时可以把易混术语和无关干扰词放进验收集,检查系统是否真的听到了那个词,而不是照着提示补写。
一小时录音,不等于默认接口都接得住
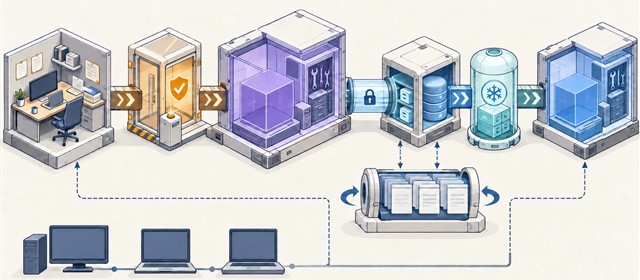
部署指南给出了vLLM与NeMo Speech的接入路径。模型支持的音频长度,与服务入口实际允许的长度不是同一个配置:当前指南中,音频解码时长默认限制为600秒,文件大小默认25MB;处理更长录音需要提高相应环境变量,并检查客户端及网关限制。
编码器内部把特征按30秒分块,不代表模型只能听30秒,也不代表能以30秒或更低延迟实时回复。对企业来说,应分别验收文件上传、音频解码、模型生成和回听定位。任何一段失败,都应保留明确状态,而不是把“请求已接收”记作整份录音已经处理成功。
本轮未采用厂商吞吐、榜单名次或收益数字。公告与当前模型卡在部分量化版本可用性、指标及参数口径上存在差异,不能拼成一个无条件结论;开源接入路径与优化服务的速度也不能混用。本文核对说明与部署材料,未下载权重、执行示例或复跑性能测试。
企业还需单独确认录音授权、访问范围、保存周期,以及模型和相关组件的许可。模型卡标注OpenMDW-1.1,不等于本文已审完全部许可和第三方条件。录音中的口头要求也应作为待处理内容,而非默认获得调用业务工具的权限,避免把转写功能接成未经审核的执行入口。
小编判断
这次更新的价值,在于让一份录音能按任务得到不同产物,并提供可检查的部署入口。真正决定企业能否使用的,仍是语言和任务是否匹配、文本能否回听核对、失败状态是否清楚,以及敏感内容由谁访问。先把录后处理做成可靠流程,比把离线模型包装成实时全能助手更重要。