


 您尚未登录账户
 您的企业账号申请正在审核中


每机架96颗加速器,微软把Maia推向主力推理系统
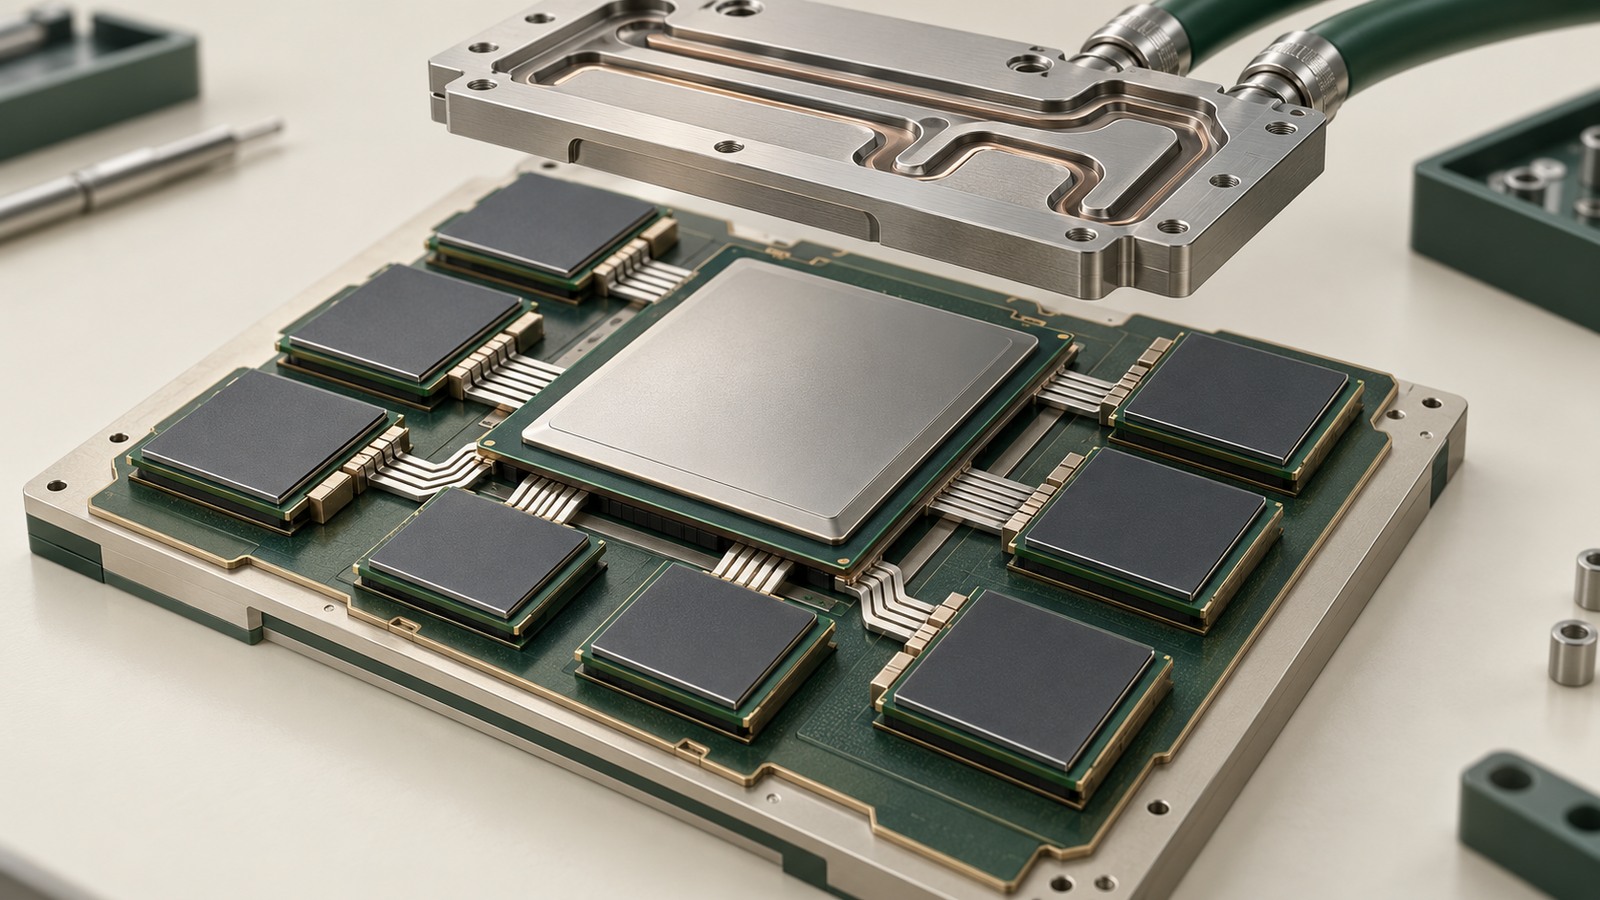
微软计划让自研Maia成为旗下产品和服务的主要推理系统。10月12日公布的路线图显示,Maia 200已经承载Microsoft Copilot等生产负载,Maia 300则将于2027年开始部署。新一代机架把96颗加速器放进167千瓦功率包络,配备27.6TB高带宽内存。芯片竞争的评价单位,正从一颗处理器的算力,转向一整套系统每兆瓦能交付多少有效推理。
已经运行的服务,和明年部署的系统
Maia 200正在支持Microsoft Copilot和MAI团队的模型工作,GitHub Copilot与Microsoft Foundry计划在年底前加入。微软表示,这些负载覆盖OpenAI模型、自研MAI模型与主要开源模型家族。不同模型进入同一硬件系统,使软件适配与持续调优成为架构的一部分。
Maia 300的部署时间是2027年,Maia系列的多吉瓦部署也计划从2027年起扩大。公布路线图并不等于客户已经可以买到或选用下一代硬件。对企业而言,当前可用服务、未来区域容量和产品接入时间仍需分别核实。
微软对Maia 200披露的最高1.7倍每瓦token产出,以及Maia 300相对领先GPU系统预计增加40%每兆瓦token产出,都带有指定工作负载和比较口径。材料没有给出覆盖所有模型、并发与服务级别的独立对照,不能据此直接计算任意业务的节省。
推理瓶颈,常常在搬运数据
Maia 300面向长上下文、内存密集和解码密集的推理任务。系统采用软件定义的数据流与内核优化,尽量让计算接近所需数据,减少跨计算、内存和网络的搬运。它关注的是计算单元在等待什么,而不只是理论上能做多少运算。
每颗加速器配置八个HBM4堆栈,峰值内存带宽18.0TB/s,热设计功耗950瓦。多Chiplet把计算、内存控制与I/O功能拆开,计算Chiplet采用台积电N2P工艺;片上SRAM可作为软件管理的临时存储区,降低对外部高带宽内存的压力。
新系统支持增强的MXFP4等低精度格式,用于减少计算和KV缓存对内存、带宽的占用。低精度并不是无条件的好处:模型转换、数值误差和长上下文质量都需要验证。对业务来说,输出质量过不了验收,吞吐更高也不能替代可用结果。
96颗加速器要作为一个系统工作
Maia 300机架采用96颗加速器、167千瓦功率包络,合计27.6TB HBM和1.7PB/s聚合内存带宽。微软称完整配置最高机架级token吞吐可达Maia 200的七倍;这是不同代际完整系统的比较,不能当成单颗芯片在相同条件下快七倍。
互连以以太网基础设施和定制AI传输支持加速器间的扩展,针对张量并行优化,并把计算、内存和网络的数据流视为整体。模型横跨多颗加速器时,通信等待、拓扑和故障恢复会共同影响最终服务延迟。
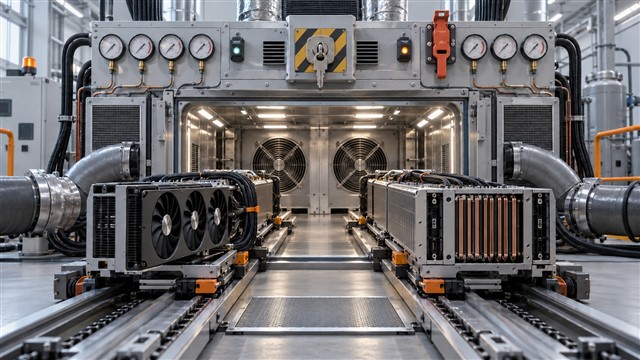
大机架也提出供电、散热与运维条件。167千瓦机架不能只按照传统服务器上架流程处理;容量规划需要结合设施功率、冷却链路、冗余策略与维修窗口。芯片规格展示了上限,但设施能否长期稳定承载,决定了可交付能力。
小编判断:每兆瓦产出还需要服务账本
微软同时掌握应用、模型服务和基础设施,能够把真实交互的瓶颈反馈给硬件设计。这种协同对长期、多步骤Agent尤其有意义:其中既有模型解码,也有工具等待和业务系统调用,优化应该覆盖整条任务,而不是只挑计算最密集的片段。
企业评估下一代平台时,应记录首token延迟、每用户生成速度、并发、任务完成率和每成功任务费用,同时把空闲容量、网络、冷却与迁移工程量纳入总成本。峰值吞吐和每瓦指标适合观察设计方向,不能直接代替生产服务预算。
目前公开材料未给出Maia 300广泛客户部署后的可靠性、区域可用范围、定价或独立复测。2027年生产上线后,真正值得追踪的是同一模型、质量目标与延迟约束下的持续产出,以及软件生态能否让企业平稳迁移。