


 您尚未登录账户
 您的企业账号申请正在审核中


空闲GPU可以借出去,AWS Batch也把收回规则写清了
一个团队的GPU闲着,另一个团队却在排队,能否先借来训练、需要时再还?AWS在10月29日介绍的Batch配额管理,把这种协调写进SageMaker训练作业调度:团队可以保留容量、只借出闲置份额,或同时允许借出和借入。关键代价也很明确——归还是通过抢占完成的,借到容量不等于获得不中断运行的承诺。
快速看点:配额份额是作业队列下的虚拟队列;功能限于连接SAGEMAKER_TRAINING服务环境的队列;跨份额收回与份额内部高优先级抢占不同;被抢占后重新排队,不代表模型训练已经无损续接。
分的是调度份额,不是凭空多出GPU
管理员先配置支持配额管理的调度策略、按实例类型表达容量的服务环境和训练作业队列,再关联团队或项目的配额份额。当前创建文档要求,该服务环境只连接一个相应的配额管理队列;不能把它当作任意Batch队列都能直接打开的通用开关。
每个份额至少有一项容量限制,当前最多五项;一个作业队列最多关联二十个份额。调度器依次检查这些虚拟队列,结合请求实例、份额容量与借用条件决定如何派发。逻辑上划了多少份,不代表实际可用实例或云服务配额会自动增加。
三种策略表达不同取舍。RESERVE把空闲容量留给自己,不借也不借出;LEND允许别人使用自己的闲置份额,但本身不借入;LEND_AND_BORROW两者都允许,还需要设置借用上限。不能把“参与共享”简化成所有团队都能无限透支。
借出的容量需要用时,可以收回来
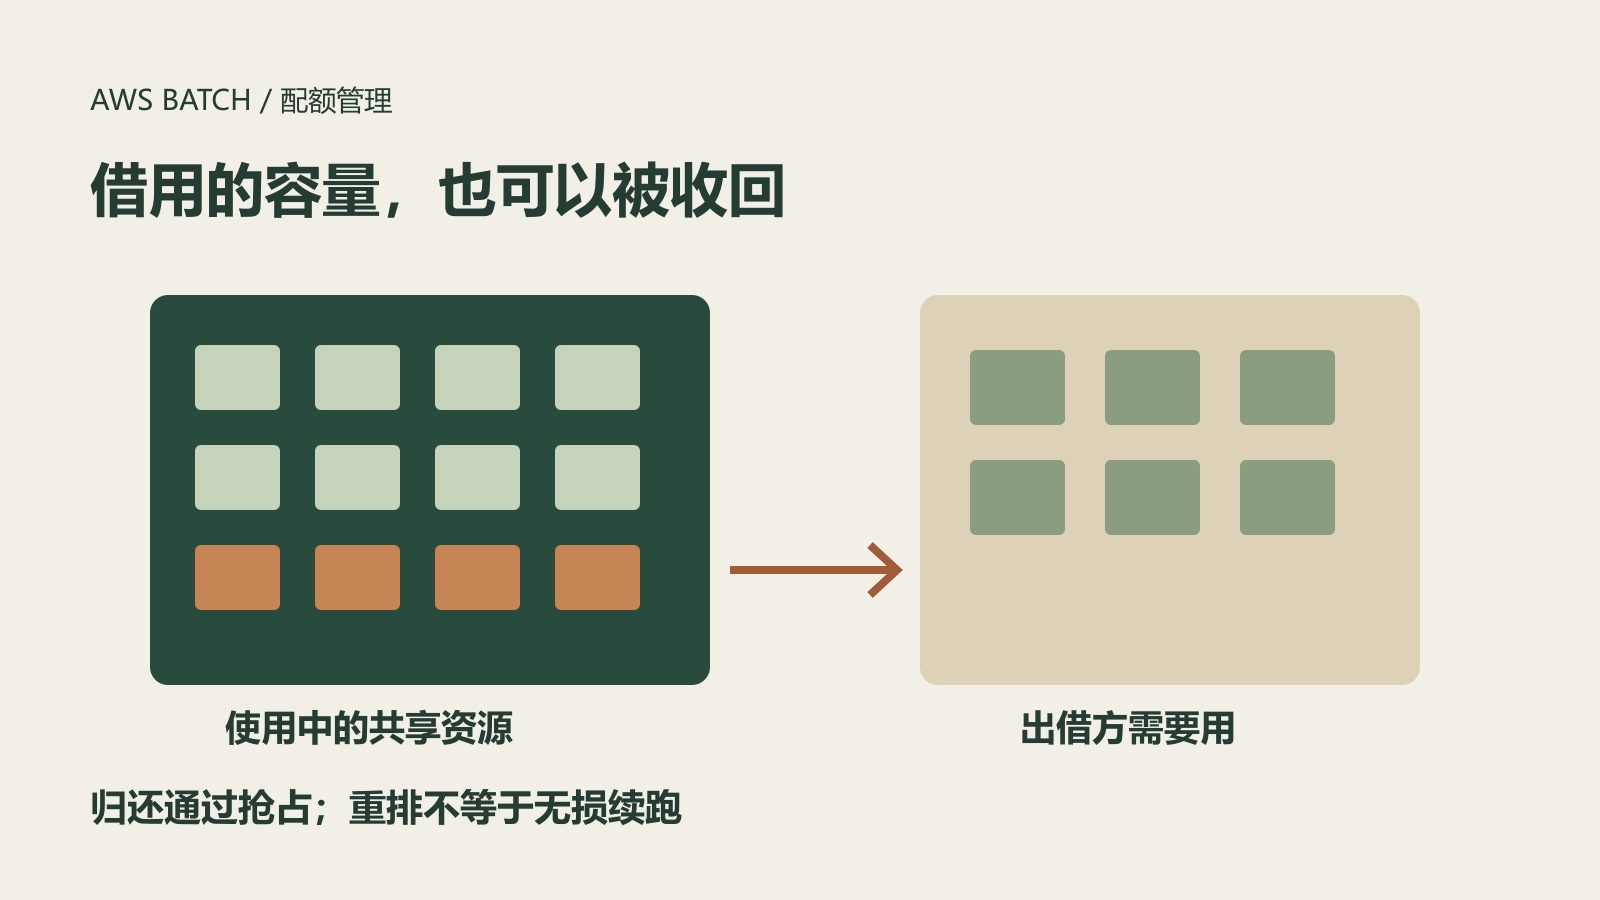
当出借方有新作业需要容量,调度器通过跨份额抢占收回此前借出的部分。官方示例用三个团队分别演示可借入、只借出和保留容量:借用团队先运行额外作业,出借团队随后提交自己的工作,会使借用中的作业退回等待。
这是对调度规则的展示,不是生产利用率实验。配套Python SDK笔记本使用的是Hello World训练器,不包含真实模型收敛或长任务成本比较。它能帮助复核资源关系,不能据此宣布集群利用率提高多少、训练缩短多少,或企业已经节约了多少费用。
同一份额内还可单独开启抢占,让高优先级、可运行的作业打断较低优先级作业。受影响状态包括SCHEDULED、STARTING和RUNNING。作业提交后也能更新调度优先级,但具体挑选哪些作业,仍会综合借用实例数量、类型、相对优先级与运行时长等因素。
重新排队,不等于恢复计算进度
当前文档给出的默认行为是:被抢占的作业重新成为RUNNABLE,重排次数不设上限。若要控制反复抢占,应在提交时配置preemptionRetriesBeforeTermination;设为零,则第一次被抢占就进入FAILED。默认继续排队,并不代表一定在业务截止时间内完成。
因此,调度层与训练程序的恢复责任必须分开。作业回到队列,只能说明系统准备再次调度;模型参数、优化器状态、数据读取位置是否保存并被正确读取,需要训练链路另行验证。对重算代价高的任务,团队应先测试检查点与重复启动行为,再允许借用可被收回的容量。
RESERVE也不是永不被抢占的护身符。管理员降低份额容量上限后,已消耗资源若超过新的限制,即使采用保留或只借出策略,作业也可能进入可被抢占范围。“不借用”与“配置不会改变”是两件事,更不排除实例或应用自身故障。
企业可以把验收分成两组:一组检查容量归还、作业优先级和重排上限是否符合预期;另一组检查训练进度、失败告警、重复输出与最终成本。前者由调度状态证明,后者要靠应用记录和任务结果证明,不能只看队列重新出现一条RUNNABLE就判为恢复成功。
本站本轮核对了产品说明、配额与抢占文档,以及官方示例笔记本的配置和状态等待逻辑;没有创建云资源、提交训练任务或运行该示例。可用实例类型、区域、账户配额与实际收费仍需按部署环境核对,本文不承诺全区域即时容量或零额外成本。
小编判断
共享算力的难点,往往不是借出去,而是怎样可靠地收回来。Batch把借用、保留与抢占做成明确规则,有助于减少人工协调;企业还需为中断成本和恢复路径定价。只有调度公平、训练可恢复、失败可见同时成立,空闲资源共享才不只是把排队问题换成重算问题。