


 您尚未登录账户
 您的企业账号申请正在审核中


同叫2B模型,LFM3的文字、视觉与全模态边界不同
模型能够放到本地,并不意味着每个变体都能接住同样长的输入,或用同一套引擎完整运行。Liquid AI于10月27日介绍LFM3新一代模型家族,将文字、视觉、音频、全模态及结构化决策放在共同骨干上。对企业选型,真正需要逐项比较的不是统一的“2B级”标签,而是具体任务与运行边界。
快速看点:不同模态选择不同变体,而非所有需求都交给一个模型;文字、视觉和全模态的上下文预算不同;公开模型卡与示例代码不等于所有推理框架的稳定版本都已支持,部署前仍需核对版本和功能范围。
一个骨干,不等于一个万能服务
LFM3家族提供六种后训练变体:文字、视觉、音频、全模态,以及两种决策模型,另外还有基础模型。它们共享技术基础,但服务的输入和输出不同。视觉模型看图像或视频后输出文字;全模态模型进一步处理声音,并可输出文字与语音。
这种拆分给实施团队一个更明确的起点:先确认任务需要看、听、说,还是只需要做结构化判断,再选择模型。把每个业务都接到最复杂的变体,可能增加不必要的组件;只因一个小模型能看图,就要求它同时承担复杂编程和长期推理,也可能选错对象。
以工单分流为例,系统需要的可能是几个受限选项,而非一段自由回答;看设备照片并回答问题,则更接近视觉任务。这是选型方法上的区分,不是说未经领域测试的模型已经能够替代生产人员,更不是把结构化输出视为业务判断天然正确。
256K、128K与32K,不能混成同一规格
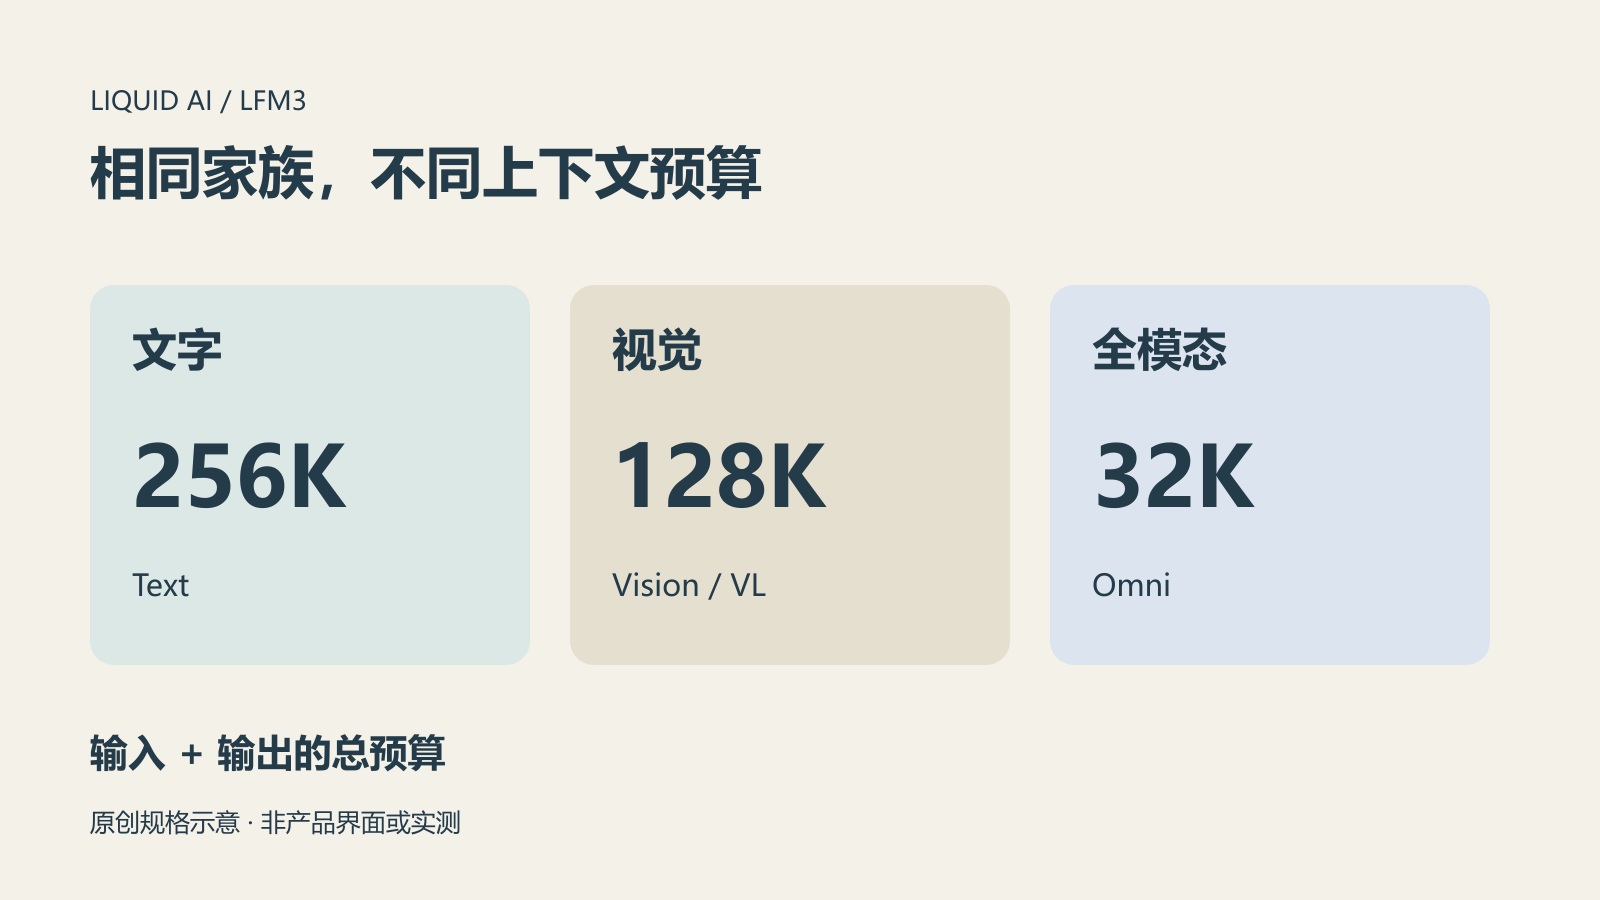
三个主要模型卡列出了不同的上下文总预算:LFM3-1.7B文字模型为256K,LFM3-VL-2B视觉模型为128K,LFM3-Omni-2B全模态模型为32K,均包含输入与输出。不能把文字版本的长上下文指标直接贴给整个家族。
这些预算差异会影响材料切分、历史保留和生成长度。把同一份长会话直接从文字模型切换到全模态版本,不能假定输入仍然放得下。图片与视频也会占用模型处理序列,应用需要按实际预处理方式计算,而不是只数用户打了多少汉字。
视觉与全模态模型卡还说明视频按每秒两帧采样。这有助于界定它看到的时间信息:取样视频并不等于逐帧追踪所有瞬间。若任务涉及快速动作、短暂状态或安全判断,应单独检查采样有没有漏掉关键事件,不能仅因支持视频就推导为实时控制能力。
思考模式同样有区别。视觉版本包含逐步推理行为,而全模态版本标为非推理模型,不支持通过开关开启相同模式。模型卡也列出各自不推荐的任务。部署时保留这些负面条件,往往比再引用一个总榜名次更能减少错误承诺。
示例能写出来,稳定引擎未必已经跟上
公开材料提供了Transformers调用示例和多种运行路线,但当前视觉模型卡明确:llama.cpp支持仍在代码审查,且相关路径暂不含视频输入;SGLang支持在审查中,vLLM支持仍在推进。这与“安装任意最新稳定引擎即可完整使用全部模态”不是一回事。
对已有服务,升级清单因此不应只有权重名称。还要记录精确的引擎版本、量化格式、处理器、聊天模板和所需模态,并用真实样本检查输入、工具调用与返回格式。能成功加载模型,和端到端任务正确,仍是两个不同验收阶段。
权重以LFM Open License v1.0标识,而非直接标为Apache或MIT。本轮未完成许可全文的逐条核读,因此不作具体商用权利承诺,也不提供法律结论。模型开放权重与企业特定用途是否满足条款,需要分别判断,不能用“开源”两个字一笔带过。
本地运行也不自动等于全链路不出网。应用若继续调用远程工具、日志服务或数据连接器,相关访问仍需单独治理。可以把专用小模型放在链路中的合适位置,但权限、人工审批和异常处理不会因为参数变少而自行消失。
本文没有采用厂商速度、排行榜和机器人成功率作为生产收益,也未运行模型、下载完整权重或执行示例。官方提供单卡微调方向,不代表每个数据集、上下文与显存配置都能照搬。企业应先建立自己的固定评测集,再讨论迁移、质量和成本是否真的改善。
小编判断
LFM3的意义,是把小模型选型从“能不能聊天”推进到“该让哪种模型处理哪类输入”。共同骨干方便形成产品家族,清楚的差异才方便交付。先验证模态、预算、运行时和业务错误,再讨论端侧规模化,比追求一个覆盖所有任务的标签更实用。