


 您尚未登录账户
 您的企业账号申请正在审核中


MCP断连先问谁负责,微软Agent框架划清恢复边界
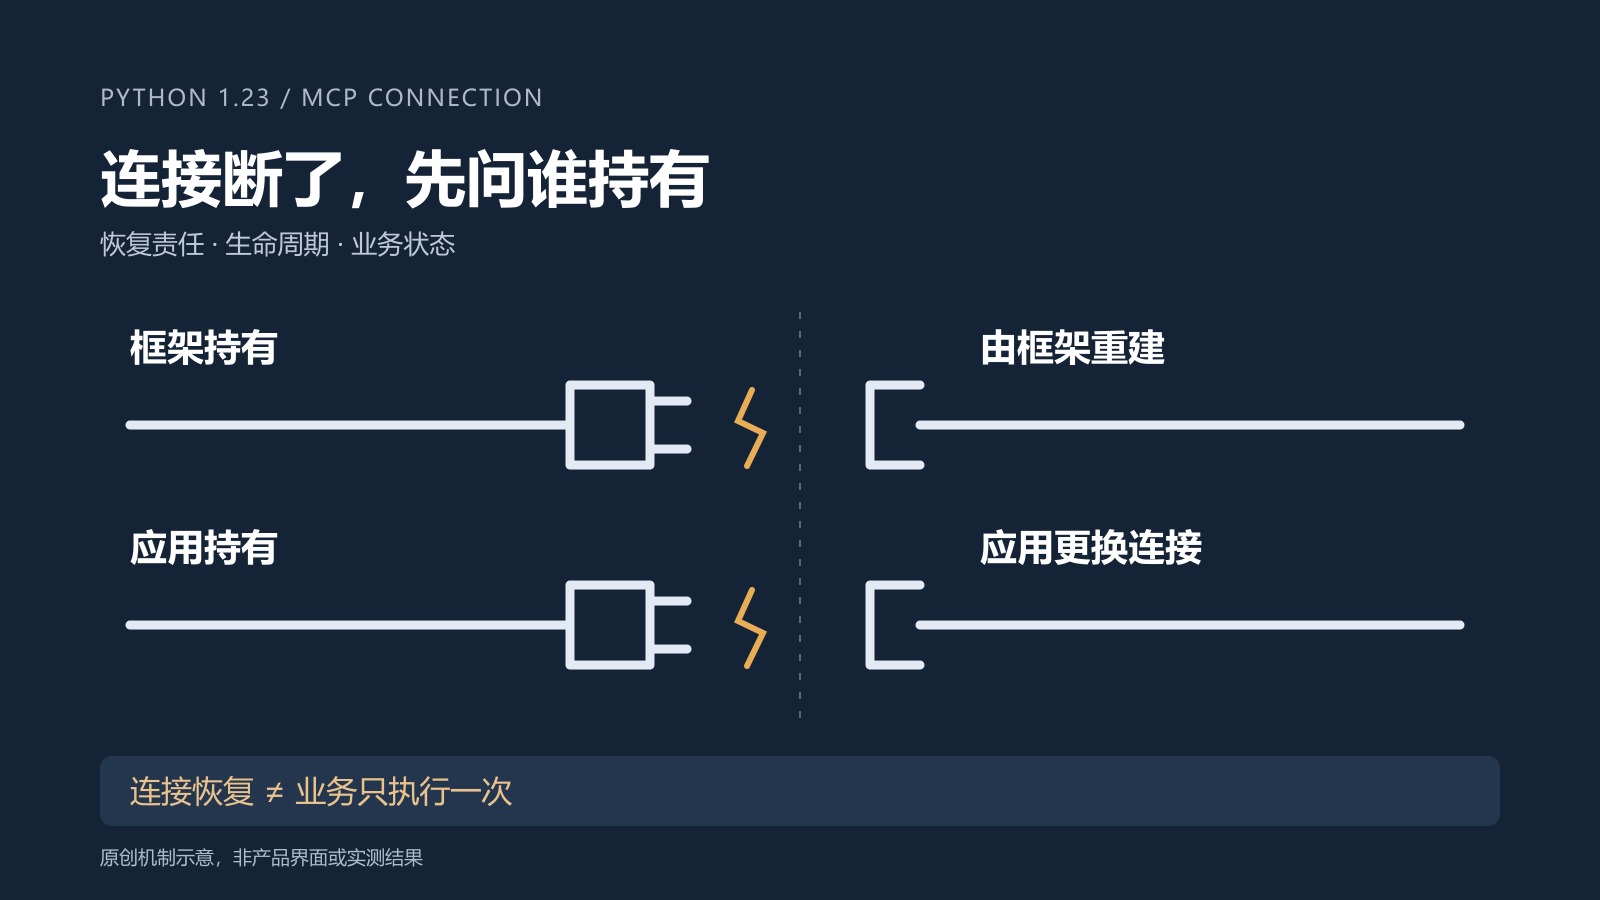
Agent工具断了连接,日志却显示“正在重连”,随后又对已经结束的旧对象发起请求——这样的恢复可能只是换一种方式失败。微软10月22日发布的Agent Framework Python 1.23,把MCP连接由谁创建、由谁更换的边界落到代码中。重点不是凡事多试一次,而是先分清框架有没有权力重建这个连接。
快速看点:框架创建的连接保留既有恢复路径;应用传入的连接在明确断开后,报错提示应用提供替代连接;工作流示例把共享连接保持到整个流程结束。这里说的是Python 1.23,不是.NET 1.26,也不是跨进程恢复或业务幂等的一揽子保证。
重连之前,先看连接属于谁
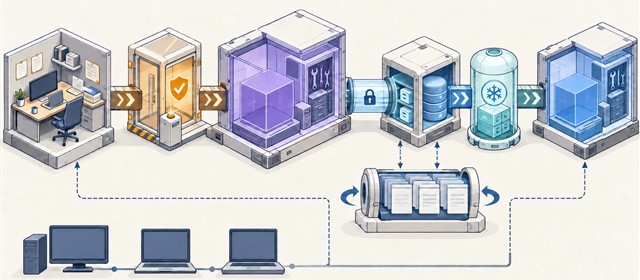
框架与应用可能采用两种接入方式:一种由框架根据地址或命令创建客户端,另一种由应用把已经进入使用状态的客户端交给工具包装层。两者表面都能调用同一个服务,资源责任却不同。谁掌握创建与配置,谁才能在需要时重新构造相应对象。
此次修复针对的旧行为,是外部传入连接已经结束时,恢复路径仍可能尝试重置并向原对象再次发送RPC。新代码在恢复前检查所有权:若连接由调用方持有,则返回可操作的错误,要求创建替代连接与MCP工具实例;框架持有的连接继续使用原有恢复机制。
这不是把所有失败都改成禁止重试。代码区分可以确认的连接结束与其他错误,服务繁忙或一般异常不能随意解释成必须更换连接。对交付人员,监控也应把“调用失败”“连接失效”“正在建立替代连接”分开,否则一条笼统的恢复日志会掩盖真实的处置责任。
共享客户端,要活到整个工作流结束
配套示例让研究Agent查询Microsoft Learn,再由写作Agent整理答案。应用先创建并进入高层MCP Client,把它传给工具包装层,等顺序工作流运行完毕后再退出相应作用域。示例展示的是生命周期组织方式,不是一个具名企业已经取得效率提升的生产案例。
这一模式提醒团队:流程中的一次工具调用结束,不一定意味着共享连接也应关闭。反过来,流程已经退出,也不能假定某个后台步骤还可以继续使用它。连接的作用域应跟业务执行范围对齐,尤其是多个步骤共用客户端时,要明确谁负责最终清理和异常退出。
构造方式也更明确。传入mcp_client时,再混入由框架持有的传输配置,会被拒绝,而不是悄悄忽略部分参数。旧的低层ClientSession仍作为弃用兼容路径保留,不能写成此次已经全部删除。迁移时应检查实际调用方式,而不是只把包版本改成一个更大的数字。
回归测试验证边界,不证明生产成功率
版本标签中的测试覆盖工具发现、存活检查、工具调用和提示调用等场景。对于外部持有连接发生明确关闭,相关模拟测试检查操作只调用一次、重连方法未被调用;另有模糊存活检查错误的测试。这些是可检查的代码约束,本文未运行该项目完整测试套件,也没有做真实生产故障注入。
发布说明同时列出MCP 2.x兼容基础、传输与生命周期迁移等不兼容变化。因此不能把单项修复“没有新增公开API”扩展成整个版本可无风险原位升级。团队应先固定依赖组合,在测试环境检查客户端构造、认证配置、取消清理与连接更换,再安排上线范围。
对会修改业务记录的工具,还要单独回答:连接断开前,服务端是否已经完成操作?恢复传输并不能替企业回答这个问题。更换连接后是否再次提交,应依据业务状态与去重机制决定,而不是把异常自动理解成“上一次没有执行”。这是实施建议,不是框架新增的事务承诺。
小编判断:可靠恢复首先要能交代责任
这次更新值得关注,因为企业Agent常常跨越应用、框架、协议SDK和外部服务多个边界。增加重试次数容易,说明哪一层能重新建立什么资源、哪一层必须停止并交还错误,更接近可运维系统的需要。清楚失败,有时比看起来一直在恢复更有价值。
验收可以从两个受控场景开始:框架持有连接断开时,是否按预期处理;应用持有连接断开时,是否留下足够信息让应用更换,而不是对旧对象反复调用。随后再检查业务状态、告警和人工介入。只有把连接恢复与任务恢复分别验收,才不会把一项正确的底层修复,误读成所有长任务都能安全自动续跑。