


 您尚未登录账户
 您的企业账号申请正在审核中


英伟达训练故障恢复默认只观察,重新排队不等于续训
大模型训练凌晨卡住,重新排队只是第一步:算力是否重新分配、脚本有没有读到有效检查点、模型是否继续训练,需要三份不同的证据。英伟达11月2日介绍的NVIDIA Recovery,把异常判断和调度动作拆开,公开部署默认先观察,不直接改作业。对训练平台团队而言,这项仍处实验阶段的工具,最值得关注的不是“自动”二字,而是它怎样限制一次错误判断的影响范围。
快速看点:当前调度集成针对Slurm;观察模式能记录建议但不修改调度状态;重新排队、从检查点续训和最终完成必须分别验收。
先判断作业怎么停,再决定要不要重跑
在多节点训练中,一个进程崩溃可能让其他进程持续等待;通信故障也可能表现为吞吐下降而不是立刻退出。如果平台只根据退出码重跑,故障节点可能被再次分配;如果只看GPU是否繁忙,又容易把正常的阶段切换错认成卡住。Recovery将应用日志、进度与调度信号放在一起判断,关注崩溃、挂起以及持续拖慢整体进度的执行。
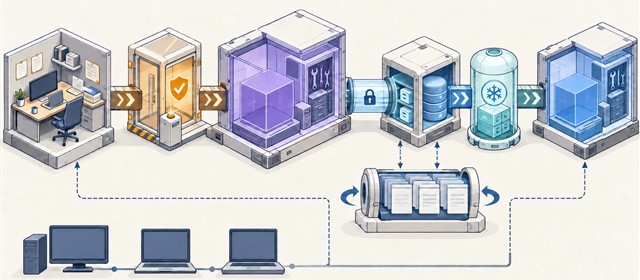
它把恢复划分为检测、归因、隔离以及重启或停止。检测到异常后,系统结合当时的作业证据生成建议;更深入的NVIDIA Attribution是可选组件,不是使用Recovery的先决条件。对于牵涉特定节点的故障,重排建议可排除相关节点;如果反复尝试仍没有新的检查点,策略也可以停止重试。这里的节点排除服务于后续调度,并不等于硬件已经维修完毕。
控制面给出期望结果,Slurm侧控制器将它转成合格的调度动作,并检查实际状态。平台可以在集群内接入,也可以采用面向Slurm的远程连接方式。即使服务本身运行在Kubernetes环境,也不能据此推断它已经支持直接恢复Kubernetes训练作业;本次介绍将后者列为后续方向。
默认只观察,授权也不等于立刻执行
公开Helm配置默认观察,调度写操作确认默认关闭。单个作业可以通过提交注释声明恢复策略,但申请执行不会越过部署层的确认开关。反过来,管理员打开确认,也不是要求所有作业立刻重启:有效作业模式、环境路由和适用分区等条件还要一起满足。运维需要查看实际生效的配置,而不能只凭示例文件的默认值判断。
看门狗也是独立的写路径。它负责在符合条件的作业长时间被挂起时释放调度约束,避免恢复控制面异常让作业无限等待;开启控制器动作并不会自动批准看门狗动作。运维文档给出的顺序,是先观察普通任务,再用独立分区中的可丢弃作业验证控制器,最后单独审查并授权看门狗。空分区白名单也不是全拒绝,而是没有按分区额外限缩。
英伟达披露,IBM Research在其Slurm环境先对照人工决策,再开启自动动作。这能说明观察到执行的实施路径,不代表所有集群已经验证同等效果。评估时应保留异常原始信号和人工判断,分开记录错误建议、未被发现的故障以及动作实际生效的结果,而不是把建议数量当成挽回的训练时间。
同一个调度编号,不是同一次执行
Slurm重新排队后可以沿用作业编号,但执行次数会递增。Recovery为各次执行分别保留记录,把建议绑定到发生故障的那一次。举例来说,第一次尝试失败后的建议,可以用来约束它的直接后继怎样重新启动;如果后继本身再次失败,则需要针对这次执行的新判断。仅凭相同作业编号回放旧动作,可能误伤已经换过节点的新进程。
日志同样要能归属到具体尝试。产品文档默认要求各次尝试使用不同日志路径;若主动复用路径,文件名就不能区分旧记录和新记录,还需要可信的尝试标签或源时间。采集系统若用入库时间覆盖源时间,延迟到达的错误可能很难归属。这是接入时需要检查的观测契约,不是部署恢复服务就能自动补齐的能力。
真正能否续训,还取决于训练脚本有没有把检查点写入能跨失败存活的存储,重启时能不能正确加载。Recovery记录进展证据,但不替脚本生成模型状态,也不承诺业务结果只产生一次。调度侧释放作业只代表它有资格再次运行,仍可能等资源;应用加载完成后还要确认步数继续推进,最后才谈训练结果是否产出。
小编判断
这次值得借鉴的是把恢复权拆成三道验收:判断正确、调度动作受限、应用进度真正回来。平台团队可以先选一类能稳定保存检查点的训练,在隔离分区复盘建议,再决定哪些故障允许自动处理、哪些仍交给值班工程师。当前材料不足以外推节省时间、利用率或投资回报,公开仓库入口也未能独立读通;因此更适合把它看成可评估的实验性恢复机制,而不是无人值守承诺。