


 您尚未登录账户
 您的企业账号申请正在审核中


OpenAI重做Git后端:分支独立写,对象包重复用
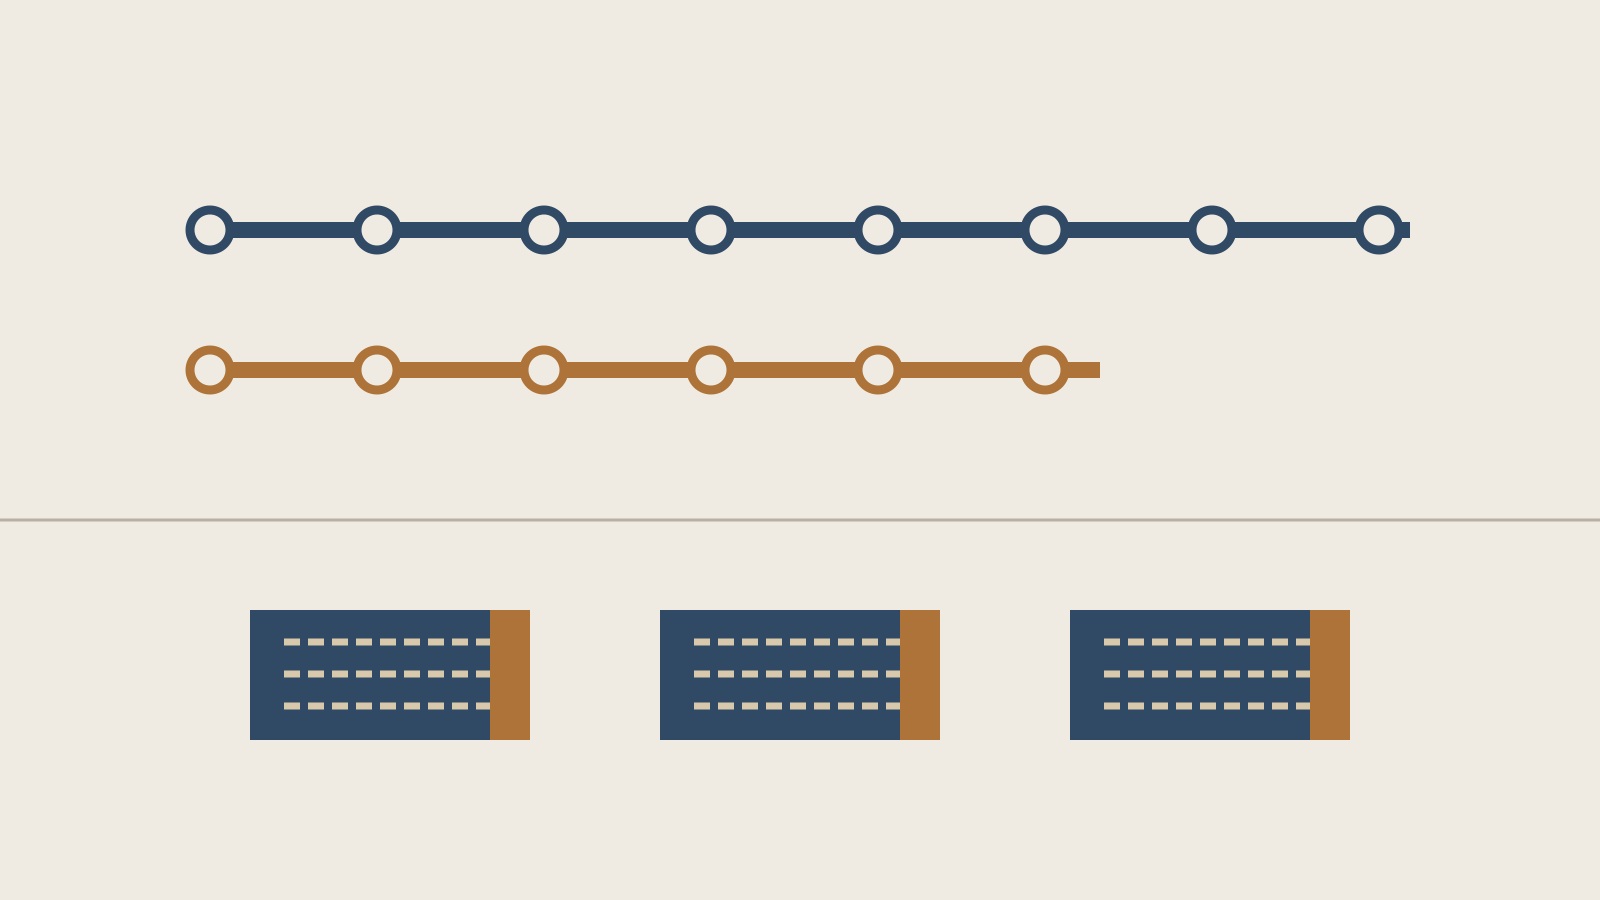
当几十个智能体同时在一个仓库改代码,最先吃紧的未必是模型:每个分支都要提交,每次提交又可能触发多份持续集成任务下载相同历史。OpenAI在11月2日的工程复盘中披露,内部单体仓库已由兼容Git的后端Pando支撑。它把互不相关的分支写入分开,再让读者复用已经打包的历史。值得注意的是,这两项优化都改变了系统的取舍,并不是为原来的Git服务器加一层缓存就能得到同样结果。
快速看点:不同分支可以并发推进;相同对象包可被多个客户端下载;公开的是部分Git客户端改动,不是Pando后端。
写入并行以后,不再承诺跨分支同一时刻
在Git中,提交对象描述历史,分支引用指向历史中的某个位置。想象两个开发智能体分别修复搜索和支付模块:只要更新的是不同分支,两次推送就没有必要为了移动各自的指针而排成一列。但如果它们都在改同一个分支,服务端仍须判断各自基于哪个旧版本,不能把“不同分支并行”误解成取消同一分支上的冲突检查。
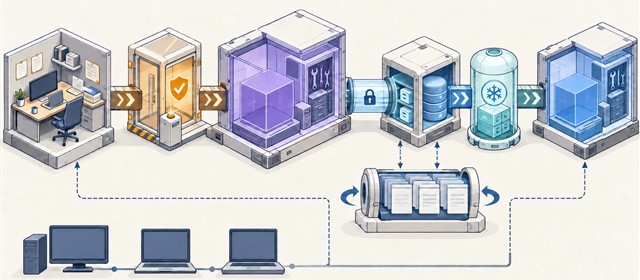
Pando先接收并验证对象包,再通过元数据事务记录引用版本、更新引用指针。分支之间不需要全仓统一排序,读取多个分支时也就可能看到不同时间点的状态。对于单分支的普通拉取,这与一个系统是否能返回所需历史是两回事;但对依赖多个分支共同发布的流水线,却意味着验收时不能把一组分支名当成天然一致的快照。
这里可以借用一条不依赖Pando的工程做法:若一次验证涉及多个代码输入,就记录明确的提交标识及依赖关系,并让构建和回滚基于这些输入复现。这样即使分支继续前进,团队仍能说明发布时用了哪组版本。后端写得更快,并不会替团队定义哪个组合才应该交付。
读取复用对象包,也允许下载一些已有对象
传统的按请求打包,倾向于只发送该客户端缺少的对象。客户端各自已有的历史不同,服务端就可能反复计算相近的包。Pando换了一个目标:让更多请求共享已经存储的对象包。代价是客户端可能下载部分自己已有的内容;回报是服务端无需为每个读者重新压缩,同一份包可以由区域缓存提供。
Git协议支持在双方协商了相关能力时返回对象包地址,由客户端另行下载,再做连通性检查。Pando的读路径利用这种分离:一侧判断需要哪些包,另一侧交付实际字节。一个用于举例的场景是,同一提交启动多个CI任务,各任务需要读取相同历史,此时复用比给每个任务单独生成一个稍小的包更有吸引力。
但如果同一提交几乎没有第二个读者、下载链路很贵,或热包不断被挤出缓存,取舍就可能反过来。评估时不能只看缓存命中率,还应分开观察首次可用的等待、实际传输量、客户端下载与索引开销。热包命中也不能替代对象可达性验证,缓存层的运行健康和仓库历史完整性是两个问题。
先迁移流量,再判断要不要复制架构
这不是只展示原型的案例。复盘描述,团队最初以读写代理接入旧系统,再分批把工具流量迁到新后端。对企业而言,这个过程比照搬存储选型更值得关注:先摸清流量来自人、构建任务还是智能体,再验证旧客户端能否走新路径,并为失败保留可辨认的回退点。否则,即使新系统单项吞吐更高,也很难解释上线后哪一环先出现偏差。
目前公开可检查的是OpenAI的Git客户端分支和补丁跟踪,而不是可安装的Pando服务端。原文还区分了已经贡献上游的改动与公开分支里的改动,不能把后者全部当作普通Git版本的现成功能。公开Git协议描述的是协商与传输方式,也不会保证另一个托管平台实现相同缓存、分支一致性或迁移策略。
内部运行规模与延迟变化没有被写成通用采购指标:外部团队缺少同仓库、同地区、同客户端分布的对照条件。即使原文中的读写压力来自智能体,也不能把后端优化直接解释成模型写代码更准确。能比较的是代码交付系统怎样承受更多并行工作,不是智能体本身能完成多少业务。
小编判断
Pando揭示了一个容易被忽略的顺序:先决定哪些写入必须相互协调,再决定哪些读取可以共享,最后才选缓存和存储实现。准备扩大智能体开发的团队,可以先追踪同一提交被取回多少次,区分分支争用与对象打包开销,再用固定版本验证跨仓库交付。无需等待Pando开放,就能用这些测量判断瓶颈究竟在模型、Git协商,还是CI反复搬运同一段历史。