


 您尚未登录账户
 您的企业账号申请正在审核中


能跑Python却不能直查库,Snowflake代码沙箱转GA
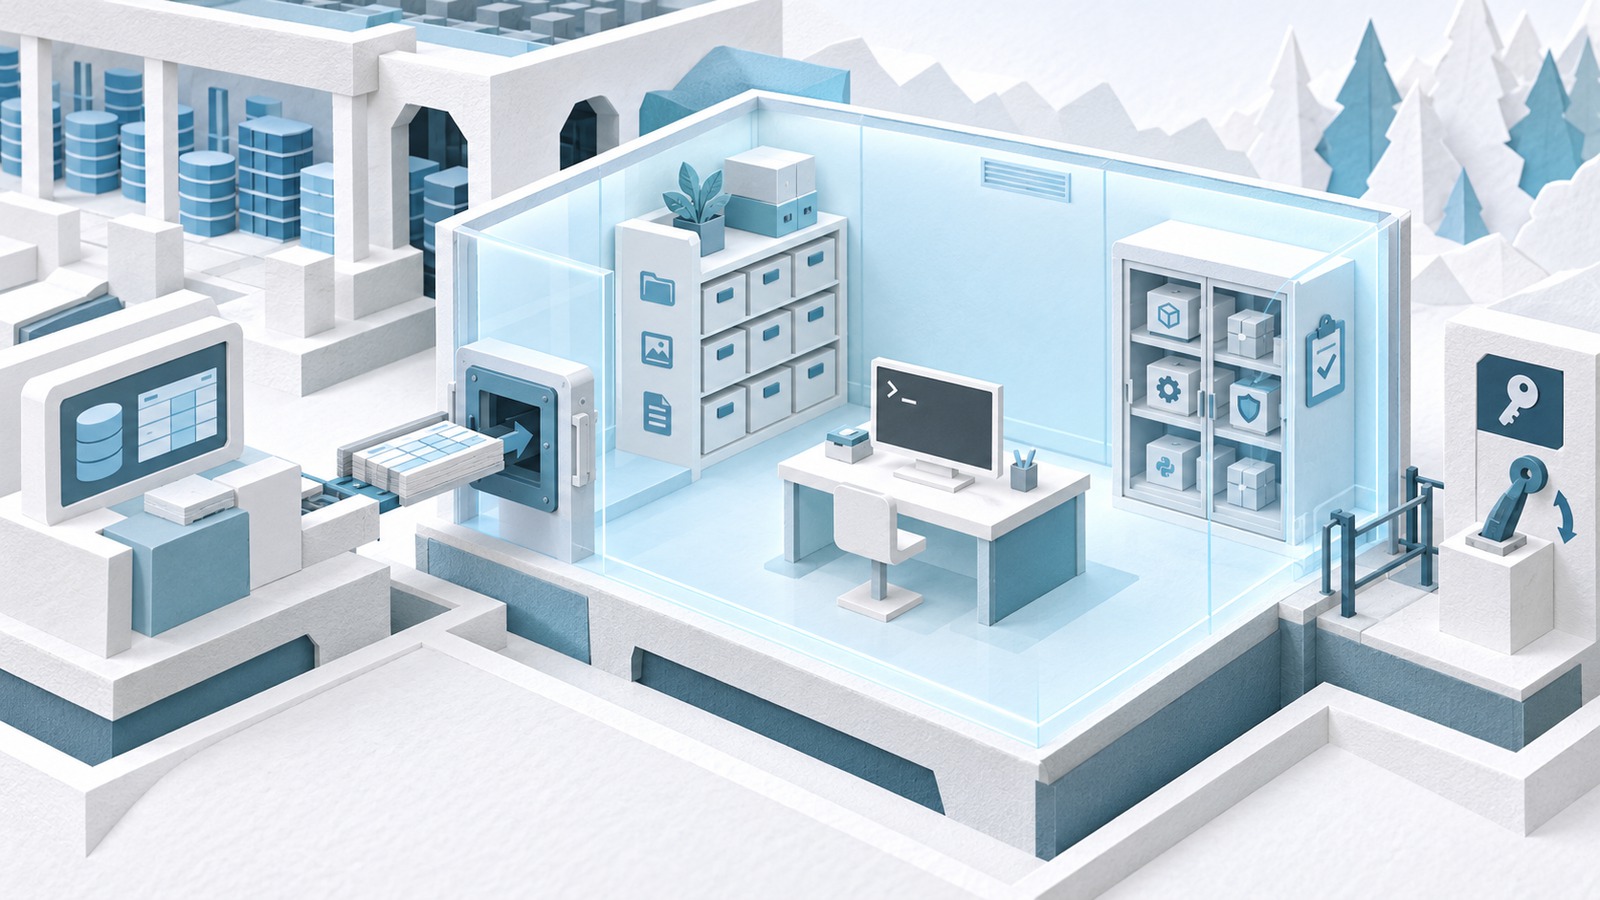
让Agent生成一段Python并不难,难的是让这段代码在企业数据旁边运行,又不把权限、软件包和结果文件变成新的盲区。Snowflake在10月5日把Cortex Agent代码执行工具推进到正式可用。它允许Agent在隔离沙箱中完成数据加工、计算和可视化,也能运行Agent Skill携带的Python脚本;但官方同时划出一条容易被忽略的红线:沙箱不能直接查询Snowflake数据,SQL必须先在外部执行,再把结果交给代码工具。
GA解决的是执行入口,不是无限数据权限
代码工具预装Python 3.12,以及numpy、pandas、scipy、pyarrow、matplotlib和plotly。Agent可以据此清洗查询结果、做统计、生成图表或处理工作区文件。对原本需要把数据复制到外部Notebook、函数服务或临时容器的团队,这减少了运行环境切换,也让执行过程留在Snowflake管理的Agent链路里。
但“靠近数据”不能写成“自动拥有数据”。官方流程要求Agent通过SQL工具在沙箱外执行查询,再把结果传给Python;沙箱本身不能直接访问Snowflake表。部署时应把SQL权限、返回行数、敏感字段脱敏和传入沙箱的数据体积分别设限。否则,代码隔离做得再完整,也挡不住上游查询一次性送入过多数据。
文件能留下,内存不会跟着下一次执行
沙箱按对话线程隔离,挂载的workspace stage为文件提供持久化,因此中间表、图表和文档可以跨步骤保留。另一面是,不同代码执行之间的内存状态不会保存。依赖上一次变量、缓存或进程的工作流,必须把必要状态写进文件,或在每次执行中显式重建;这会直接影响长任务的恢复设计和成本估算。
额外Python包可通过Artifact Repository安装,但管理员授予相应仓库用户角色后,访问范围可能扩展到PyPI包。企业不能把“能安装”当作供应链白名单,应固定版本、审查许可证与维护状态、扫描依赖,并记录哪个Agent、哪个版本在何时拉取了什么包。持久文件也要配置保留期、敏感结果清理和下载权限,避免临时产物变成长期数据副本。
两套工具配置,把审批和调用者身份推到前台
团队可以选择只提供Python的code_execution,或使用覆盖代码、SQL、文件和其他能力的code_toolset_all,两者不能在同一个Agent规格中同时配置。工具越全,测试面越大:文件写入、Shell命令、网络检索和SQL不应共享一个笼统的“允许”开关,而要逐项定义可读、可写、可外发和需审批的范围。
权限模型还有一条硬约束:owner’s-rights调用不支持代码执行,需要使用caller’s-rights,让操作按实际调用者身份检查。对可能修改状态的工具,默认审批策略是always_ask;改为always_allow虽然减少等待,却会把误操作和提示注入风险一起放大。生产环境还应记录审批人、工具参数、输入数据摘要、输出文件与失败原因,而不是只留一条“执行成功”。
小编判断:先拿失败剧本验收,再扩大自治范围
这次GA的重要性,在于Snowflake把Python执行变成Agent平台里的正式能力,并把数据查询、代码运行、文件存储和审批拆成可讨论的边界。它能减少外接执行器,但不能替代数据治理,也没有证明任何业务流程已经因为这项能力获得更高准确率或更低TCO。
试点时应准备一组故障剧本:SQL返回超量数据、代码超时或耗尽资源、包版本被替换、workspace残留敏感文件、审批等待后参数变化、线程恢复后内存丢失,以及调用者权限在任务中途被收回。逐次记录完成率、人工介入、重跑次数、文件清理、延迟和单位任务成本。只有这些指标稳定,代码沙箱才从一个方便的工具,变成可交付、可审计、可恢复的企业执行层。