


 您尚未登录账户
 您的企业账号申请正在审核中


740M参数统一四种媒体,Gemma端侧检索也会静默失败
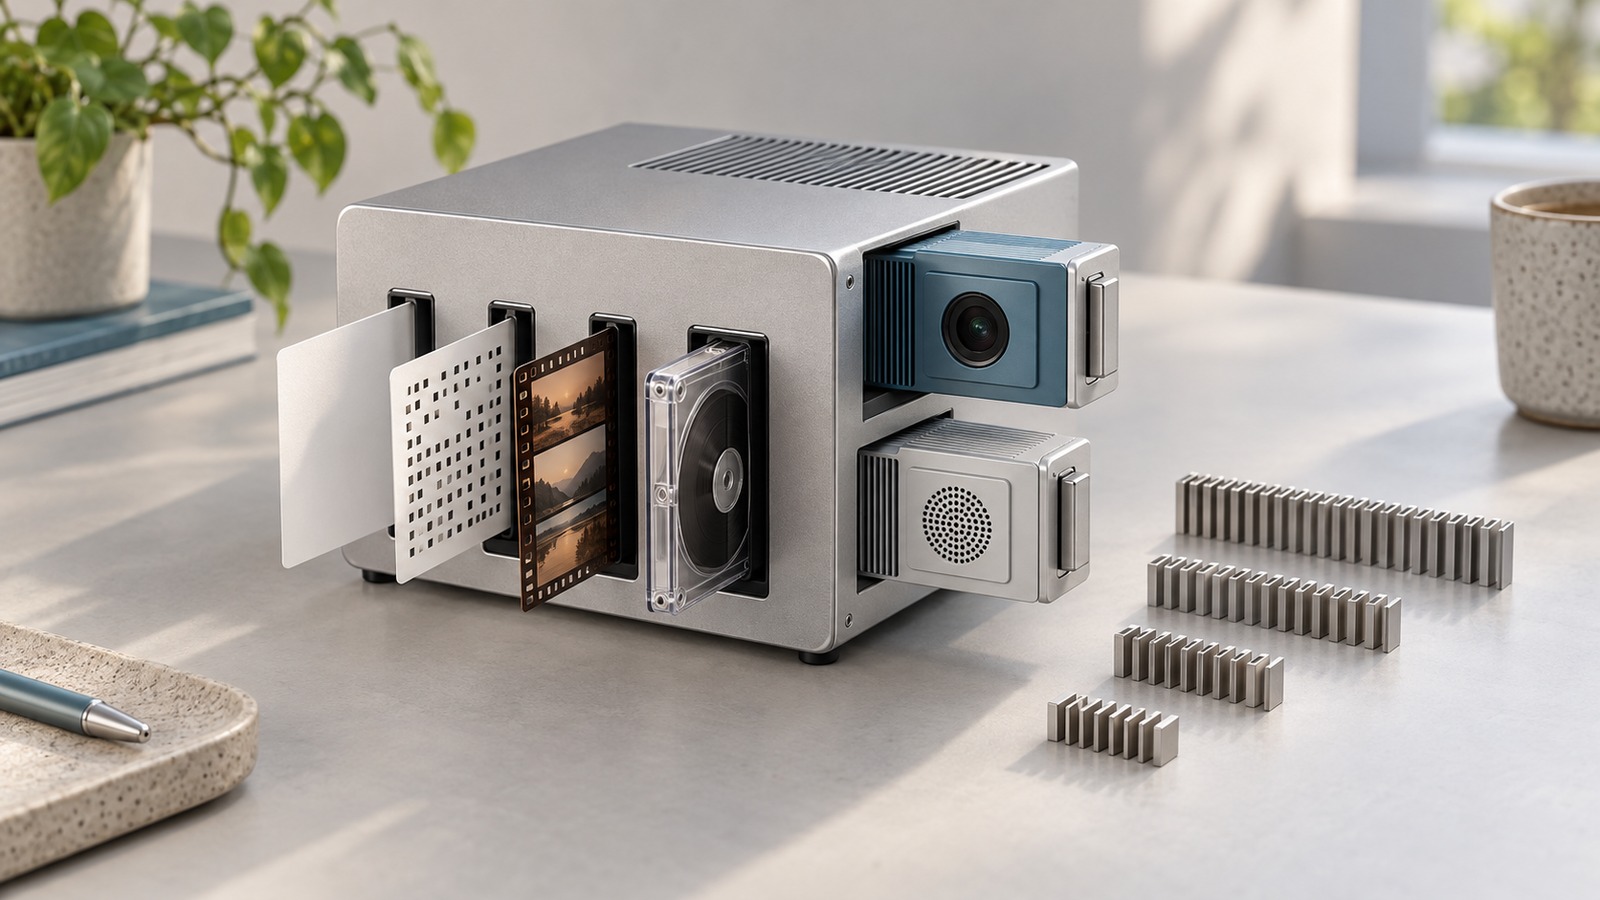
手机里的本地检索通常要先做OCR、图像描述或语音转写,再把结果送进文本向量模型。Google在10月6日发布EmbeddingGemma 2,尝试用一个740M参数模型把文本、代码、图像、视频和音频直接映射到统一的768维空间。权重、模型卡与推理指南已按Apache 2.0开放,但真正落地时,比“能放进设备”更重要的是精度、数值格式和向量维度是否被正确管理。
一个向量空间接住五类企业资料
EmbeddingGemma 2的文本部分为270M参数,视觉编码器170M、音频编码器300M,总计740M。只做文本或代码检索时可以卸载另外两部分;需要图像、视频或音频时再加载对应编码器。对于离线知识库、现场设备手册、媒体资产搜索和代码库检索,这种模块化设计能减少多段模型链路,也降低把原始媒体上传云端的必要性。
模型共享8192 token上下文。默认预算下,官方给出的单模态上限约为29张图片、58帧视频或327秒音频;混合输入会共同消耗这份上下文,不能把三个上限同时相加。文本检索还需要使用与任务对应的instruction prefix,查询与文档必须保持相同向量维度。省略前缀不会报错,却可能让召回精度悄悄下降。
存储最多缩六倍,代价并不均匀
模型使用Matryoshka训练,768维向量可以截为512、256或128维。官方表中,256维的多项指标仍接近完整维度,适合在召回质量、索引内存和搜索速度之间做折中;128维则更适合文本任务。以MMEB多模态总分为例,768维为59.01,128维降到45.65,不能把“最多六倍压缩”理解成近乎无损。
截断后还必须重新做L2归一化,否则相似度排序会在不报错的情况下变差。查询与语料维度也要严格一致。生产团队应把维度、归一化方式、模型版本和任务前缀写进索引元数据,迁移时做双写或重建;如果只替换查询端配置,系统可能返回看似合理却不可比较的分数。
191MB只是特定设备下的最低口径
Google称量化后在Pixel 11 Pro上,文本模式最低约需191MB active RAM,完整多模态模型约需567MB。这是特定设备、实现和量化配置的结果,不代表所有手机、浏览器或边缘盒子的峰值内存。企业还要计入分词、媒体预处理、向量缓存、索引和生成模型占用,并测量冷启动、持续负载和热降频。
更容易被忽视的是数值格式。模型卡明确建议bfloat16或float32,不要使用float16,因为激活范围可能溢出,产生NaN或表面正常但质量下降的向量。上线前应对向量有限值、范数分布、重复输入稳定性和跨后端一致性做自动检查,而不是只看服务是否返回200。
官方评测显示多语言文本MTEB为61.36、代码MTEB为78.68,后者比上一代提高9.92分;图像、视频和音频则使用多套不同基准。数字主要来自Google自测,且不同模态指标不能横向拼成一个“综合领先”结论。企业应按自己的语种、文档类型、召回目标和敏感数据重新建立真值集。
小编判断:端侧RAG先从可测的窄任务开始
EmbeddingGemma 2真正吸引人的地方,是把多模态检索压进同一套可下载权重与设备端管道,运行路径覆盖Transformers、Sentence Transformers、MLX、vLLM、llama.cpp、SGLang、Ollama、LiteRT、MediaPipe与WebGPU。但“兼容”不等于每种后端具有同样的精度、内存和延迟。
更稳妥的落地顺序,是先选择一个可复算的窄任务,例如离线代码搜索、设备手册图文检索或本地音频片段定位;固定前缀、维度和数值格式,分别测召回率、误召回、峰值内存、耗时与索引成本,再决定是否合并模态。只要把静默失败写进验收门槛,这个小模型才可能从演示里的统一空间,变成设备上的可靠入口。