


 您尚未登录账户
 您的企业账号申请正在审核中


升级前先停写,MLflow 3.17把权限做细却拒绝滚动迁移
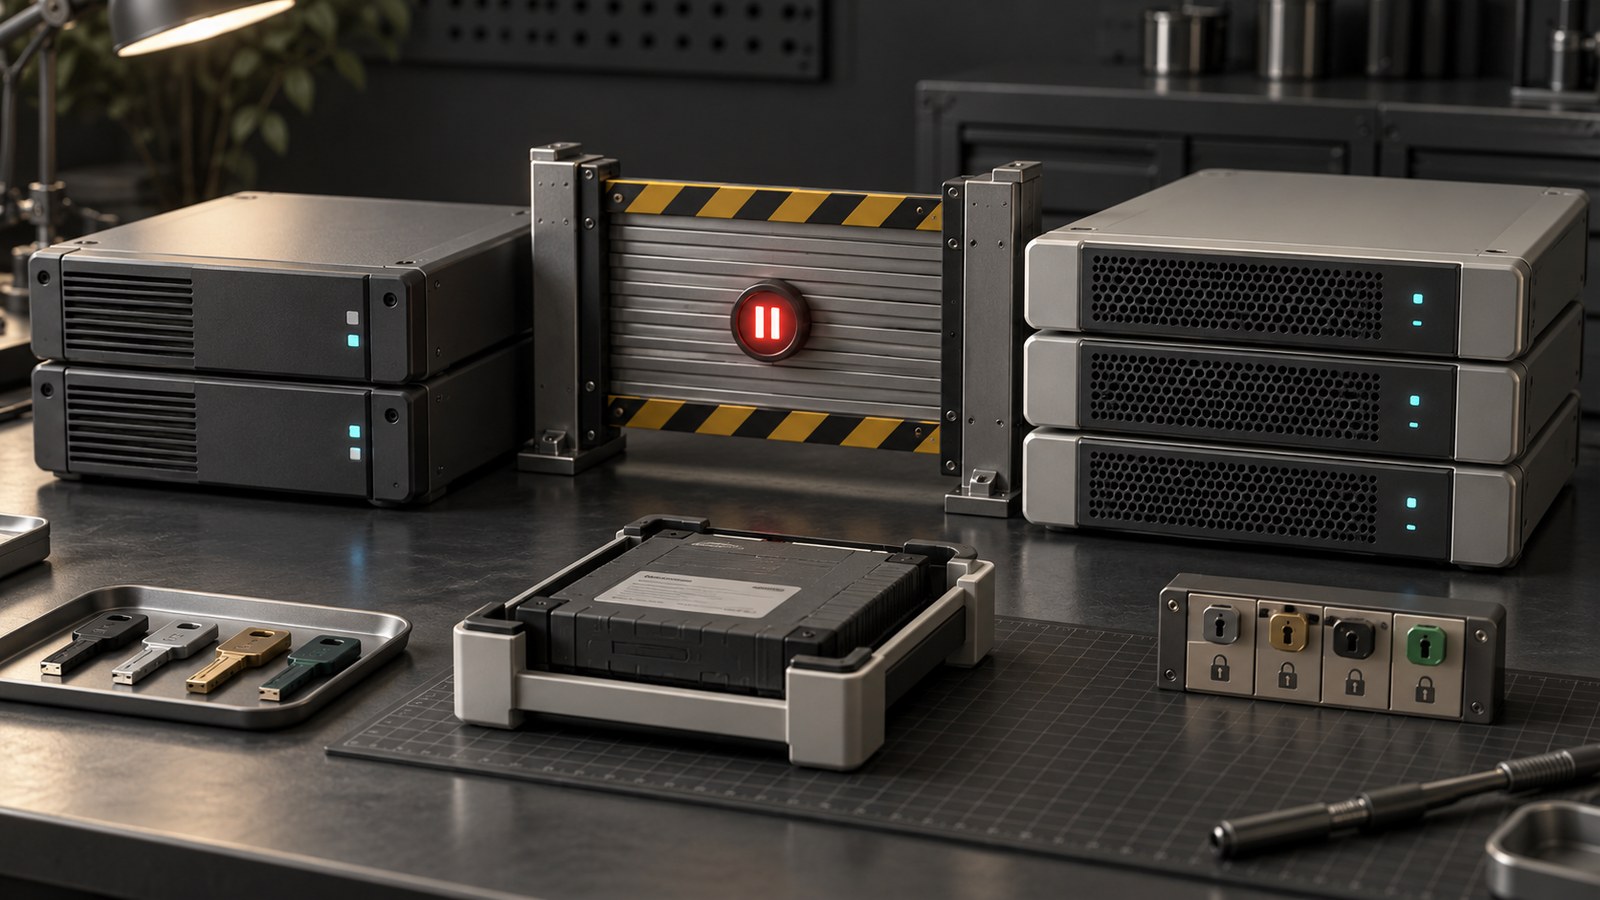
很多AI平台升级看起来只是替换一个镜像,真正危险的却是新旧服务同时写同一套数据库。MLflow 3.17.0在10月7日正式发布,新增类型化评测反馈、共享资源细粒度权限、Trace日汇总和共享服务器会话隔离;但官方同时给出一条很硬的迁移边界:SQL后端必须协调停写并执行schema升级,不支持新旧版本混合滚动。
评测反馈从自由文本走向可计算的类型
3.17.0把TypeSafe模型接入内置scorer、自定义judge、AI Gateway和Tracing,评测结果可以直接返回布尔值或分类值。相比让评审模型输出一段解释再由脚本解析,类型化反馈更适合做过滤、趋势、门禁和自动化回归,也能减少拼写差异把同一结论拆成多类的问题。
这不等于评测本身自动可靠。团队仍要固定类别定义、边界样例和拒答规则,保存judge版本、模型与数据集,并抽样核对解释是否支持分类。类型只解决输出结构,不解决评审标准漂移、提示注入、模型偏差或人工真值不足。
权限下沉到Trace,DENY开始有明确优先级
共享MLflow服务器常同时承载多个团队的实验、模型、Trace和版本。新版本把权限细化到run、trace、version等子资源,允许通配授权,也允许显式DENY。相比只在工作区或实验层开关访问,这种粒度更接近生产审计需求:用户可以看到某类聚合结果,却不一定能读取包含敏感提示词的原始Trace。
共享服务器里的Assistant对话也按登录用户隔离,账户切换会重置活动会话,减少浏览器或工作站换人后串线。企业上线前仍需验证继承关系、通配范围、DENY冲突、服务账号和导出接口,特别是搜索、链接分享和批量API是否遵守同一权限判断。
Trace日汇总降低查询压力,但没有公开加速比例
大规模Trace数据可选择生成按日汇总,并在需要细节时回退到原始查询,目的是减少SQL分析开销。聚合的模型评测指标还能关联到实际产生结果的托管数据集,让团队从趋势图回到数据版本,避免一条“分数下降”告警找不到对应输入集合。
Release Notes没有给出查询加速幅度、额外存储量、刷新延迟或最大数据规模,因此不能把“faster analytics”改写成确定性能收益。平台团队应以自己的Trace量级测量写入放大、汇总完成时间、原始回退延迟和失败后的重建成本,再决定是否默认开启。
小编判断:迁移窗口比新功能更值得先排期
生产团队升级时需要停止所有写入方,准备经过恢复验证的备份,运行数据库升级命令,再让全部副本以3.17.0统一启动。即使没有启用Trace日汇总,也不能省略schema升级;官方明确不支持混合版本滚动升级。这意味着常见的“先换一台、观察后再扩”路径在这里不成立。
最稳妥的做法,是先在数据库副本上演练升级与回滚,盘点Tracking、Registry、Gateway、评测任务和外部写入脚本,统一设置停写闸门;升级后再验证权限、Trace查询、模型版本和数据集关联。若无法提供完整停机窗口,应先评估双环境切换,而不是让新旧服务冒险共享写库。
演练还应覆盖任务队列和长连接:停写前确认后台评测、批量导入与异步日志已经排空,切换后逐项恢复,而不是一次打开全部流量。备份要真正执行过恢复,并记录schema版本、迁移时长和回退点;只有这样,维护窗口才能从经验估计变成可审核的运行手册。
MLflow 3.17.0让评测、权限和Trace分析更适合多团队生产环境,也用一条清晰的迁移限制提醒平台负责人:治理能力越深入数据层,升级就越不是简单替换容器。先把停写、备份、恢复和一致性做成可重复流程,新功能才真正有资格进入生产。