


 您尚未登录账户
 您的企业账号申请正在审核中


11项服务跨10类GPU,NVIDIA给集群配置加上证据链
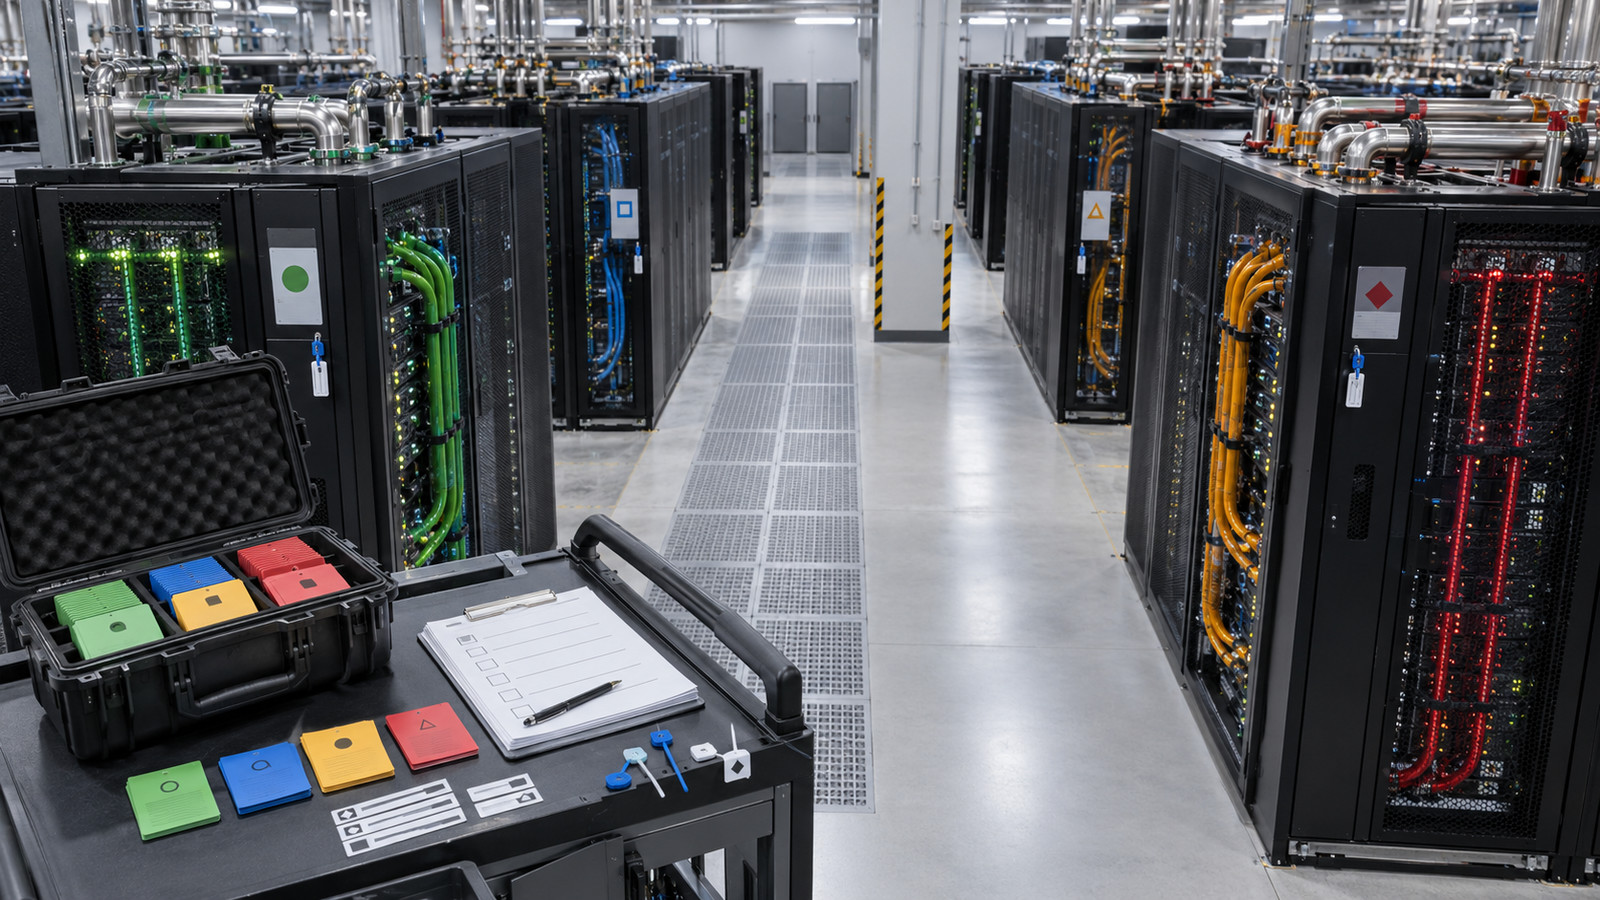
GPU集群最难维护的,往往不是“装上软件”,而是半年后还能回答:当时装了哪些版本、为什么兼容、离线环境用的是哪批依赖、故障后能否复现。NVIDIA发布AICR v1.0,试图把这些散落在脚本、Wiki和工程师记忆里的信息,变成带版本、校验和签名的配置证据。首版覆盖11项Kubernetes服务与10类GPU加速器,但它并不会替企业建集群或替代现有运维平台。
从“配置能跑”走向“配置有证据”
AICR把问题拆成四层。Snapshot读取现有集群的软件与硬件状态;Recipe声明经过约束的兼容组合;Bundle把镜像、Chart和依赖收进可搬运的离线包;Validation则在部署后生成检查结果。四者连起来,企业可以把一次成功安装留下的状态,转成下一次上线、迁移和审计都能复用的工件。
v1兼容性契约覆盖命令行、REST API、Go SDK、Bundle目录布局和工件schema。对平台团队来说,这比单纯新增几个安装脚本更重要:流水线可以固定接口,Recipe可以进入代码评审,Bundle能够随变更单归档,验证结果也能进入审计记录。兼容性承诺保证的是接口和结构,不代表未来每套Recipe在所有硬件上都得到完全相同的运行结果。
覆盖面很宽,真正部署仍交给原有工具
官方列出的首版范围包括11项Kubernetes服务、10类GPU加速器,以及Rubin、Blackwell、Hopper、Ampere和Ada多代架构。操作系统覆盖Ubuntu、Container-Optimized OS与Oracle Linux,并提供Talos mixin。上层既有Kubeflow、Slurm训练组合,也有Dynamo与NIM推理组合。
但AICR不接管执行层。Helm、Helmfile、Argo CD和Flux仍负责部署,AICR负责定义哪些版本应该一起出现、依赖如何收集、结果怎样验证。这种分工降低了替换现有平台的门槛,也意味着团队仍需自己处理基础设施创建、容量规划、升级编排、回滚、故障恢复和业务工作负载。
签名、SBOM齐全,验证证据仍有适用条件
v1.0以Apache-2.0许可证发布,提供Linux与macOS的amd64、arm64二进制,并附带校验和、SBOM、Sigstore attestations以及Recipe Catalog签名。企业可以核对下载内容、供应链元数据和目录来源,不必只相信网页上的版本说明。
项目社区已有100多名贡献者,官方称接近一半来自NVIDIA之外。开放协作扩大了硬件与软件组合,但也带来一个必须写进验收表的事实:并非每个Recipe都拥有NVIDIA自有硬件上生成的完整验证证据,贡献者也可以提交NVIDIA未持有硬件的结果。采用者要核对证据来自哪里、测试用了什么设备,并在自己的驱动、网络、存储和安全策略下复测。
小编判断:先把一次成功部署变成可复现资产
AICR最现实的落点不是“一键建成AI工厂”,而是选一套已经稳定运行的训练或推理集群做基线:先生成Snapshot,再用Recipe锁定版本,用Bundle验证断网交付,最后把Validation结果接入变更审批。随后故意替换一个驱动、Chart或镜像,观察流水线能否识别漂移并阻止错误组合进入生产。
官方没有给出具名客户的部署周期、失败率、回滚时间、性能、成本或ROI,因此“配置可验证”不能直接写成“集群更快、更便宜”。真正值得跟踪的是升级准备时间、环境差异导致的失败次数、离线交付缺件率、验证覆盖率和恢复耗时。若这些指标持续下降,AICR才从漂亮的开源目录变成企业可复用的交付能力。