


 您尚未登录账户
 您的企业账号申请正在审核中


NVIDIA公开集群调查框架,Agent能查不等于能修
集群训练任务挂了,值班员往往要在调度器、设备和日志之间切换,才能判断是作业问题还是基础设施问题。11月4日,NVIDIA披露其内部AI工厂运维框架,并公布实验性代码。最值得借鉴的是访问边界:智能体能经专门工具查询集群,但会话里的通用命令不直接拿集群凭据。
快速看点:按故障领域分工;会话沙箱和集群查询走不同通道;代码公开不等于预构建部署包可直接下载。
一条故障线索,要跨过多层系统
生产现场的同一项异常常在多个层面留下痕迹。作业退出可能伴随调度状态变化,也可能碰巧出现在网络错误或硬件告警之后。这个框架把排查分到不同领域的智能体,各自收集证据,再把根因线索和建议带回调查,而不是让一个代理仅凭最后一条错误日志给出结论。
NVIDIA列举了内部使用的角色:训练作业恢复助手看调度、应用和基础设施,硬件助手查看设备故障,观测助手查询历史指标和日志,知识助手查阅运维资料,Kubernetes助手则负责只读查看工作负载与节点。角色名单描述的是厂商内部部署,不是说每个专用助手都随公开仓库一起交付。
举例说,两个训练任务在同一批节点上失败,团队可以先让工具找出共同节点,再按时间窗口对照设备告警和作业事件。即使几项信号相邻,也应把“同时发生”和“确定因果”分开记录。证据缺失时把问题交给值班员,要比自动触发重启更合适。
把通用命令和集群查询分开
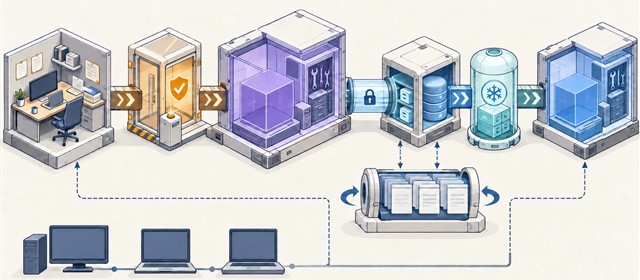
框架以Kubernetes上的控制面应用运行。对于通用命令,OpenShell按会话提供沙箱;对于Kubernetes查询,另有服务端工具使用已配置的只读凭据。厂商给出的例子中,这一路允许读Pod和ConfigMap,但拒绝读取Secret或创建、更新Pod。决定边界的是实际服务账户和角色权限,不能靠提示词里写一句“只读”。
公开说明还区分了观测、Slurm及集群管理模块。不同模块通过各自的服务端工具使用明确配置的凭据,浏览器与MCP客户端不会直接得到集群凭据。这不是对所有外接工具的统一授权;换一套日志系统或连接器时,仍要核对真实身份、能读的对象和返回给模型的数据。
合理的试点可以把调查和修复列为两个独立工作单:前者需要能够定位证据并留下审计记录,后者则由业务权限控制,保留人工批准和回退路径。还可在测试环境用一个未授权对象验证拒绝结果,确认工具报错不会被上层转写成调查成功。
公开的是实验框架,不是内部部署的完整复制品
NVIDIA称内部框架在DGX H100、B200和GB300生产集群上运行,使用本地模型。项目README同时将公开版本标为实验性,当前发布的Helm Chart和容器镜像需要获邀访问私有NGC仓库,普通登录不等于获准拉取。厂商专用运维智能体也有单独的访问渠道。
这个案例能说明运维团队如何划分调查权限,但不能用来承诺根因准确率、事故响应时间或训练利用率。文档给出的配置与示例也不是对读者现有环境的安全审计。若接入,先确认可获得的组件版本,再用脱敏的历史故障样本检查取证、解释和人工接管是否符合本地流程。
验收时不妨把同一批事件交给两组人员复核:一组核对工具取回的证据,另一组判断建议是否在权限和运维规范内。这样可以分清是证据不足、推理过度,还是接入时给了过宽的读权限。只有这三类问题能分别定位,才适合逐步扩大覆盖。
还有一个容易混淆的边界:既有训练恢复工具可以在自己的授权下动作,这次披露的调查代理提供建议,两者不是同一个权限主体。即使部署在同一企业,也应检查每条变更记录能否追溯到批准人、执行身份和实际结果。
试点还应记录智能体没有拿到证据的情形,例如日志超出留存期,或者某一数据源因权限不足不可访问。缺失本身就是调查结果的一部分,不能用一个貌似完整的根因摘要盖过去。
小编判断
这套框架的参考价值不在于让Agent替代值班员,而在于让它参与找证据,却不默认取得变更权。先把工具权限和人工复核做成可检查的约束,再讨论接更多数据或提高自动化比例;调查建议、生产改动和实际恢复,始终是三个不同结果。