


 您尚未登录账户
 您的企业账号申请正在审核中


Ai2推出StateBench:读得完长文,为什么还会跟丢状态?
一份长文档里,甲把物件交给乙,乙又把包里的东西换给丙。模型能找到每句话,不代表它知道物件最后在谁手里。Ai2于11月3日介绍了StateBench,专门用来区分这两种能力。它不是再问一次模型能读多长,而是问:当值被反复覆盖、引用或交换后,模型能否还原最终状态?
快速看点:四档题目尽量控制变量、取值和更新位置,改变更新规则;通用模型和专项训练的结果分开报告;最长实验序列的单位是赋值操作,不是词元。
把“找到最后一条”与“算出最终值”分开
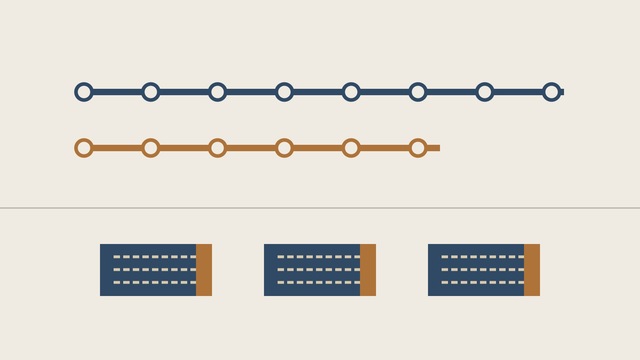
最容易的一档,只需找到每个变量的首次赋值;允许覆盖之后,重点变成找到最后一次更新。再往上,某个值可以由它自己的旧值推导,最后一条语句不再提供完整答案。最高一档加入更一般的变量依赖,例如交换两项的值,漏掉一次交换就可能弄错后续多项结果。这些区别在短例子里看起来细小,拉长以后却改变了模型需要做的工作。
评测不是为四种难度各找一批毫不相关的题。研究者从同一条一般赋值序列构造更简单的版本,让变量和不同取值的数量、赋值出现的位置保持一致,主要调整赋值的类型。这样,当两个样例一样长但结果差异很大时,更有理由检查更新规则,而不是先归咎于文档长度。
用业务流程打个比方:如果每次发货通知都直接写出新负责人,找最新一条通常就够了;如果通知只说把现有两单的负责人互换,就必须知道互换前的归属。它们可以使用同样数量的订单和通知,却不是同一种检索任务。这个例子说明评测的思路,并不是论文声称已在发货系统中验证。
专项训练能改善部分任务,最难一档仍有边界
研究者分别比较了公开预训练模型、四款前沿模型,以及从头进行专项训练的小模型。公开预训练模型在简单任务上大多表现良好,但在更长的依赖序列上丢分;同一底层题换成表格编辑等形式时,有些小模型的表现也发生明显变化。前沿模型并非每档都差,明显下滑集中在部分更复杂、输入又更长的题目。
专项训练使用约2.75亿参数的模型,训练序列最多256次赋值,测试最长6.4万次。部分混合架构和Gated DeltaNet变体在前三档长序列上表现稳定;但不能把最长测试长度当成最高难度的可靠上限。最难一档中表现较好的Gated DeltaNet变体,大约在训练最长序列十倍的范围内保持接近满分。这是特定实验中观察到的结果,不是任意模型都能把任务长度扩展十倍。
这样的对照有两个用途:一是提醒团队,不要仅凭参数量或上下文窗口挑选状态跟踪工具;二是把“模型没有通过通用训练学到”与“在作者测试的架构及训练条件下仍难学会”分开。也不能从少数架构变体推出所有注意力模型都有同样上限,或推断某一种架构已经解决真实场景的长期记忆。
企业可以照着出题,但不能拿分数当上线许可
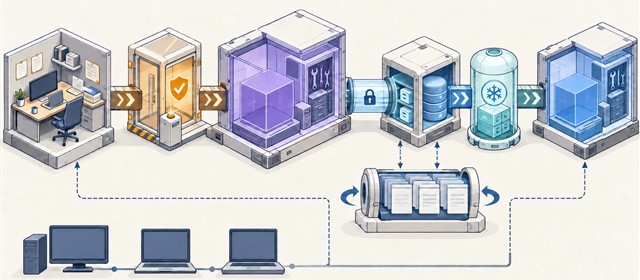
如果一条流程需要追踪工单归属、审批顺序或多次修改后的合同条款,可以从同一份脱敏轨迹出发,先做一版只取最后更新的测试,再加入基于旧值的变更、跨对象移交和撤销。除了最终答案,还可按步骤比对系统记录,看看错误来自没检索到更新、漏算了依赖,还是取到了已经失效的状态。
这里有一条清楚的边界:StateBench固定变量数量,现实却会在运行中新增客户、工单、权限和例外。实验也不等于测试连接器掉线、写入权限、并发冲突或审计可恢复性。基准任务上的准确率不能换算为生产完成率,也不能替代业务系统对状态的持久记录。
更实用的分工是:把权威归属和变更顺序留在业务系统,让模型读取并解释所需状态。需要写回时,用业务系统检查版本和授权,再记录实际结果。如此一来,评测暴露的漏步风险会对应到可定位的控制点,而不是只得到一个难以复查的总分。
小编判断
StateBench最值得借用的是出题方法:固定文本负担,只改变需要追踪的关系。团队由此可以判断,究竟该改善检索、增加确定性的状态计算,还是重新设计流程。上下文能装下多少历史,与系统能不能交代当前状态,是两个应该分开验收的问题。