


 您尚未登录账户
 您的企业账号申请正在审核中


Snowflake预览无服务器微调,GPU何时开始计费
微调开源权重模型时,工程团队常在两件事之间来回切换:编写训练逻辑,以及维护运行这套逻辑的GPU。Snowflake的Cortex Training把两者拆开,客户保留训练脚本和批次准备,平台托管GPU计算。10月30日版本说明列出公开预览,11月3日产品博客进一步公布这项服务;它还不是正式可用版本。
快速看点:训练脚本仍在客户工作区运行;受支持的模型和集成并不无限;排队和已占用GPU的初始化不是同一种计费状态。
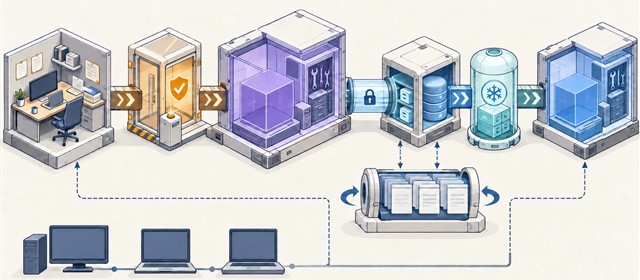
CPU侧保留流程控制,GPU侧接手计算
工作区可以是开发者机器,也可以是不带GPU的虚拟机。训练脚本在那里准备数据和批次,并通过接口把前向、反向计算、优化器更新和生成等操作发到托管侧。模型权重与优化器状态由平台持有,客户端收到的是损失等所需结果,不必在本地重新建一套训练集群。
这并不是把任意训练代码原样搬进Snowflake。低层接口适合自己编排训练步骤,框架集成则把一部分GPU操作转到同一后端;不同框架的集成进度不一致。文档中列出的模型是经过筛选的集合,同一型号是否支持推理、低秩适配或全参数训练也要分别查,不能从“支持开放权重”推出任意仓库都能直接导入。
预览文档写明覆盖AWS商业区域并要求启用。部署前还要确认目标账户、角色和区域,检查数据读入与模型产物的访问路径。客户端负责批次并通过接口提交,所以“平台托管GPU”不能简写成所有输入都会留在原表中,也不等于数据访问责任已经交给服务商。
一份作业里,训练和采样可以分开
平台把训练与采样拆成两种子作业:前者处理计算和参数更新,后者处理生成请求。把两类子作业放到一起,强化学习流程就能在生成样本与更新权重之间交替。不需要生成样本的监督微调可以单独安排,避免把一个复杂的在线流程当成所有试点的起点。
文档说明检查点保存在服务端的实验运行产物中,可以载入运行中的作业,也可以用已有检查点启动新作业。这个能力解决的是有状态产物的交接,不代表进程意外结束后能够无损地重做每个批次。训练代码的随机状态、数据偏移和评测结果是否能复现,仍需团队自己验证。
可以先选一个有离线验收集的文本分类或字段提取任务:记录基础模型分数和输入版本,用小作业验证能否保存、列出和重新载入检查点,再用同一测试集看恢复前后是否出现偏差。全程保留失败样本,以免把训练损失降低误写成业务任务通过率上升。
账单的关键不是提交时间,而是资源占用时间
按官方计费说明,提交、验证和等待分配GPU的阶段不收费;分配后开始计费,包括装载模型的初始化阶段。资源释放时计费结束,作业完成、失败或取消与释放相关。计价单位是AI Credits,按占用时间计量,不应只看优化器真正运算的几分钟,也不宜把计价表直接当作实际货币账单。
团队可以在试点中记录提交、分配、首批计算、保存和结束的时刻,观察慢任务究竟耗在队列、加载还是运行。用于持续推理的部署还有自己的生命周期,结束训练不代表相应服务资源一定释放。报道未创建作业或部署模型,不采用供应商的节省比例,也不推断某一类硬件在所有负载下更划算。
对已经有训练平台的团队,比较自建和托管时,最好使用相同模型、数据量与验收门槛。除了计算资源,还要记录工程维护、数据准备、检查点占用、失败恢复与推理发布的工作量。一个只计算正常训练耗时、排除初始化和重跑的方案,容易在遇到反复试验时低估预算。
作业终止也要设计成可验证的操作。若训练人员需要移交任务,接手方应能查到作业编号、当前阶段和最近可用检查点,并判断是继续、取消还是开新作业。仅看到客户端不再输出日志,不足以证明远端已停;资源管理台的状态和账单记录应能相互对照。
上线前可以先把谁能提交、取消、读取检查点与部署模型分别列清楚。开发者能启动训练,不代表他也应当发布供业务使用的模型。尤其是预览阶段,建议把审批和产物交接纳入试点,而不是等预算扩大之后再补。
小编判断
这项预览的价值是让工程师能先验证训练方法,不必为了一个领域任务先养一套集群。是否适合长期交付,则看三个结果:训练过程能否稳定恢复、账单能否解释、产物能否按企业权限要求部署。先用小规模样本跑通这三项,再考虑把复杂训练迁过去。