


 您尚未登录账户
 您的企业账号申请正在审核中


Polly语音引擎原位升级,接口不变仍要重测播报
客服系统不改调用代码,电话里的声音却可能发生变化。AWS于10月22日宣布升级Amazon Polly的Generative语音引擎,现有生成式声音原位更新,声音名称与API调用保持不变。它降低了接入新版本的工作量,也提出一个容易被忽略的问题:接口兼容,并不等于企业已经验收过的号码、地址和长篇内容会继续以完全相同的方式读出来。
快速看点:公告按9个语言区域列出14项新增声音,印地语和芬兰语首次获得该引擎正式可用的生成式声音;标准和神经语音不受此次升级影响;生成式声音仍不提供speech marks,SSML标签也并非全部支持。对企业而言,更新后的试听回归比“请求是否返回成功”更重要。
改的是合成引擎,不是整套语音Agent
Polly负责把输入文本转换成语音,可用于客服、内容朗读、培训和其他需要语音输出的应用。这次升级首先改变的是文字变成音频的环节,不是替企业完成知识检索、订单校验或客户身份确认。上游模型写错一个金额,后面的语音即便读得自然,也不会因此让这个金额变正确。
现有生成式声音采用原位升级,企业不必为了获得更新后的声音另换名称或改写原来的调用。新应用则可通过既有合成接口选择生成式引擎。不过,合成请求需要明确匹配引擎与声音:API默认引擎为standard,不能因为选了一个新声音,就假定服务会自动切换到generative。
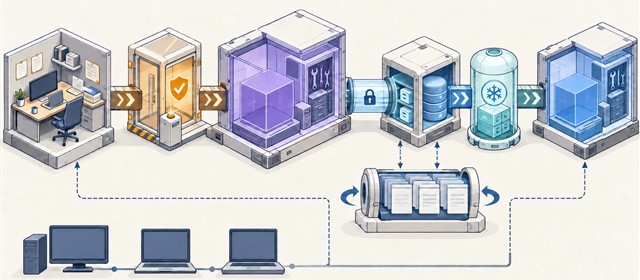
这也是与端到端语音模型不同的交付分工:业务系统生成或核对文本,再交给Polly合成,播放器或电话通道负责播出。每个环节都可能影响用户体验。服务公告所说的低延迟,并不是整个客服链路已经测得的统一响应时间,本轮也没有独立端到端延迟测试可供引用。
新语言正式开放,部署时仍看具体组合
新增条目覆盖美国英语、澳大利亚英语、印度英语、德语、美国西班牙语、巴西葡萄牙语、韩语、印地语与芬兰语。Arjun、Kiara同时出现在印度英语和印地语条目中;因此,语言区域中的条目数量不能被直接当成互不重复的声音身份数量。需要多语种应用的团队,应同时检查语言代码和VoiceId。
这里也有不能静默合并的资料差异:公告给出的全目录声音与语言区域总量,和当前开发指南列出的总量并不完全一致。本文不据此给出统一总数,也不把缓存中的旧目录当成最新清单。部署时可用DescribeVoices按引擎、语言查询,并检查返回的语言及支持引擎信息,而不是把新闻中的目录描述硬编码进程序。
区域同样需要逐项确认。语音合成可用,不自动意味着同一区域也支持所有流式方式或所有声音组合。已有流式链路在升级后仍需验证音频格式、缓冲和播放中断;计划采用双向流式输入输出的团队,更不能只根据“实时语音”四个字就假定目标区域已经具备相同能力。
具名媒体Sanoma Media Finland在公告中介绍,其新闻音频原来使用Polly芬兰语神经声音,并对新的Suvi生成式声音进行了测试。这里要区分旧流程的使用情况与新声音的测试感受:这不是新引擎已经在所有新闻音频中全面替换上线的证明,也不是可普遍套用的业务收益基线。
读得自然之外,还有三个验收缺口
第一个缺口是数字和实体。发布样例展示了订单号、日期、金额和地址的播报,但示例成功并不等于所有格式都能正确发音。实际回归可以包含连续数字、带字母的确认码、小数、缩写及跨语言专有名词,并由业务人员对照原始文本试听。以上是验收建议,不是本轮对服务准确率的实测结果。
第二个缺口是标记能力。生成式声音目前不支持speech marks,因此,依赖词级时间标记来同步字幕、嘴形或文本高亮的应用,不能只替换引擎就期待沿用原有机制。需要这种能力时,应另行确认可支持的语音类型或重新设计同步方案,而不是把有声音输出视为整条播放功能已通过。
第三个缺口是SSML兼容性。开发指南列出的停顿、语言等标签可用,但强调、新闻播报风格等并非生成式引擎都支持,音调和发音相关功能也存在部分支持情况。企业若在旧语音中积累了大量标记脚本,应按实际标签逐项检查,不能将“支持SSML”理解为完整支持所有标签。
开发指南还提醒,模型更新可能让同一个声音的听感产生细微变化,影响跨时间合成的长系列内容。生成式输出也存在异常和截断风险,内置紧急停止机制并不提供完全保护。保持一套有代表性的参考音频和文本样本,有助于区分主观音色变化、业务信息错误与播放链路故障。
小编判断:把接口回归扩展成听觉回归
此次Polly升级值得关注的不是又多了几种声音,而是企业可以在保留既有接入方式的同时得到新语音能力。对已有部署,这缩短的是改代码的路径,不是免除上线验证。声音名称相同、请求成功、音频可播放,只证明链路的一部分仍然工作。
较稳妥的实施方式,是先固定引擎、声音、语言和区域组合,再用真实但已脱敏的业务文本检查数字、专有名词、停顿与中断恢复,记录可接受的差异。最终交付标准不应只有“像真人”,还要包括“把业务内容完整、正确、可控制地说出来”。这也是语音Agent进入生产环境后持续需要维护的能力。