


 您尚未登录账户
 您的企业账号申请正在审核中


3公里不是天气预报,Ai2升级极端气候模拟器
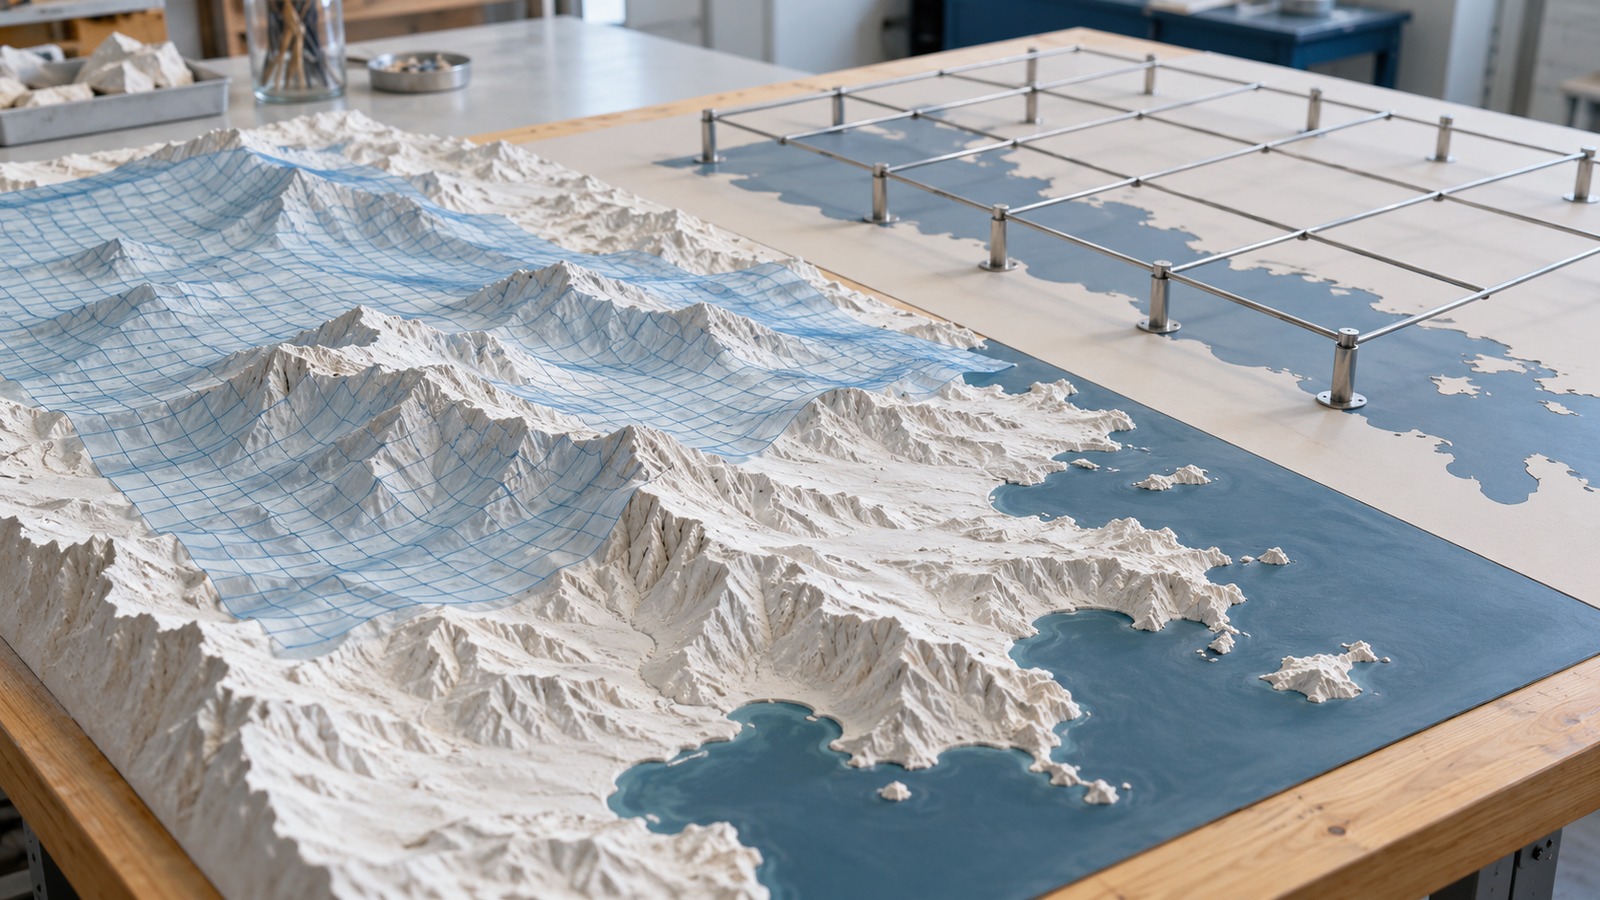
把气候数据细化到3公里,并不意味着能告诉你明天下雨的准确时刻。Ai2在10月14日介绍的HiRO-ACEv2,瞄准的是另一项难题:以较低计算开销生成大量高分辨率气候样本,研究罕见降雨、强风与风暴的统计特征。它学习的是既有数值模拟,而不是直接把现实天气观测变成可投入业务的预报。
快速看点:新版本从单独降雨扩展到降雨、近地面风与海平面气压;先生成约100公里的粗分辨率状态,再用扩散模型细化;模型卡明确写出气候泛化、区域拼接和天气预报方面的限制。论文中的节能比例与提速倍数,必须分开阅读。
先算大尺度,再补局部细节
研究采用两阶段系统。ACE组件先推进粗网格上的大气变化,HiRO再根据这些状态生成约3公里分辨率的细节。两个模型分别训练,但使用相互匹配的参考气候资料,目的是让粗尺度输出落在细化模型熟悉的输入范围,而不是对任意气候状态都进行可信放大。
这不是把一张地图简单锐化。新版本同时生成降雨、10米高度的东西向与南北向风、海平面气压,研究者希望不同变量能描述同一场事件。对于地形附近强风或热带气旋,只把某一张降雨图画得清楚,并不足以说明整套天气结构在统计上合理。
机器学习在这里扮演数值模型代理,而不是独立发现所有大气规律。它通过学习昂贵模拟已经产生的关系,较快生成新的样本。这样做的价值在于扩大可研究的事件数量,但也意味着参考模型自身的偏差与训练范围,会随之进入代理系统。
极端事件不能只看一张漂亮风暴图
10月13日提交的论文重点检查分布尾部,也就是极少出现的强度范围。作者调整了噪声采样、训练样本和去噪过程,以改善极端降雨、风与气压的生成。研究报告与X-SHiELD参考分布进行比较,而不是将图像观感当作唯一证据。
这一区别很重要:生成一个外形合理的风暴,和正确描述大量罕见事件的出现强度,不是同一能力。气候风险研究需要的是统计分布、区域差异与不确定性;几张有风眼和雨带的图,无法单独支撑对现实灾害发生频率的承诺。
模型卡提供了下载与推理配置路径,说明降雨按6小时平均、风与气压按6小时频率输出。它还区分粗模拟器和细化模型各自的强弱项。这些可检查资料让研究者能够追问误差来自哪一层,而不是把全部偏差混成一个“AI预测不准”的结论。
公开论文展示的是作者实验,并非本地独立复现。研究者或行业团队若要采用,仍应按自身区域和变量检查样本覆盖、分布偏差及边界拼接,不宜只把整体指标达标当成每个地点都可靠。稀有事件尤其需要足够样本,不能用一段短演示代替统计验证。
能耗约0.3%,并不是所有任务快300倍
论文将生成一年全球3公里数据的推理能耗,估为运行参考X-SHiELD模型的约0.3%。另一项墙钟时间比较则是8张B200 GPU对27648个AMD EPYC 9654处理器核心,约快33倍。两者衡量对象与资源配置不同,不能合并成“300倍实时提速”,也不是云账单或企业ROI测算。
这一边界决定了结果如何使用。若只需要某个区域,计算量可能进一步缩小;若改变输出范围、硬件或并行方式,耗时也会变化。模型训练、数据准备、存储和后续分析都不应被从项目成本中消失掉,推理阶段的效率并不代表整个研究流程具有同一倍数收益。
更关键的限制来自训练气候。模型卡明确,系统不适合天气预报,也不应期待泛化到训练条件之外的海温与二氧化碳情形;细化模型产生的是与X-SHiELD类似的数据,而不是观测真值。跨较大区域拼接还可能出现接缝或混合伪影,使用时必须检查。
研究团队计划增加适应其他气候状态的数据以及更多输出变量,但这是未来工作。当前开放模型不能直接包装成覆盖未来变暖情景的通用风险引擎,也不能跳过校准就用于预警。模型卡中的限制,与公开演示中的亮点,具有同等重要的阅读价值。
小编判断:更便宜地研究,不等于更大胆地下结论
HiRO-ACEv2的进展,在于让多变量高分辨率样本的生成更可负担,为研究极端事件提供新的实验工具。它尤其适合与原有数值模拟和统计检验一起使用:先明确要仿真哪一种参考气候,再判断代理能否保留关心的事件特征。
对AI产业读者,更普遍的启示是科学模型也需要清晰的适用范围。分辨率、能耗、运行速度和现实准确性是不同维度,不能只挑最大的数字传播。只有把代理模型擅长的部分与不该越过的边界一起交付,计算效率的提升才可能转化为可靠研究价值。