


 您尚未登录账户
 您的企业账号申请正在审核中


平均分相同也能退步,Langfuse把评测拉到逐项比较
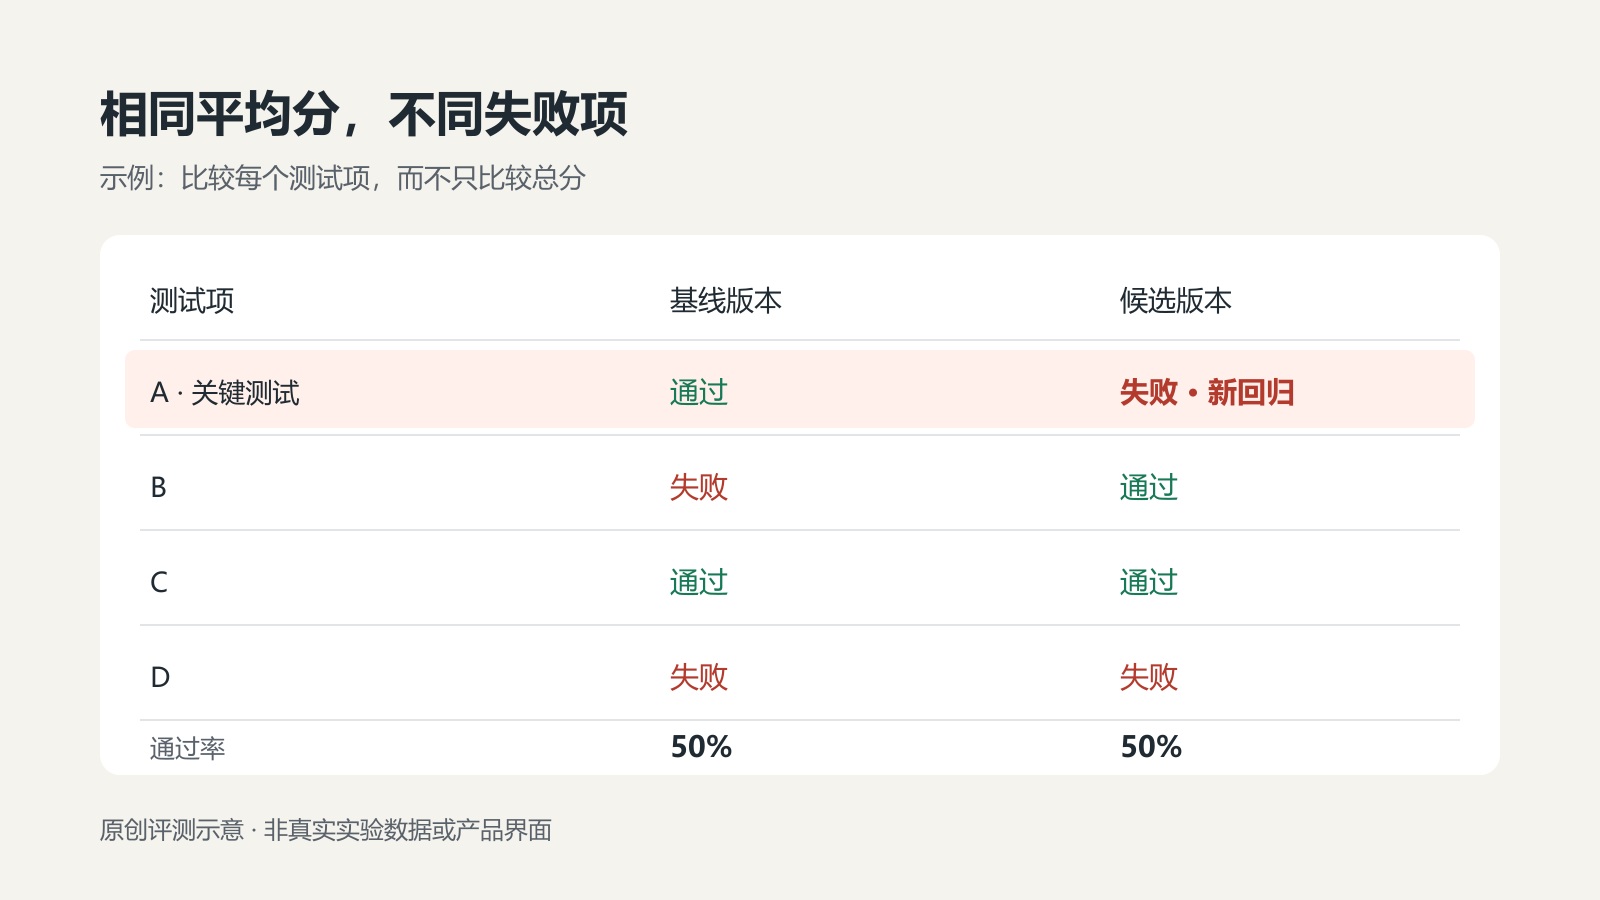
两版Agent的平均准确率都为50%,并不代表它们一样安全:旧版答对的退款规则,新版可能恰好答错。Langfuse在10月19日更新实验比较功能,把质量、成本、延迟与逐项回归放进同一套查看流程。结合此前的项目密钥权限和SDK升级,这轮变化更接近一个企业交付问题:怎样留住可靠基线,而不是被更漂亮的总分带着上线。
快速看点:实验页增加指标图表、汇总统计和阈值筛选;项目密钥可限制为只读、只上报或只写评分;新SDK有服务端及运行时版本要求。界面能帮助比较结果,但选择基线不等于已经配置持续集成的发布门禁。
平均分没变,关键用例也可能退步
这次实验页更新支持并排查看多个运行的指标、与基线比较汇总统计,并按分数阈值缩小到需要调查的条目。评审者可以逐项查看长输出,补充人工分数、修正答案或评论。用途不是让一个总分代替人判断,而是把“哪里变差”更快定位到具体输入与执行过程。
官方比较文档提醒,基线和候选应采用同一数据集版本与评估器定义,并记录应用提交、提示词或模型版本。固定数据集只固定输入,不会让模型输出变成确定值;缺失样本也不能算通过。若两次运行的问题本来不同,横向比较再精美,也可能得出错误结论。
一个简化例子是四道测试,两版都答对两道,但新版把原先正确的关键用例改错了。50%的总分掩盖了风险位置变化。企业交付通常更关心“不能新增某类失败”,因此应先明确哪些用例必须保持通过,再决定整体平均值是否足够,而不是事后挑选对升级有利的指标。
出现回归后,还要区分应用错和评估器错。检索材料过期、模型忽略正确材料,与字符串检查过严,是不同问题。如果修改了评分规则,应让基线和候选都按同一新规则重评;否则所谓进步可能只是尺子换了,而不是系统真的变好。
上报链路不必顺带拿到读取权限
10月16日的项目密钥更新提供Full access、Viewer、Ingestion和Scores ingestion四类范围。Ingestion可创建轨迹、评分和媒体,但不能读取项目数据;Scores ingestion只提交评分;Viewer用于只读查看。团队可以按集成任务分配权限,减少一个上报组件拥有不必要读取能力的情况。
文档明确,旧密钥保留原权限,创建后也不能直接修改其权限集合,需要新建不同权限的密钥替代。因此这不是上线功能后自动收紧全部历史授权。管理员仍要盘点哪些服务在用旧密钥、它们是否读取提示词或数据集,再安排切换与检查,而不能只看设置页出现了新选项。
只写上报同样不等于内容可以随意收集。轨迹中可能包含客户文本、工具结果或内部材料,缩小读取权限不能代替采集前的脱敏、保留期限和访问审批。权限边界解决“谁能做什么”,数据治理还要回答“哪些内容应该进入系统”。两者需要一起落地。
升级SDK之前,先核对服务端与运行时
10月14日发布的Python SDK v5与JS/TS SDK v6面向Langfuse v4,要求Cloud或自托管v4.59.0及以后,运行时分别需要Python 3.11及以上、Node.js 22及以上。仍在自托管v3的团队,应先保留旧一代SDK,不能把客户端版本单独升上去就期待完整兼容。
新主版本清理了已弃用接口,评分命名空间等变化也需要按迁移指南检查。压缩导出、实验链接和元数据过滤有助于操作,但并不是每个旧调用都能不改就继续工作。例如嵌套元数据值仍按字符串存储,不能把可过滤误解成已经支持任意数值或布尔比较。
对平台团队来说,升级验收应覆盖轨迹是否完整送达、评分能否写入、提示词读取是否仍获授权,以及实验结果是否能关联到正确版本。不同密钥范围与SDK调用组合后,原本隐藏的过宽权限可能会暴露出来;这是需要明确修正的集成问题,不应直接给所有组件恢复全权限。
实验页选定一条基线,也不会自动替仓库建立发布规则。官方文档将基线批准与门禁策略放在代码仓库管理,要求处理新增关键失败和未完成结果。工具可以展示权衡,但什么变化允许上线、由谁批准,仍是组织自己的工程与业务决定。
小编判断:把上线理由变成可追溯记录
这轮更新的价值,在于把评测、权限和版本迁移接到同一条交付链上。评测负责暴露变化,权限限制组件能力,版本记录帮助复现决策。三者都不能独立保证Agent可靠,却能让一次上线不再只依赖演示效果或临时口头确认。
更可执行的做法,是明确批准过的基线、关键用例、评估器版本和回滚条件,再让工具收集证据。看到总分上涨时仍追查失败项,看到调用成功时仍检查权限与数据范围。企业AI规模化需要的不是越来越多分数,而是每次改变都能说清为什么可以接受。