


 您尚未登录账户
 您的企业账号申请正在审核中


PyTorch推理换上TPU,vLLM开放原生后端
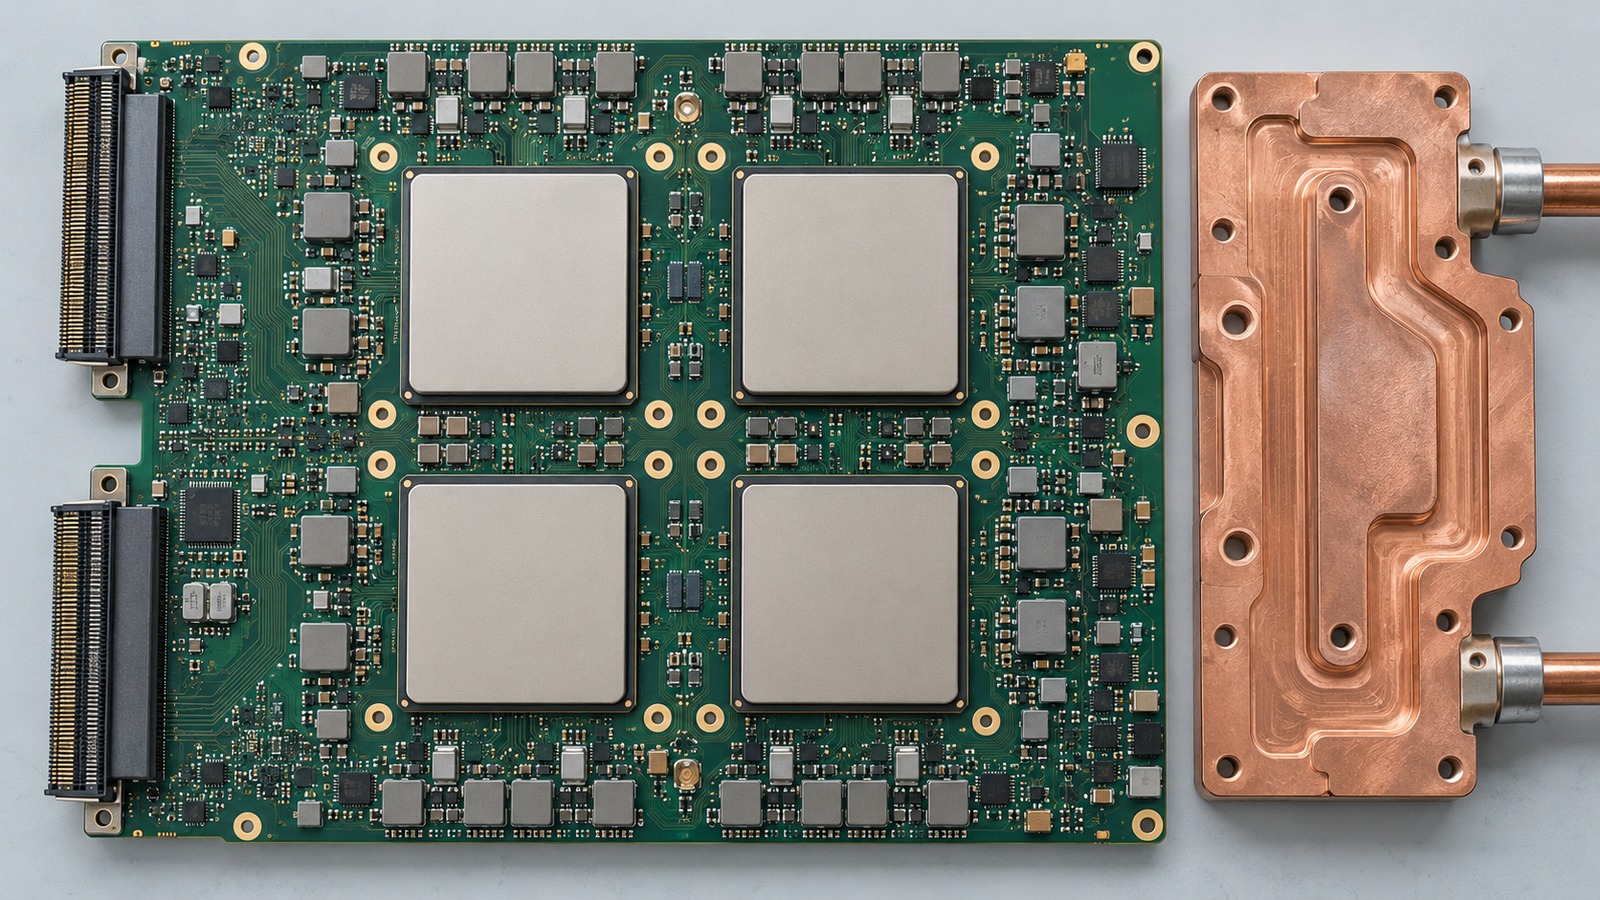
把PyTorch模型搬上TPU,正在从“先换一套模型实现”变成“尽量保留现有服务接口”。vLLM在10月20日发布TorchTPU后端,复用自己的模型定义、调度器和API服务,将TPU相关工作放到插件与底层内核中。对企业来说,变化首先是迁移路径更熟悉,而不是已经证明所有模型都能零修改上线、所有工作负载都会更便宜。
快速看点:新后端通过平台插件接入vLLM;当前预编译安装路径要求Python 3.12;TPU v7x是推荐并持续测试的硬件,较早代际仍属实验范围。判断能否部署,应看具体检查点、精度、并行布局与验证等级,而不是只看“支持某模型家族”。
保留模型入口,把硬件适配往下移
Google的TorchTPU项目为PyTorch提供TPU后端,包括算子实现、编译缓存和训练推理示例。vLLM的新插件在此基础上,让已有模型运行器通过torch.compile编译到TPU,同时用专门内核处理注意力、混合专家和量化矩阵计算等任务。
这种分层的意义,是让业务应用尽量沿用已有命令行与兼容接口,不必因为换硬件,就把请求调度和缓存管理整体重写。但熟悉的入口不代表底层行为完全一致,算子、数值精度、内存布局和集体通信仍需要针对TPU验证;现有CUDA扩展也不会因此自动变成可用的TPU实现。
对已有推理平台的团队,适配可以分两层验收。外层检查请求格式、流式输出、超时与日志是否仍符合服务契约;内层检查模型输出、量化误差和资源利用率。把两者分开,能避免一条简单请求成功后,就误以为长上下文或多机流量也已经完成迁移。
核心库能安装,不等于服务插件环境已齐
版本要求需要仔细区分。TorchTPU核心仓库目前列出Python 3.11及以上支持,并提供0.2.0公开版本;而vLLM TorchTPU的预构建安装文档明确要求Python 3.12,相关依赖轮子面向这一解释器。不能把核心库的支持范围直接套给整个推理服务栈。
安装文档还区分组合包与独立插件包:前者同时提供vLLM入口并拉入插件,后者用于更细的源码开发与跨仓库组合。文档要求正确选择PyTorch CPU轮子,避免在TPU主机上误拉入不需要的CUDA依赖。安装路径本身也是兼容性的一部分,不能只记录一个插件版本。
首次启动还要编译所配置形状的执行图,可能耗时数分钟;设置编译缓存可在后续重启时复用产物。因此,测量服务启动与请求延迟时,冷启动和缓存命中要分开。若把已预热结果当作所有场景的体验,就会低估故障恢复、弹性扩容或更新配置后的等待。
支持表中的四种等级,不能看成同一承诺
官方模型表将验证分成持续集成、夜间流水线、组件测试和示例配置。持续集成会随提交检查,示例则可能只提供脚本或配方,没有被安排进自动端到端服务测试。表中列出了Qwen、DeepSeek、Kimi、GLM、Gemma等具体检查点,但不同条目的证据强度并不相同。
以Kimi-K3为例,表中注明日常提交检查采用裁剪专家的变体,完整模型另有按需的大规模测试;某些模型或功能仅有组件覆盖。缺少某项持续集成记录,不一定意味着完全不支持,但也不能据此承诺已完成对应组合的生产验证。企业应保存当时所依据的支持矩阵。
硬件范围同样有边界:v7x是当前推荐平台并进入持续集成,v6e、v5e与v5p仍属实验范围。软件能复用模型代码,不等于跨代硬件拥有同样性能与稳定性。本次公开材料提供了部署和测试入口,但没有足以推导通用企业ROI的独立成本数据。
插件还提供多种并行、前缀缓存、推测解码和预填充解码分离路径,但这些能力需要与模型、拓扑、精度及缓存配置一起核对。业务方真正需要的是特定配置下的稳定服务,而不是一张功能数量清单;迁移评估不应跳过失败请求、尾部延迟和恢复时间。
小编判断:多一种算力选择,先从可复现迁移开始
TorchTPU与vLLM的结合,为PyTorch团队提供了更连贯的TPU推理入口。它的实际价值,是降低重新组织模型和服务代码的障碍,让硬件选择更有弹性。这里的“更容易”仍需要通过一次明确范围的试点证明,而不是由新后端发布直接替企业做出采购结论。
一个稳妥试点可以固定模型检查点与业务样本,锁定依赖版本,分别记录首次编译、热请求、长上下文和重启恢复,再与原有硬件基线比较质量、延迟与总成本。只有可重复的结果优于或满足现有约束,软件兼容性才真正转化为企业可用的算力选择。
后续还应关注支持矩阵的持续维护,而不只是发布当天能跑哪些模型。新模型、新量化格式和框架版本都会改变组合关系;能否及时暴露回归、保留已验证配置并提供明确回退路径,将决定这套开放后端能否从试点走向长期运营。