


 您尚未登录账户
 您的企业账号申请正在审核中


最大2.09亿参数,Mistral让时序预测不只报一个数
设备明天的温度可能是多少,和“有多大把握不越过危险区间”,是两种不同的问题。Mistral在10月15日发布Timestral时序基础模型家族,最大版本为2.09亿参数,可在CPU或GPU上生成多变量概率预测。它不是另一个聊天模型,而是直接处理传感器、需求与运营指标等数值序列,为现有业务流程提供下一步判断所需的信号。
快速看点:家族包含500万、2800万、1.23亿与2.09亿参数四种规模;输出21个分位数,而不只给单一预测值;可接收历史协变量和已知未来协变量。公开推理代码与模型权重分别采用不同许可,行业示例也不能当成已经验证的客户上线收益。
预测区间,比一个漂亮点数更接近业务决策
传统业务系统常把预测压成一个值:明天卖多少、下一小时负载多高。概率预测则给出不同分位位置,帮助使用者看到可能范围。Timestral模型卡列出21个分位数输出,使应用可以根据自身容错和资源约束选择观察角度,而不是把中位数误认为必然发生的结果。
这种输出并不自动保证区间可靠。若数据分布变化,或某类异常在训练与评测中覆盖不足,分位数仍可能偏离真实频率。企业采用时应检查区间覆盖与实际误差,并把它们与库存、容量或维护决策的损失联系起来,不能只因为图上出现上下界,就认为不确定性已经被解决。
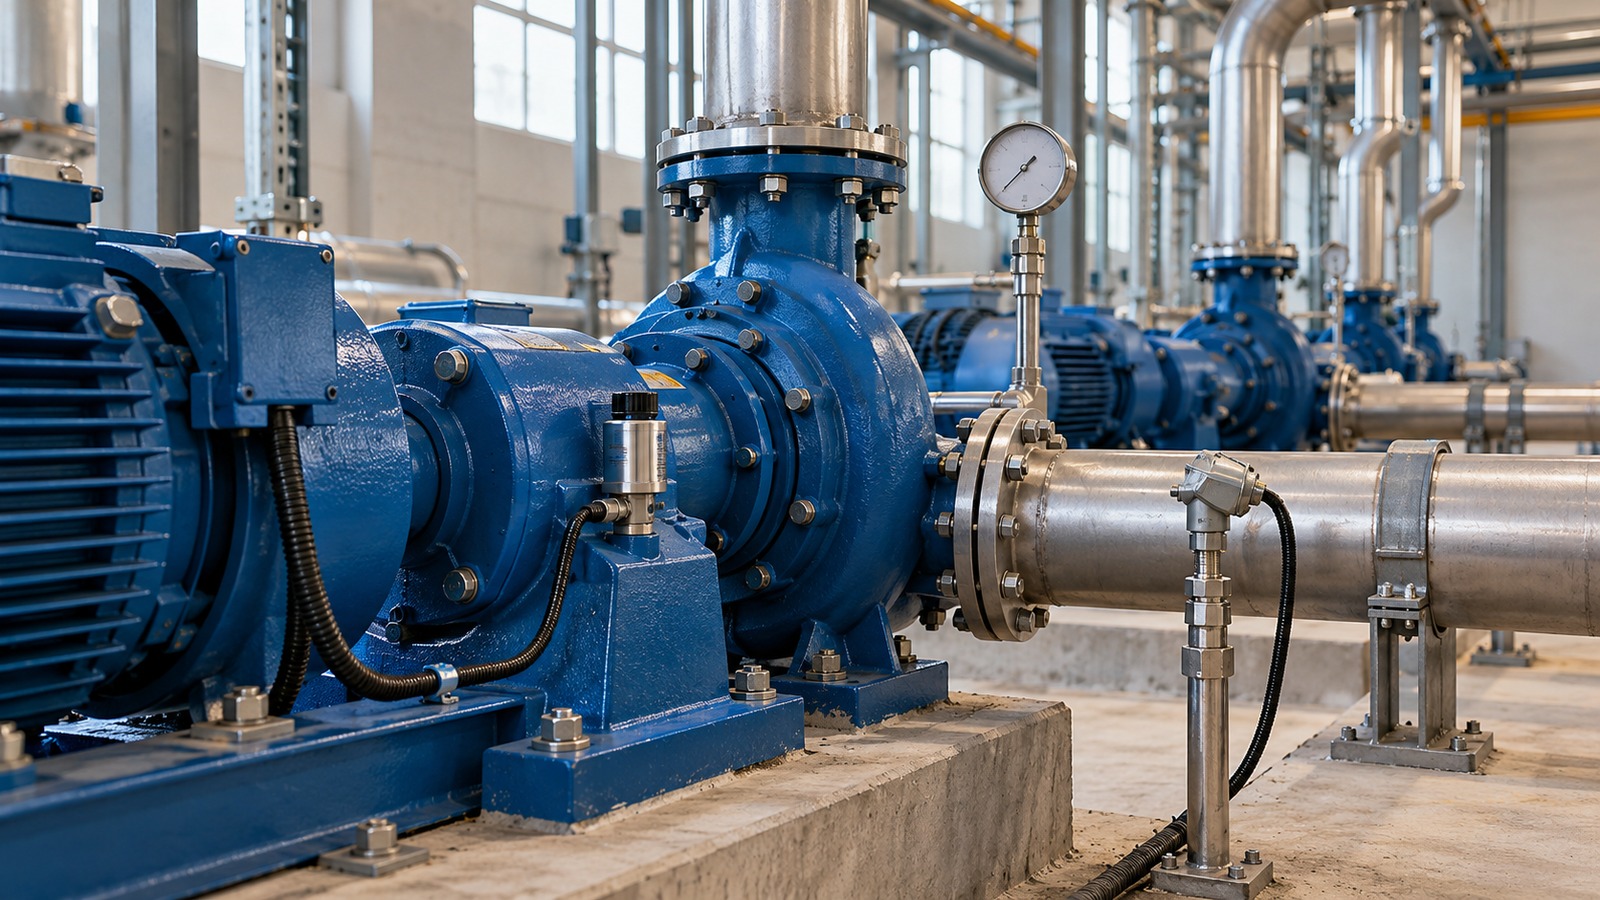
多变量预测的另一层价值,是让相关信号一起参与。泵的温度、振动和压力可能共同反映状态,分别预测容易忽略相互关系。但相关性不等于因果,模型指出异常也不等于完成故障诊断;根因分析仍需要维修记录、设备知识和专业人员核查。
生产计划可以用,未来答案不能偷看
Timestral区分目标序列、仅有过去数据的协变量,以及事先已知的未来协变量。生产排程、节假日和计划停机可以影响未来需求或设备状态;将这类信息纳入预测,有机会减少把正常计划变化当成异常的情况。模型还支持数值与类别输入。
关键是“当时确实已知”。回测若偷偷使用事后才获得的真实天气、最终销量或修订数据,就会让预测看起来远好于上线表现。已知未来协变量应该是预测时能得到的信息,而不是事后补齐的目标答案。企业需要保存信息可用时间,才能区分建模进步与数据泄漏。
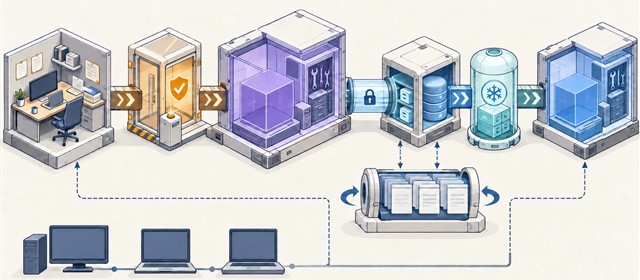
官方工业泵流程只是应用设想:先从传感器找出异常,再由Agent结合历史故障和维修资料提出诊断建议。它说明数值模型如何与语言模型分工,不是具名工厂已经投产的证据,更不能据此推导已减少多少停机时间、节约多少维护费用。
32768是历史步数,不是无限远预测
2.09亿参数模型卡给出的输入上限为32768个历史时间步,单次前向预测最多1024步;更长区间采用分块方式,把上一块中位预测接回上下文继续计算。时间步由数据采样间隔决定,不是语言模型token,也不能脱离分钟、小时或天等频率直接理解成固定时长。
分块预测能延长输出,却也会让早期预测参与后续输入,因此不能把很远期结果视作与短期预测同等可信。业务团队应按真正需要的预测跨度评估,并关注错误随跨度扩大的方式。历史窗口够长,只说明模型可接收更多过去数据,不证明未来越远越准确。
公开仓库提供独立推理实现,支持CPU与GPU,代码采用Apache 2.0,单独发布的模型权重则为Modified MIT。二者不是同一份许可,部署前需要分别检查相应材料;不能因为代码仓库显示Apache,就把权重也写成相同授权范围。
Mistral还给出了公开基准和特定CPU配置下的速度结果,但完整技术报告仍待发布,本次不将排名或延迟扩展为通用生产保证。实际性能会受到序列数量、历史长度、预测跨度、硬件和线程设置影响;上线成本还包含数据清洗、重训、监控和业务验收,而不只是一次推理。
模型提供零样本预测入口,不等于企业可以省掉本地验证。设备老化、促销策略或需求结构变化都会改变序列规律。需要持续保留基线与失败样本,明确何时重新校准或训练,并确保预测异常时业务系统有可用的退路。
小编判断:先让数值模型负责数值问题
Timestral值得关注的地方,是把企业AI视野从对话与文本扩展到密集存在的时序数据。数值模型做预测,语言模型解释资料、组织证据和建议,人类决定高风险动作,这样的分工通常比让一个聊天Agent包办所有分析更容易验证。
真正的试点可以从一个数据稳定、损失可衡量的场景开始,固定历史回测窗口,排除未来信息泄漏,同时比较点预测误差、区间覆盖和实际业务代价。模型变小、接口更容易运行,只是降低试验门槛;是否进入生产,仍应由同一套可重复验收标准决定。