


 您尚未登录账户
 您的企业账号申请正在审核中


NVIDIA串起GPU集群验收,修好节点也要重新过关
一台GPU没有报硬件错误,不代表它在多节点训练中表现正常;一台故障机器完成重启,也不代表可以直接回到生产资源池。NVIDIA在11月5日介绍DSX OS的集群配置、认证和运维链路,将基线、真实负载测试与修复后再验证串起来。值得关注的不是“自动修好一切”,而是谁有权判断节点重新可用。
快速看点:AICR生成配置基线,现有部署工具负责应用;NVCRE测负载并报告问题,不隔离节点;NVSentinel的隔离、修复和再验证要逐项启用。
配置正确、基本健康和能跑任务,是三件事
这次是三个开源组件的运维方法介绍,不是把某个旧组件重新包装成首次发布。AICR用固定版本、依赖关系和健康断言描述集群软件状态,再生成适配现有部署工具的材料。它负责生成与检查,实际部署和持续协调仍由团队已有的工具承担,不能把一份配方当成已完成安装。
固定版本也不是永久正确。团队仍需审批驱动、网络和操作器变更,保存基线并检查偏离。手工改动如果没有回写配置,下一位值班人员可能面对一个与文档不同的集群。版本控制的意义是让差异可解释,不是让变更流程自动获得业务批准。
NVCRE进一步在节点组上运行通信测试和训练负载,从日志提取带宽与有效工作量,并记录失败节点及原因。它针对的是实际负载下的准备程度,而不只是某个服务进程仍在。官方仓库明确,NVCRE本身不cordon、不加污点,也不以别的方式修改节点,隔离留给平台处理。
测试跑完,不等于性能已经达标
技术介绍提醒,示例认证的性能阈值默认不配置;如果测试能够启动并完成,低于团队目标的节点也可能通过。因此“认证通过”必须连着所用测试与门槛一起读。采购交接若只保存一个绿色状态,却没有保留测了什么、目标是多少,之后很难据此定位退化。
例如,多节点通信表现异常时,NVCRE可拆分失败组重复检查,缩小可疑节点范围。它报告疑点和原因,不代表已经证明某个硬件部件必须更换。平台团队仍要结合拓扑、配置和维修记录调查,避免把网络配置问题当成单卡损坏,也避免两套系统同时抢着修改同一节点。
性能门槛应来自实际集群与交付任务,不能照抄文章里的带宽示例。不同节点架构、网络和测试方式的数值不能直接横比。本文没有部署控制器、提交训练作业或复跑认证,也不把开源功能说明写成本站测得的可用率提升或训练成本下降。
再入池验证,需要明确触发与放行条件
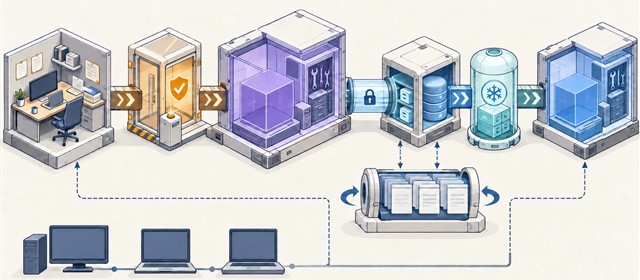
NVSentinel默认从监控开始,把故障反映为节点状态,不自动驱逐任务或重启机器。团队可逐步启用隔离、排空和修复,分别设置规则、影响范围与升级处理。它们是会改变生产状态的动作,不应因为监控安装成功就一起打开。某些故障仍需要人工调查或联系支持。
配置生命周期验证后,新节点加入,以及故障修复后返回,可产生验证请求。节点先被调度门槛挡住,再由NVCRE执行选定测试,达到放行条件后才重新安排工作。新节点验证与修复后验证有独立开关,不能只配置其中一个,就宣称两条路径都已经覆盖。
原地驱动升级、操作器升级或网络变更不会因为这条链路存在,就自动触发再验证。团队应在自己的变更流水线里接入基线检查和相应测试。尤其是升级后仍保留旧的通过记录时,要区分“此前通过”与“本次变更后通过”,否则最关键的验收窗口依旧可能空着。
放行也要作为受控动作审计。验证失败后的恢复规则和请求删除语义需要在实施前读清,不能把删除失败记录当作修复证据。测试系统给出的状态、运维系统执行的动作和调度系统最终是否可接新任务,宜保留相互关联的记录;这样事后才能解释一次节点回归为什么获准。
一个可复用的交付清单应至少保留配方版本、测试清单、性能阈值、节点范围与审批人。先在小范围观察,再演练失败、修复和再入池,确认没有其他控制器还持有隔离状态。自动化减少交接步骤,但不会取消对维护窗口、业务中断和异常升级的责任。
小编判断
这条链路把GPU运维从“看见告警”推进到“用工作负载重新证明可用”。真正值得复制的是职责分离:生成配置的人不冒充部署完成,检测工具不擅改节点,修复流程不跳过再验收。只有阈值、触发与放行规则都明确,自动归队才有可靠的依据。