


 您尚未登录账户
 您的企业账号申请正在审核中


Claude轨迹接入MLflow,开启全文前先看导出边界
智能体答错了,工程师想知道它到底读了什么、调用了什么工具,常常只能拼应用日志。11月3日,Databricks公布Claude原生OpenTelemetry轨迹接入MLflow的方式,把模型和工具步骤送进统一的调查与评测流程。这条链路仍处公开测试;能看到执行轨迹,也不意味着默认保存了完整对话,更不意味着每个外部工具都已被记录。
快速看点:SDK与服务端有两条采集路径;默认只发元数据;开启全文后,还要检查截断、接收方留存和导出失败。
先分清,谁看得见哪一段执行
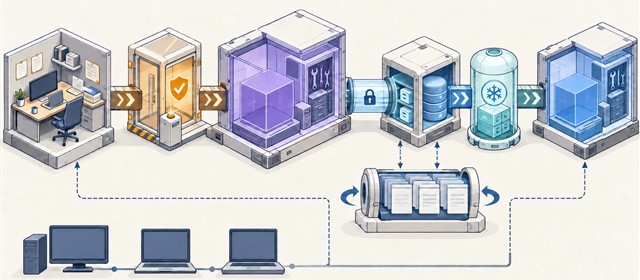
Claude SDK在应用里创建记录,由应用自己的遥测导出器发送;API侧则由管理员配置目的地,将支持的服务端活动直接送到接收平台。两者可以同时使用,但不能互相替代:应用侧能记录工具运行器执行的客户端工具,服务端可以记录自己运行的模型步骤和工具。缺了相应采集路径,就不能仅凭另一侧的记录宣称看见了全程。
Databricks的方案由接收入口把这些步骤写入Unity Catalog表,并关联到MLflow实验。这样开发者可以把一次异常回答与它的模型请求、工具活动和时间信息放在一起看。表和实验的访问仍需单独配置;接入遥测本身不自动赋予所有团队读取提示或客户数据的权限。
例如,客服助手反复搜索同一条订单记录,轨迹可以帮助区分是模型不断提出相同请求,还是应用重试了失败的工具。要定位这类问题,先统一请求关联方式,再对照应用错误记录,比仅看回答文本更有用。但本站没有运行模型或创建实验,不能据示例承诺自动找全问题。
默认元数据,也不等于绝对没有业务文本
官方默认模式不包含模型提示与回答,主要保留标识、时序、状态和词元计数。它也可以包含开发者写入的工具名称、描述及智能体名称等文本,因此“元数据”不能直接等同于已脱敏。若团队把客户名或工单摘要放进这些字段,仍需在上线前处理。
完整内容模式可以包含提示和回答,适合人工复核与构造评测样本,但要检查每条记录的内容上限。超过限制时会截短并带上相应标记;图片和文档也不是把原件完整塞进轨迹,而是以类型呈现。调查人员在阅读缺失前文的对话时,应先确认是否发生截断,不能把没记录下来写成模型没收到。
完整内容也不是把旧流量重新采回来。试点宜固定一小段测试流量,分别发送不含正文与含正文的记录,再在接收端检查字段、访问权限和清理方式。业务审批可以单独决定哪些工作区允许导出全文,不应因为排查方便就组织范围一键全开。
写进另一套平台,留存与失败也要另管
API导出把记录发到管理员指定的外部目的地,送达后由接收服务自己的留存与权限设置管理。即使原请求适用某种保留约定,也不能把约定直接套到第三方轨迹仓库。SDK路径则从应用环境向导出器发送,数据出入边界同样需要记录。
API侧提供目的地测试与健康状态;有限重试不等于无限补发。官方说明目的地被禁用期间的记录会丢弃,重新启用也不会补上这一段。因此验收除了看新记录是否出现,还应测试拒绝接收或认证失效时是否告警,并在事故分析中保留缺口,不能承诺完整归档。
MLflow可以把问题轨迹交给专家复核,也能用同一批案例评估改动;其问题检测能力另有Beta边界。团队仍要先写清失败定义和通过标准,避免把“工具调用次数少了”直接当作任务更成功。若修改提示词后答案更短,却漏掉关键步骤,也不应凭总消耗下降批准上线。
一个可复用的上线顺序是先收最少元数据,再选少量非敏感样本开正文,最后检查目的地权限和失败处理。每次调整字段或新增导出位置都留下变更记录,方便后来的人解释为什么某段轨迹没有内容,或为什么同一请求在两个位置留下记录。
小编判断
这项集成把调试和评测之间的距离缩短了,但真正的价值取决于记录是否可解释、权限是否明确。先回答谁采集、谁能读、哪里可能缺失,再把轨迹当作评测依据。可观测性是查证的起点,不是对任务正确、数据完整或留存安全的自动保证。