


 您尚未登录账户
 您的企业账号申请正在审核中


换网关后别带旧编号,Pydantic AI收紧状态复用
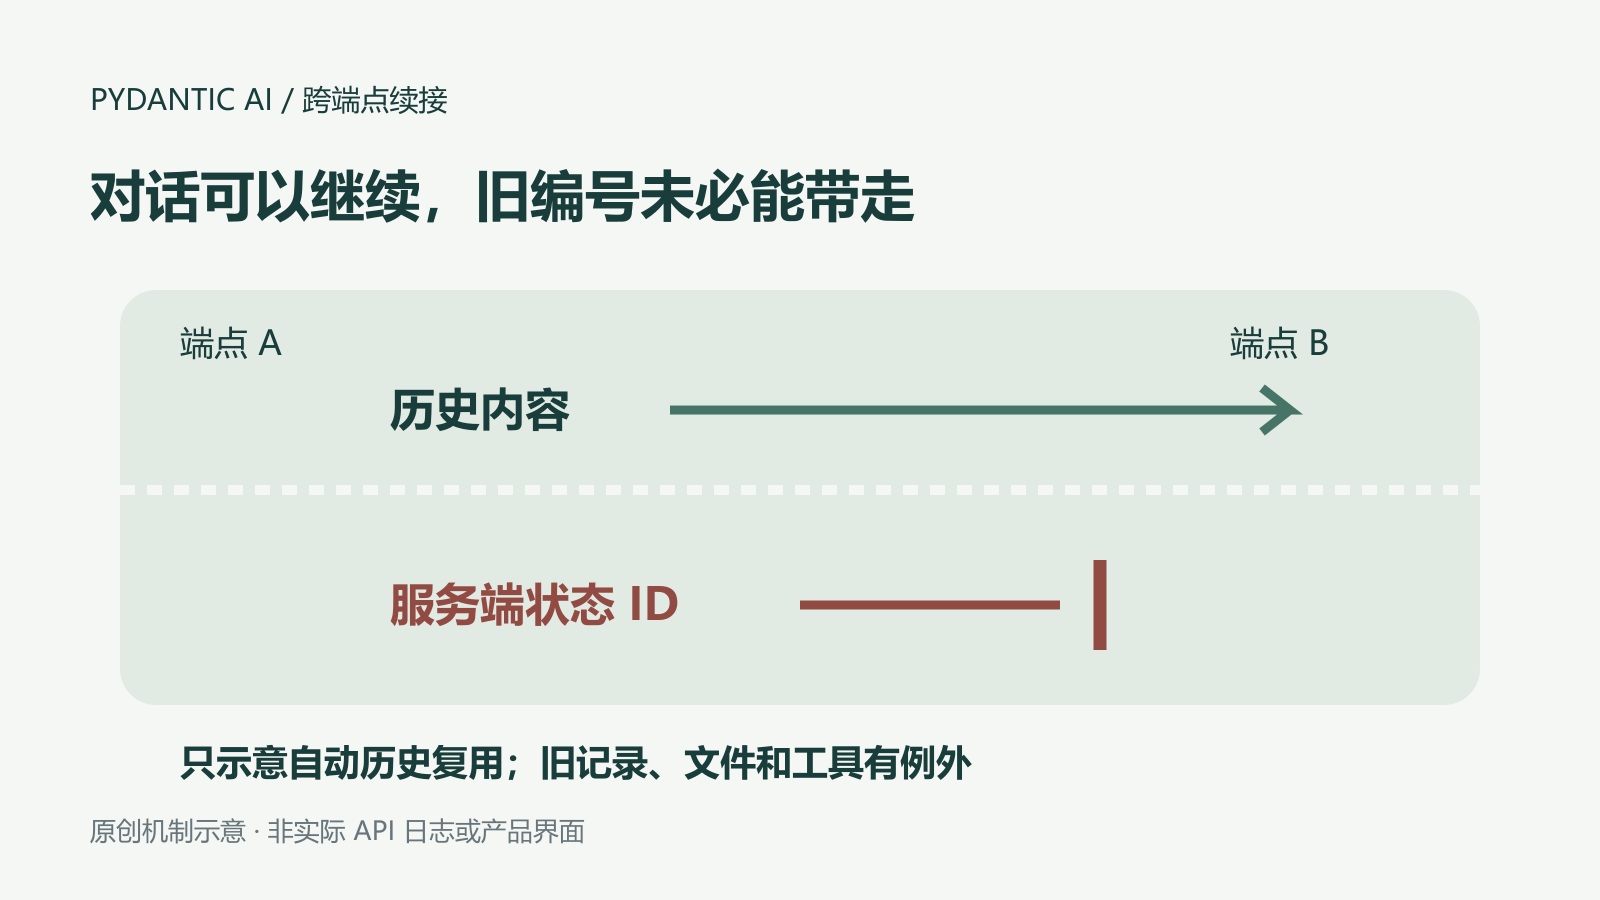
主网关出错,换一个兼容接口继续聊,为什么下一次请求反而找不到上一条响应?对多模型应用来说,协议兼容不代表服务器共享同一份状态。Pydantic AI 2.64修正的正是这层判断:不能因为两个接入都叫同一个供应商,就把前一个端点保存的响应、会话或容器编号,直接交给另一个端点继续使用。
快速看点:服务端状态ID按端点判断,普通历史内容走另一套回放逻辑;比较URL时会规范化部分写法,但不会检查账号凭据;没有端点信息的旧记录、上传文件及部分原生工具结果仍有例外。这不是“换网关自动防泄露”,也不是完整会话无损迁移。
协议名称相同,状态未必住在同一个地方
2.64.0版本标注10月30日,实际发布时间为当日23时27分UTC,换算北京时间是31日早晨;对应修改在29日23时13分UTC合入。本文只核验跨端点状态处理,不把同版本的模型回退、预算、护栏等其他变化一并认定可用,也不把开发分支的每日构建当成稳定发布。
一个OpenAIProvider可以指向不同base_url,AnthropicProvider也可以使用不同客户端。因此,供应商名称描述的是接入类型,不足以说明数据保存在哪里。上一个网关返回的响应ID,更像那个服务内部的取件号:换个服务拿同一个号去查,不保证能找到对应记录。
这次涉及的是需要服务器按编号查找的状态,包括已保存响应、输出项目、自动续接的会话和从历史中取出的代码执行容器。普通文本、客户端函数调用,以及按兼容家族判断的签名或加密内容,不能全混入这一类;它们能否回放,依据不同规则处理。
切走的是状态引用,不是整段对话
新判断先核对供应商名称,再用历史响应记录的provider_url与当前端点比较。URL规范化会忽略协议和主机名的大小写、默认端口及末尾斜杠;不同主机、路径、非默认端口或查询参数,仍可能被视作不同端点。它不是探测两个地址背后是否真的连到同一数据库。
在Responses接入中,前序响应引用、输出项目ID、自动会话续接和提示缓存诊断基准使用新的判断。转到另一网关时,不再把这些历史状态当作对方可以直接查找的记录。普通文本和可移植函数调用仍会按回放逻辑发送,不能把“少带旧ID”理解成“历史内容没有离开原服务”。
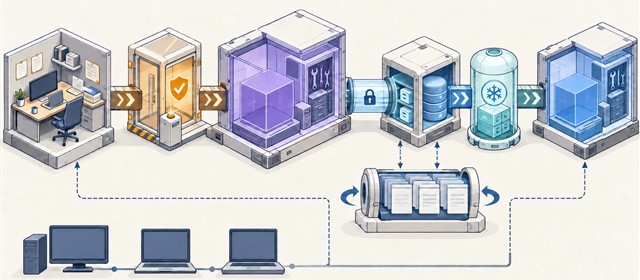
测试给出了可检查的区别:A端点生成一段历史后,同端点续接仍可带前序响应引用;换到B端点,模拟请求改为带用户问题、已有回答和后续问题,而不带A的前序响应引用。故障回退的两条调用路径也有相同检查。这是模拟请求验证,不是跨供应商生产成功率或费用实验。
Anthropic接入里,从历史恢复容器和选择缓存诊断基准,也应用端点判断。但用户显式指定的容器以及暂停回合的重连,不等同于普通历史自动复用;部分原生代码执行与MCP结果块仍按供应商名称处理,源码明确留下例外,不能宣传成所有容器相关数据都已经全面隔离。
旧历史、文件和代理别名,仍要单独验收
没有provider_url的响应,或本身没有提供器的模型,仍退回按供应商名称判断。兼容旧数据方便了历史延续,却也说明升级不能自动补出过去没记录的端点。团队应先检查自己的消息存档字段,而不是看见版本更新,就假设所有旧记录都具备同样严格的来源边界。
上传文件也不在这套端点判断之内。框架不会在同一个供应商名称下,自动追踪文件究竟上传到哪个端点或账号;应用必须选择确实能访问该文件的客户端。这项修复还不根据密钥判断账号:相同URL配上不同凭据,不会因此自动成为两个互不共享状态的隔离域。
如果两个地址只是同一份服务端存储的代理别名,可以在提供器子类中重写shares_server_state_with来声明关系。但这是应用主动承担的配置责任,不是框架已核实共享关系。错误地把不共享状态的地址列成别名,会重新引入状态引用无效的问题。
实施时可保留一组固定历史,分别测试同端点、另一主机、另一API路径、代理别名、旧记录缺字段和上传文件,再查看实际请求中留下哪些内容与编号。还要检查故障切换后的上下文长度、延迟和费用,并由业务审批决定哪些内容允许发送到备用服务;这些是建议验收项,不是本站完成的生产测试。
本站读取了正式标签中的URL比较、状态判断、相关请求映射和历史说明,以及新增测试材料,没有安装运行上游代码或调用任何模型端点。该变更不证明曾发生数据泄露,不保证服务器仍保存旧状态,也不自动恢复文件、迁移外部副作用或实现业务恰好执行一次。
小编判断
可靠的模型切换,必须把“协议能接上”“内容可以发送”“服务器认识旧编号”分开验收。这个补丁让第三件事有了更具体的判断依据,但第一、第二件事仍属于应用设计和治理。把URL、账号、历史字段与文件归属一起管理,才不会用一个兼容接口名,掩盖真正的交付边界。