


 您尚未登录账户
 您的企业账号申请正在审核中


调用都叫router,Langfuse如何找回实际派发模型
明明把请求派给了不同模型,监控里却都显示成router,这样的日志能拿来比较质量和成本吗?Langfuse 4.71修复了LiteLLM的一条OpenTelemetry归因路径:当上游带有实际派发模型字段时,先读取它,再考虑请求与响应里的路由别名。这不是新路由算法,而是让观测记录更接近已经发生的调用。
快速看点:4.71于10月27日正式发布;有效的Langfuse显式模型覆盖仍排在最前;本次处理的是带有对应属性的OTel上报,LiteLLM原生Langfuse回调不因此自动修好,费用和历史数据也需要独立核对。
路由别名方便调用,却可能遮住执行者
企业把多个模型放在统一入口后,业务代码可能始终请求同一个别名,网关再选择具体供应商和模型。统一入口有利于替换后端,但观测数据如果只留下别名,就很难判断一条回答究竟来自哪个执行者。错误分析、评测分组和价格匹配,都可能因此缺少关键上下文。
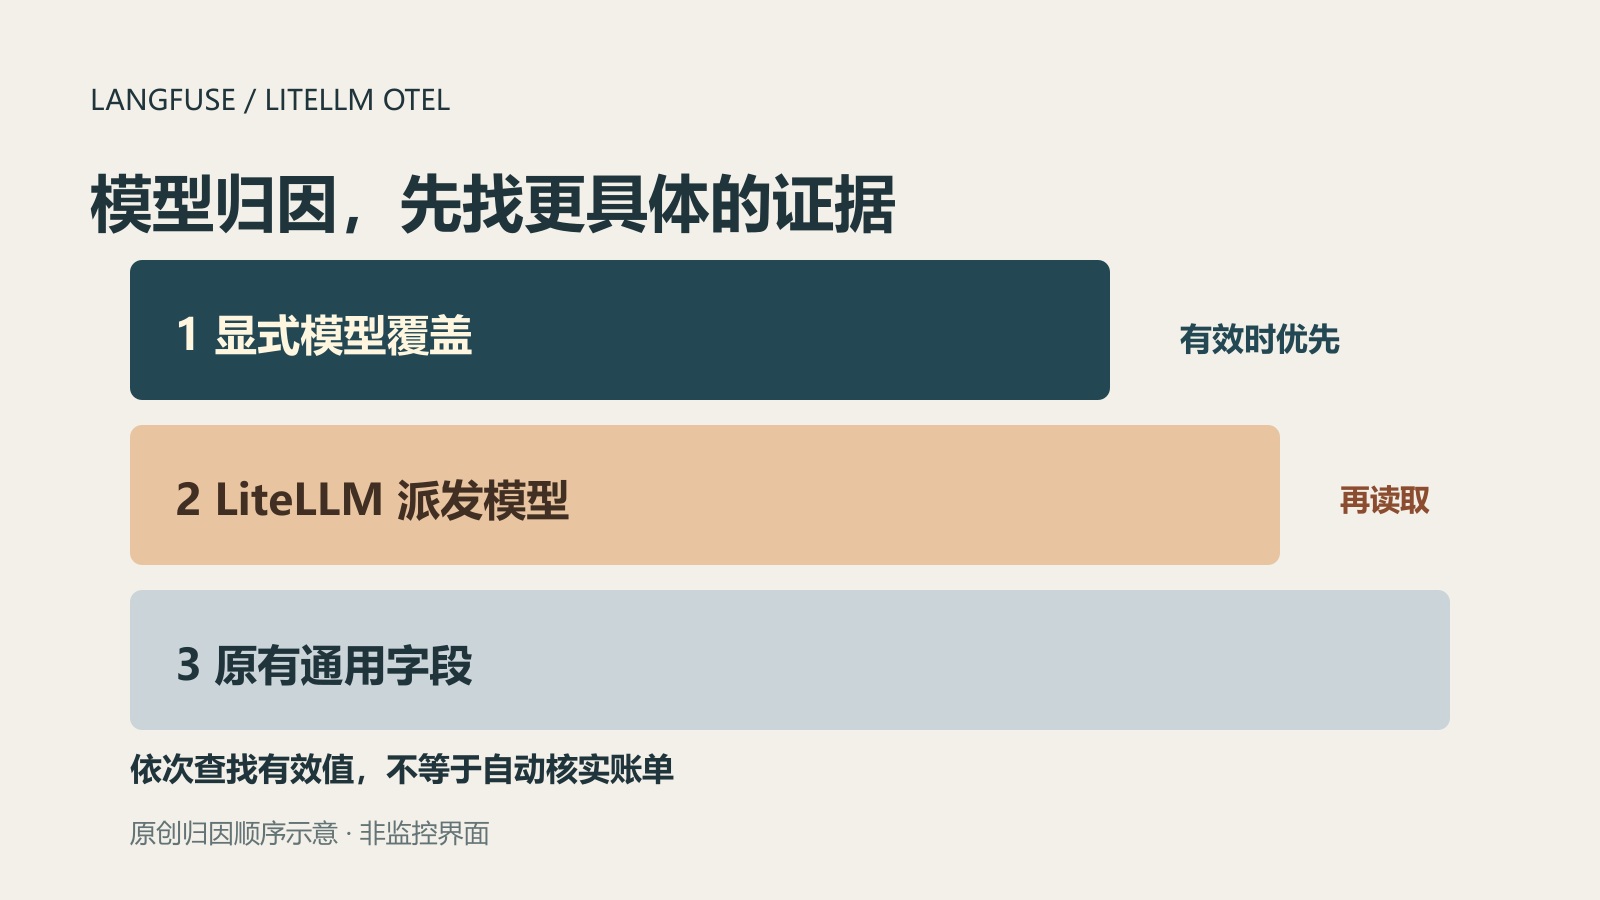
对应改动在模型名字段的读取序列中加入litellm.provider.model,并放在通用响应模型、其他框架模型标识和请求模型之前。如果LiteLLM已经报告实际派发名称,Langfuse便不必先使用仍然叫router的通用字段。它读取的是上游提供的证据,不会重新向供应商询问当时实际用了什么。
这种区别对排查路由很实用:看到请求别名与观测模型不同,不一定说明请求被篡改,也可能是路由已选择一个具体后端。实施团队应保留请求意图和执行记录之间的关系,再检查是否符合路由规则,不能仅凭名称相同或不同直接判断模型质量。
读取顺序变了,显式覆盖没有消失
正式标签的实现仍把Langfuse自己的显式模型属性放在最前,之后才是LiteLLM派发字段,再依次走原有通用后备字段。因此,如果应用主动填写了有效覆盖值,它依然可能遮住供应商字段。想让监控真实呈现路由结果,除了升级,还要检查应用是否一直写死了一个模型名。
读取到派发模型,也不等于这次请求的全部观测信息都已完整。一个模型名称只是关联线索,使用量、输入输出、耗时、错误和价格仍是其他证据。仅从这次读取顺序调整,无法推出所有调用都已准确计费,或每个供应商、部署别名都能自动匹配同一张价格表。
例如同一业务入口在两个后端之间分配请求,团队可以按实际模型分组,分别复核失败样本和延迟,再回到路由策略分析原因。这是可复用的验收方向,不是本文观察到的客户收益;没有完整样本与基线时,也不能把分组更清楚直接换算为成本下降。
先确认上报路径,再谈升级有效
该修复针对LiteLLM的OTel v2 span,依赖其中已经存在的派发模型属性。原生success_callback方式没有发出这个OTel属性,对应PR明确把它留给上游处理。如果企业走的是原生回调,仅升级Langfuse后仍看见别名,并不能据此断言此次OTel修复失效。
新增回归测试构造了一条LiteLLM记录:请求和响应模型都写成router,供应商字段则填入具体模型名称,预期转换后的观测模型采用后者。本站本轮查看了正式标签中的最终映射函数、调用位置和对应测试,也核对了PR说明;没有运行测试、部署服务或验证用户真实调用。
这项修复的提交与评审在9月已经出现,合入和进入正式4.71发布说明是在10月27日。两种日期不能混用,更不能只截取早期机器人评论来判断最终代码仍未实现。本轮以正式版本中的映射和测试为准,报道范围仅限这一项模型归因增量。
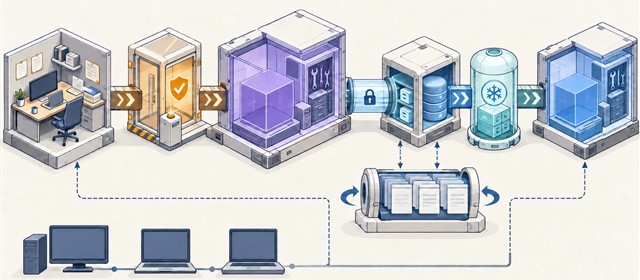
上线验收可以安排四组输入:带派发字段且没有显式覆盖;同时带显式覆盖;缺少派发字段;以及原生回调链路。分别检查最终模型名和原始属性是否符合预期,再独立核对费用口径。这些是建议执行的检查,不代表本文已完成四组实测。
旧记录也应单独处理。不要把“新的读取顺序正确”理解成历史记录已自动补齐:缺失的上游证据不可能仅靠改字段优先级凭空恢复,是否需要重放、回填或重新计算,应根据实际保留的数据和系统流程另行判断。版本中其他网关、界面及安全变更,也未在本文逐项审核。
小编判断
企业AI的可观测性,常常卡在最朴素的问题:这次究竟调用了谁?Langfuse把更具体的派发证据放到路由别名前面,有助于减少归因含混;真正可信的运营记录,仍要把上报路径、显式覆盖、模型身份和费用证据逐一对上,而不是看到一个新版本号就默认监控已经完整。