


 您尚未登录账户
 您的企业账号申请正在审核中


分数相同未必实验相同,MLflow补齐评测关联记录
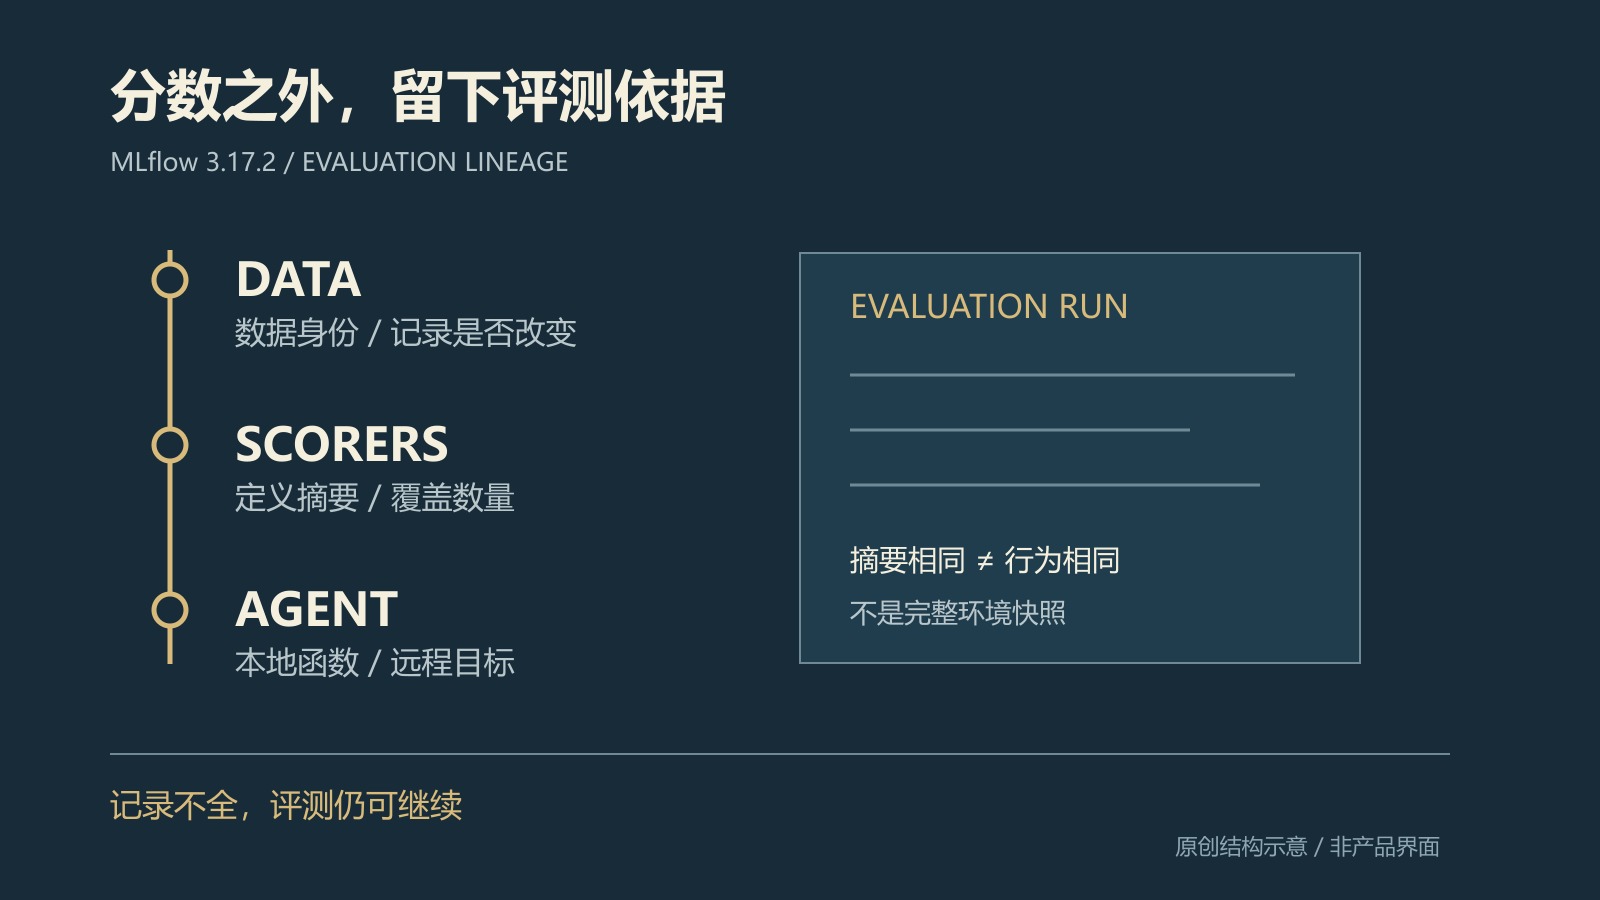
两次评测都得到同一个分数,可能只是恰巧相同:测试题换了、评分规则改了,或者背后的Agent已经不是同一份实现。MLflow在10月21日发布的3.17.2补丁中,为GenAI评测增加数据集、评分器和Agent的关联记录。它不是新添一种评分算法,而是尝试让团队在看到结果后,更容易追问一句:这次究竟拿什么、按什么规则、评了谁?
快速看点:一,关联信息进入评测运行记录,帮助解释实验条件;二,数据表改动、评分器无法生成摘要、远程Agent等情况分别处理;三,标签格式仍属实验性,记录失败不会使评测整体失败,不能把“评测成功”当成关联信息完整。
不是再算一个分数,而是给分数补上下文
企业评测通常跨越多个维护者:业务人员整理样本,工程师修改Agent,另一个团队调整评分器。只保存汇总分数,很难判断结果变化来自哪里。尤其是定期批量运行后,大家往往记得实验名称,却已经说不清当时的数据与定义是否发生变化。
此次更新围绕评测运行补充关联信息,覆盖数据身份、评分器定义摘要以及预测函数的身份线索。对应实现已出现在v3.17.2标签中,相关变更于此前合入主分支,再随补丁发布。不能把代码合入日期当成正式版本发布日期,也不必把它与3.17.0的权限、数据库升级事件混成一篇新公告。
对交付流程而言,这类记录更像实验清单,而不是新的质量结论。它能帮助发现“条件已经变了”,但不会替业务负责人决定样本是否代表真实工作,或某个评分标准是否足够严格。先有可追问的记录,才有进一步解释成绩的基础。
数据集转换后,原来的身份不能随便沿用
一个具体改动发生在数据集转为pandas数据表的交接处。转换时会附带原数据集身份及记录摘要;评测读取时检查记录是否仍与当时一致。若内容已改变,就不能继续仅凭残留属性把这张表认作原来的完整数据集。
标签内的测试覆盖了这个边界:完整转换的数据表可以关联原数据集,截取子集后则不继续冒用完整数据集名称。实现还区分记录值与类型,并让列顺序不影响相应记录摘要。这不是对所有数据变化自动生成业务解释,而是避免把旧身份无条件传递下去。
这对日常评测很重要。过滤掉失败样本、删除一类问题,可能让分数上升,却不代表模型能力提升。团队应保存筛选理由、样本数量及业务分层,再决定哪些运行可以并列比较。数据身份记录能提供核对入口,但不能替代这些评价口径。
定义摘要有覆盖边界,远程地址也不代表版本
评分器摘要同时记录成功生成摘要的数量与评分器总数。某个定义无法处理时,它仍被计入总数,因此“有摘要”并不等于全部评分器都已覆盖。实现也保留对排序和重复项的明确处理,方便比较定义集合,而不是只看几个相同名称。
本地预测函数可以记录函数身份,并在取得源码时生成摘要;若源码不可取得,摘要可能缺失。对包装远程服务的预测函数,实现记录远程目标URI,而不是把本地包装器当成真正的Agent。这能减少误认,却仍无法证明远程地址背后的模型和配置没有被替换。
代码注释明确说明:这些标签格式是实验性的,而且相同摘要不保证相同行为,被调用的其他代码和状态并未全部纳入。外部知识库、服务端配置、随机性或依赖变化,都可能影响实际输出。把摘要相等当成完整环境快照,会给复现实验带来新的误判。
另一项关键限制是,关联记录采用尽力写入方式,异常不会向上抛出而打断整次评测;超长标签也会被跳过。配套测试检查了记录失败后评测仍能继续。因此,需要关联信息作为发布门槛的团队,应另外检查必需字段是否存在,而不能只依赖任务返回成功。
小编判断:记录不完整,也应该成为可见结果
这次核对基于正式标签中的实现和测试约定,未运行上游整套测试,也不包含独立生产收益验证。关联记录不是不可篡改审计,不会自动保存全部依赖,更不会让一个设计欠妥的评测变得可靠。它解决的是解释实验条件的一部分问题。
更稳妥的实践是把“评了多少分”和“能否解释这次评分”分开验收。保存业务样本版本、Agent发布版本和必要配置,对摘要缺失、覆盖不全与远程目标变化单独提示,再决定是否允许进入比较或发布流程。分数之外能留下哪些证据,往往决定了团队能否真正从一次评测中学到东西。