


 您尚未登录账户
 您的企业账号申请正在审核中


33毫秒是本地测试,书生明决让小模型先做选择
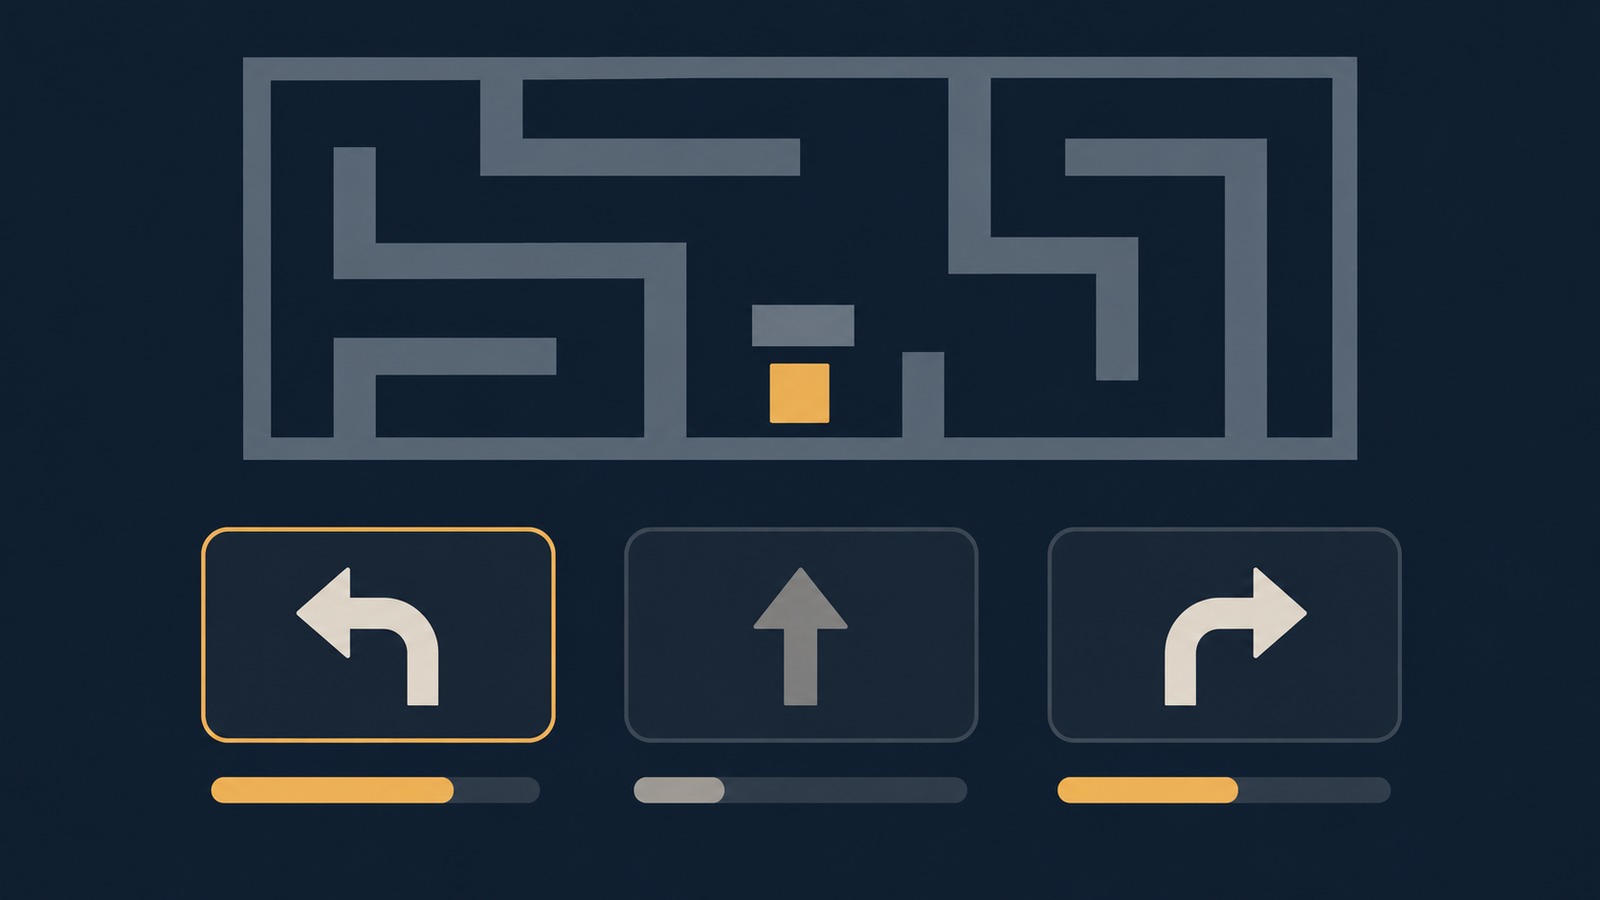
小模型每秒做约30次选择,是否意味着Agent终于可以边看边行动?上海AI实验室10月12日披露书生·明决的多模态决策能力,给出了接近33毫秒的本地测试结果。但这个数字对应固定输入和字段,不是浏览器或机器人完成整套任务的时延。真正值得关注的变化,是把有限选项的判断交给小模型,再把拿不准的问题转交大模型。
快速看点:明决包含0.8B、2B、4B三个型号档位,输出结构化选择和概率;代码与模型卡提供可检查的评测边界;快慢模型协作仍处于有限测试,不能被写成已经验证的生产成功率。
先选动作,不必先写一大段解释
常见聊天模型先生成语言,再由程序解析它想做什么。若业务只需要判断“交给哪个团队”“下一步选哪个动作”,长篇回答可能增加等待和格式处理。明决采用另一条路线:把当前状态、可选项以及需要回答的字段放进同一次请求,为每个合法候选计算分数,再转换成概率和结构化答案。
它能接收图像,但不只是给图片配一句说明。在界面或游戏中,系统可以把可执行动作限定为左转、前进、返回等选项,让视觉状态参与选择。这让高频局部判断有机会从长任务规划中拆出来;不过,演示中的动作选择和真实业务流程的端到端完成,仍然是两个层次的能力。
模型建立在Qwen3.5基础上,决策训练调整语言骨干,视觉塔与投影器保持冻结。输出方式不是普通的自由文本生成,而是对字段候选进行评分。对实施团队而言,选项定义、排列顺序和输入模板都属于接口契约,不能随意换顺序后仍假设概率含义完全相同。
33毫秒和90.02分,各自回答不同问题
RTX 4090测试中,0.8B和2B档位平均本地请求时延分别为33.98与33.28毫秒,4B为44.16毫秒。测试采用BF16、SDPA及原生Hugging Face推理,每次输入289个token,同时回答三个字段。这是特定负载下的响应测量,不包含任意图像处理、网络、工具执行与外部系统等待。
准确率方面,4B在七套任务上的不加权平均为90.02%,Jev为88.74%,相差1.28个百分点。七套数据包含不同类型和规模的决策,不能把这个平均数理解成全部业务请求有九成必定完成,也不能说它在七个单项中全部第一。比如困难子集上,4B与JevK5同为73.87%。
这两组结果可以用于筛选试点,却不宜混成一个“又快又全能”的结论。高频分类、工具路由与局部界面选择,对时延和候选集合的要求不同。企业若要比较模型,应该保持输入长度、设备、选项数量与业务标签一致,再观察错误集中在哪些状态,而不是只比较平均分。
置信度分流,节省等待也保留误差
明决的另一项探索是校准概率。模型说自己很有把握,并不等于真实准确率必然同样高;温度校准调整的是概率分布,不改变最高分选项。这有助于设计“低置信度交给大模型”的流程,但阈值要根据误判代价、任务分布和现场数据确定,不能从实验中直接复制一个万能数字。
在111道困难题的一次协作测试中,小模型独立答对82道;全部交给Atria-Dawn-Preview答对99道。分流方案把42道交给大模型,最终答对97道,耗时约140.16秒,低于全大模型的300.03秒。这展示了准确率与等待时间的取舍,并非同时取得最高准确率和最短时间。
仓库还提供96例已知概率分布的诊断评测,用于检查概率质量,而不是替代真实交互测试。题目包含配对设置,不能当成96次彼此独立的生产试验。工具调用成功、页面状态变化和动作造成的后果,仍需另外记录;高置信度的错误尤其需要抽样复查和可撤销操作保护。
开放范围也需分清:代码包含训练接口、推理后端、评分与校准工具,权重另在模型仓库提供;训练数据、私有校准和验证记录没有全部公开。书生·端砚接入仍是后续计划,不是今天已经完成的科研平台上线。使用者还要保留适用的上游许可和模型说明,不能把公开代码等同于完整训练链复现。
小编判断:把小模型放对位置,比追求全包更重要
明决带来的启发,是把Agent拆成有边界的决策单元:大模型理解目标,小模型处理高频选择,工具层执行已授权动作。这样的分工能否有效,取决于候选空间是否足够清楚,以及系统能否识别该停下来、升级处理或请求人工确认的时刻。它不是让小模型接管一切的理由。
试点宜先选择可回放、可核对、误判可控的流程,记录小模型覆盖率、升级率、实际动作错误和完整任务耗时,再与既有方案比较。若外部系统等待才是主要瓶颈,33毫秒不会自动变成业务提速;若权限和恢复机制尚未建立,快速选择也不能成为扩大自动执行权限的依据。