


 您尚未登录账户
 您的企业账号申请正在审核中


480GB是伙伴上限,Intel披露风冷推理卡细节
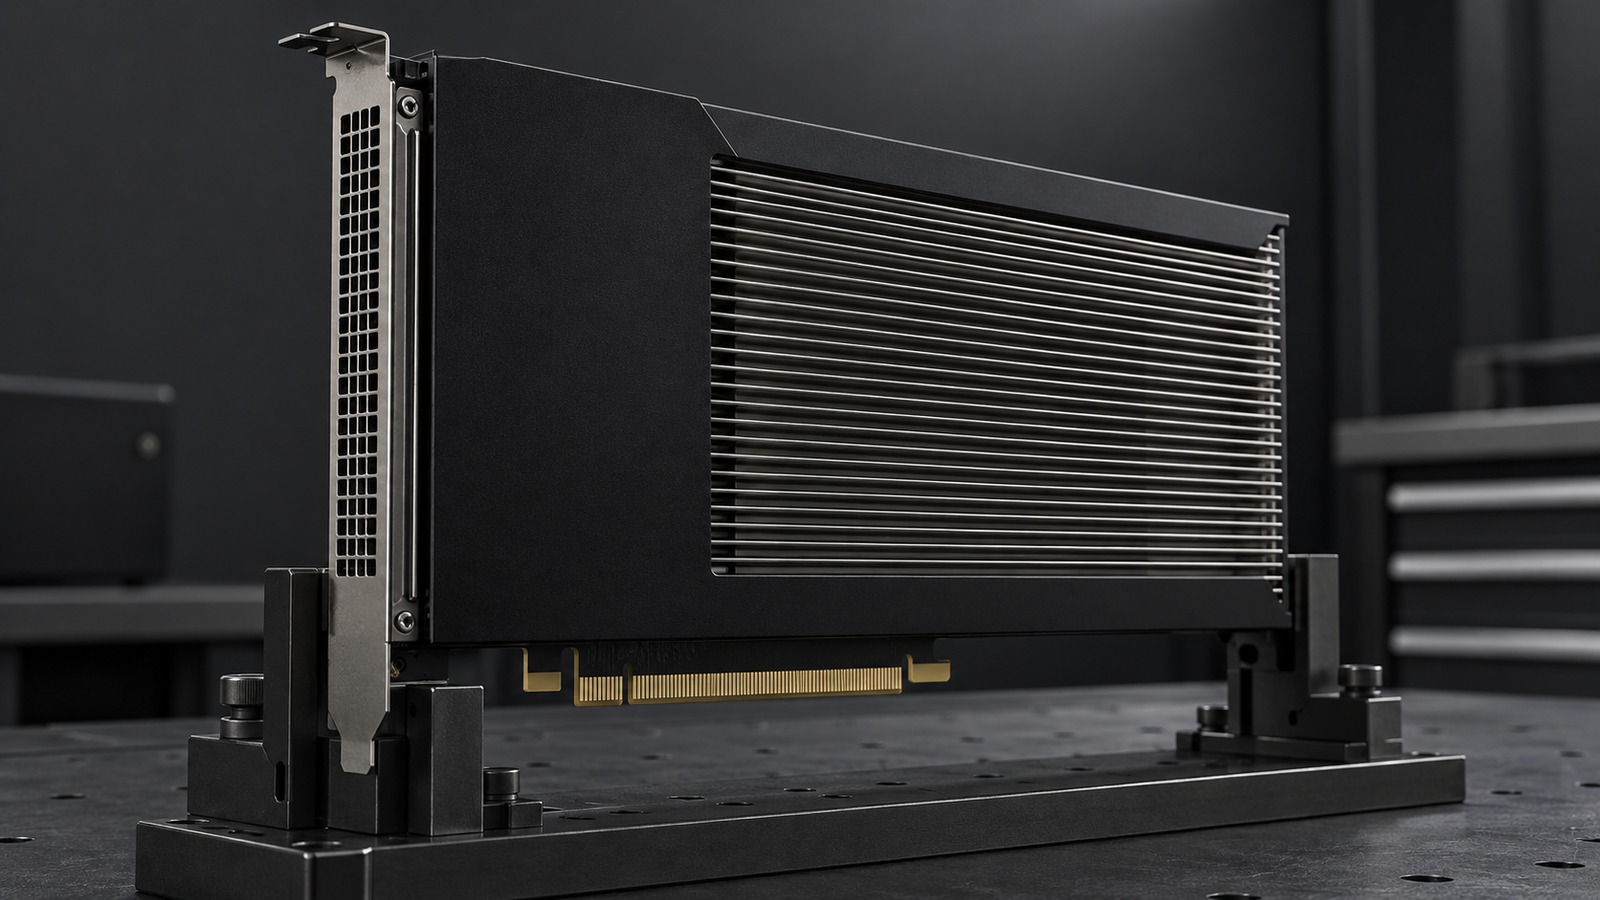
一张推理卡最多480GB内存,听起来足以改变部署选择,但这个数字有重要前提。Intel在10月12日的OCP全球峰会上披露GPU D系列新细节,首款D270主打大容量LPDDR5X与风冷PCIe部署;新闻材料脚注同时写明,Intel品牌卡为160GB,最高480GB来自伙伴可选设计。看清配置差别,比把最大数字当作默认规格更有用。
快速看点:D系列面向推理而非大规模模型训练;大容量、350W风冷与标准接口是设计重点;目前客户送样仍在进行,不代表已普遍销售,也没有可据此保证生产吞吐的独立任务结果。
从Crescent Island走向D系列产品定位
D系列此前代号为Crescent Island,采用Xe3P架构。此次公布名称及更多技术细节,产品页把D270定位为数据中心推理加速卡,面向长上下文、企业助手、文档理解及多并发服务。这是硬件方向与规格的进一步明确,不是把此前CPU编排方案重新包装成新事件。
Agent把一次任务拆为多轮检索、工具调用和推理,服务端要保存更多上下文,也要同时服务不同会话。因此,选型问题不再只有训练峰值算力:模型权重能否驻留,缓存还能容纳多少,持续响应是否达到业务要求,都可能影响真正完成的任务数量。
Intel的路线把更大的可用内存与已有数据中心条件放在一起考虑。这个方向值得关注,却不能从“专为推理设计”推导出所有推理任务都比其他硬件便宜。不同模型、输入长度和并发设置,需要的计算、带宽和缓存组合并不相同。
容量、带宽与算力,必须分开读
公开设计指标包括最高1.5TB/s内存带宽、1.3 petaflops的FP8计算能力,以及350W功耗范围。产品页还列出32个Xe3P核心与256个XMX矩阵引擎。它们分别说明数据搬运、特定精度计算与硬件组成,不是一个应用实测结果,也不能直接换算为每秒完成多少业务请求。
480GB上限与160GB品牌卡尤其需要区分。实施方应核对真正可取得的卡型、内存配置和配套软件,而非用伙伴设计的最大容量去计算所有设备。新闻页上的最高规格,和采购或试点中拿到的配置之间,可能存在需要逐项确认的差距。
仅作容量说明:一个3000亿参数模型,若每个参数用2字节保存,权重本身约需600GB,还没计入缓存及运行开销。这个粗算不是D270测试,也不说明模型不能通过其他精度或多卡部署运行;它提醒读者,参数量、精度和完整内存需求必须一起看,不能只比较两串大数字。
标准风冷接口,仍要过整机与软件验收
D270采用PCIe 5.0与风冷部署形式,设计上希望接入现有服务器环境,避免因新加速器立即要求整套液冷改造。对于拥有可用机架和风道的企业,这提供了不同的评估路径。不过,卡片采用标准接口,不代表任意服务器都能直接接纳其功耗、尺寸与散热要求。
整机还要核对槽位、电源余量、气流、固件与驱动,持续负载下的温度和性能也要测。风冷卡最终靠服务器风道排热,不能因为卡上没有显眼风扇,就忽略系统冷却。部署复杂度是否下降,需要以具体机器和机房条件判断,而不是只看产品外观。
软件层面,Intel强调共享Xe基础和开源框架接入,产品页提及PyTorch、vLLM等生态。熟悉的框架名称有助于识别迁移方向,但不保证已有模型、量化格式和算子已经在新卡上达到同样表现。驱动版本、算子支持与服务配置,需要随试点一起固定,才能比较结果。
当前材料说明客户送样正在进行,并未给出可以据此确认普遍供应的销售安排。新硬件还缺可独立复现的完整任务测试与价格条件,因此不应把内部性能预测、容量宣传或样品展示写成已兑现的ROI。可评估的规格已经增多,可采购与可交付仍是下一层问题。
小编判断:更大内存,是试点理由而非验收结论
D系列的看点,在于为内存较重的推理提供一条风冷、标准接口的设计路线。它不应被简化为峰值算力竞赛,也不宜提前被写成现有训练集群的直接替代。推理端真正要比较的是在目标延迟和完成标准下,设备能够稳定承载的任务量。
企业若取得样品,宜固定模型、精度、上下文长度和并发条件,同时记录功耗、失败重跑、维护与迁移成本。先确认实际卡型,再确认服务能力,最后计算整套系统成本。480GB是值得核对的设计上限,只有可复现的部署结果,才能把硬件规格变成可靠交付。