


 您尚未登录账户
 您的企业账号申请正在审核中


不只搜关键词,LangSmith用AI查Agent行为
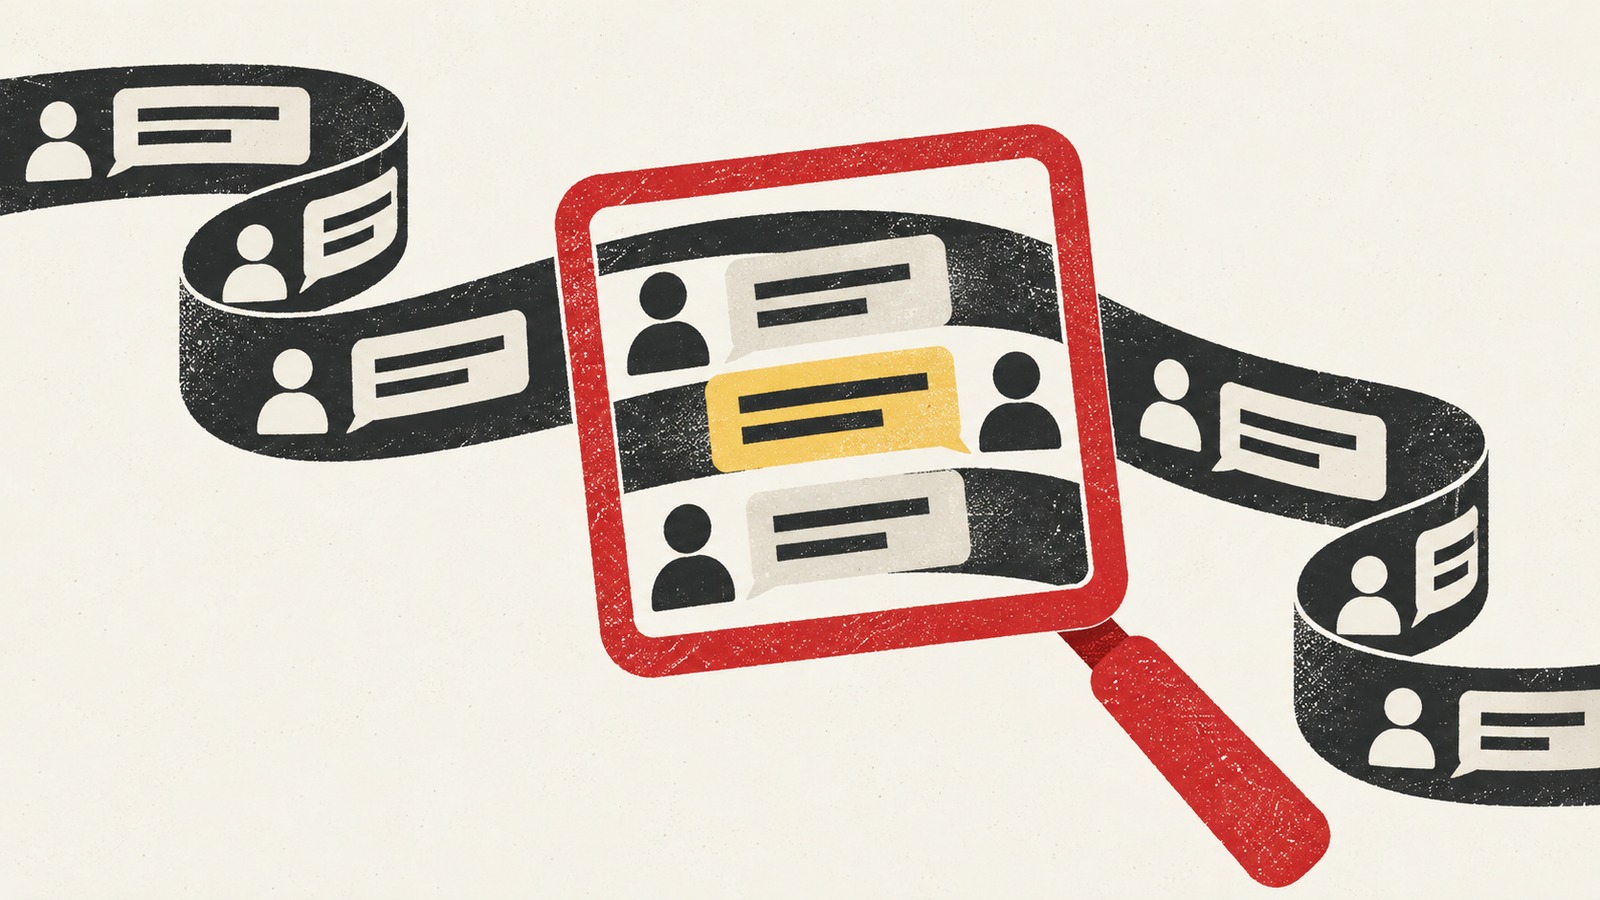
Agent说“已经完成”,不代表它真的完成了。要从成千上万段记录里找到这种差别,关键词往往不够。LangChain在10月13日推出LangSmith AI Search公开测试,允许团队用自然语言描述行为,再从执行轨迹中筛选匹配案例。它把临时排查变得更直接,但也没有把全部日志变成一次可以放心交给AI的完整审计。
快速看点:可查用户受挫、任务未完成等内容行为;结构化过滤先缩小范围,再由模型检查轨迹;公开测试需要管理员启用,读取范围、上下文截断与数据处理地点都有明确边界。
相似话题,不等于相同行为
传统日志搜索擅长定位错误码、标签和某个关键词。向量检索可以找到同一话题,却不一定区分“用户得到了帮助”和“用户不再继续追问”。两段对话都围绕取消订阅,最终结果却可能相反;排查者想找的不是话题相似,而是具体发生了什么。
AI Search让用户直接描述目标,例如助手声称任务完成但没有完成,或用户反复表达不满。它结合轨迹内容判断匹配,而不是只寻找一句固定表述。对工程团队,这意味着没有提前配置对应评估器,也能临时寻找值得复核的失败样本。
这类检索的价值在发现问题,不在自动定性。被返回的对话仍要对照工具结果与真实业务状态,确认用户要求是什么、系统执行了什么、最终是否达到目标。一个自然语言查询能帮助缩小样本,却不会替团队补齐缺失的验收定义。
先整理轨迹,再把有限上下文交给模型
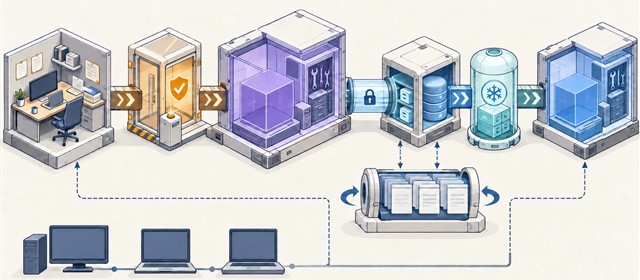
LangSmith的数据层把不同SDK记录整理为统一轨迹,将反复发送的历史消息去重,保留消息、工具调用和返回之间的顺序。这样一次会话不必因为每轮请求重复携带历史,而被检索模型重复阅读。同一套内容表示,也更容易支持不同开发框架的Agent。
但去重后的轨迹依然可能很长。当前方案按8K token预算选择内容:用户消息与面向用户的回复优先,其余空间再放中间消息、工具结果和系统内容,超出的部分会截断。这个机制控制了检索输入规模,也意味着“会话有记录”不代表检索模型读过全部证据。
如果问题只是用户是否表达不满,主要对话可能已足够;如果要确认Agent忽略了某条工具错误,关键细节却可能藏在未保留的长输出中。因此,没有检索到结果不能直接当作问题不存在。复杂事故仍需要回到完整执行记录,检查采集、解析和截断范围。
测试范围、权限和数据路径要一起看
公开测试覆盖LangSmith Cloud的GCP美国、欧洲和亚太区域,需由组织管理员开启。查询可以与结构化条件按AND结合;运行状态、名称和标签应使用相应过滤,而不是让模型从对话猜。一次先锁定应用、时间和异常条件,再描述行为,通常比对所有历史记录笼统提问更可控。
结果提供匹配置信度,打开记录可在轨迹视图查看高亮证据。这个分值反映描述匹配强度,不是业务错误率,也不是任务成功概率。复核证据还需要查看输入输出的权限,不能把AI检索当作绕开项目权限的一条捷径。
读取范围限于主智能体的轨迹,不包含子智能体、中间件或压缩消息内部内容。保存视图、统计等现有功能也有测试期限制。多Agent流程的某个子任务出现问题时,检索看不到内部过程并不意味着这部分已经正常完成,团队仍需保留对应追踪和人工检查入口。
区域可用性更不等于推理数据始终留在当地。AI Search使用LangChain管理的推理,启用意味着允许轨迹被传至美国处理;文档明确不应用于受保护健康信息。涉及客户数据的团队,需要在启用前核对处理范围、脱敏与授权,不能只看部署区域名称就判断数据路径。
小编判断:把检索结果变成可复核样本
这项能力适合临时排查、补充评测样本和发现产品痛点,尚不能代替全量审计或持续监控。行为描述本身也可能有歧义:用户离开,可能是满意,也可能是放弃。若团队没有统一判定标准,同样的问题交给AI搜索,也会得到难以比较的样本。
更实用的闭环是先找到候选记录,人工核对证据,再把确认的失败案例纳入固定评测集,追踪版本变化后的表现。上线初期还应抽查漏检与误检,尤其是工具长输出和多Agent流程。AI让找线索更容易,稳定改进则仍取决于可靠采集、清晰权限和可复现的验收。