


 您尚未登录账户
 您的企业账号申请正在审核中


别把900种结构全塞给模型,Orca拆解云安全查询
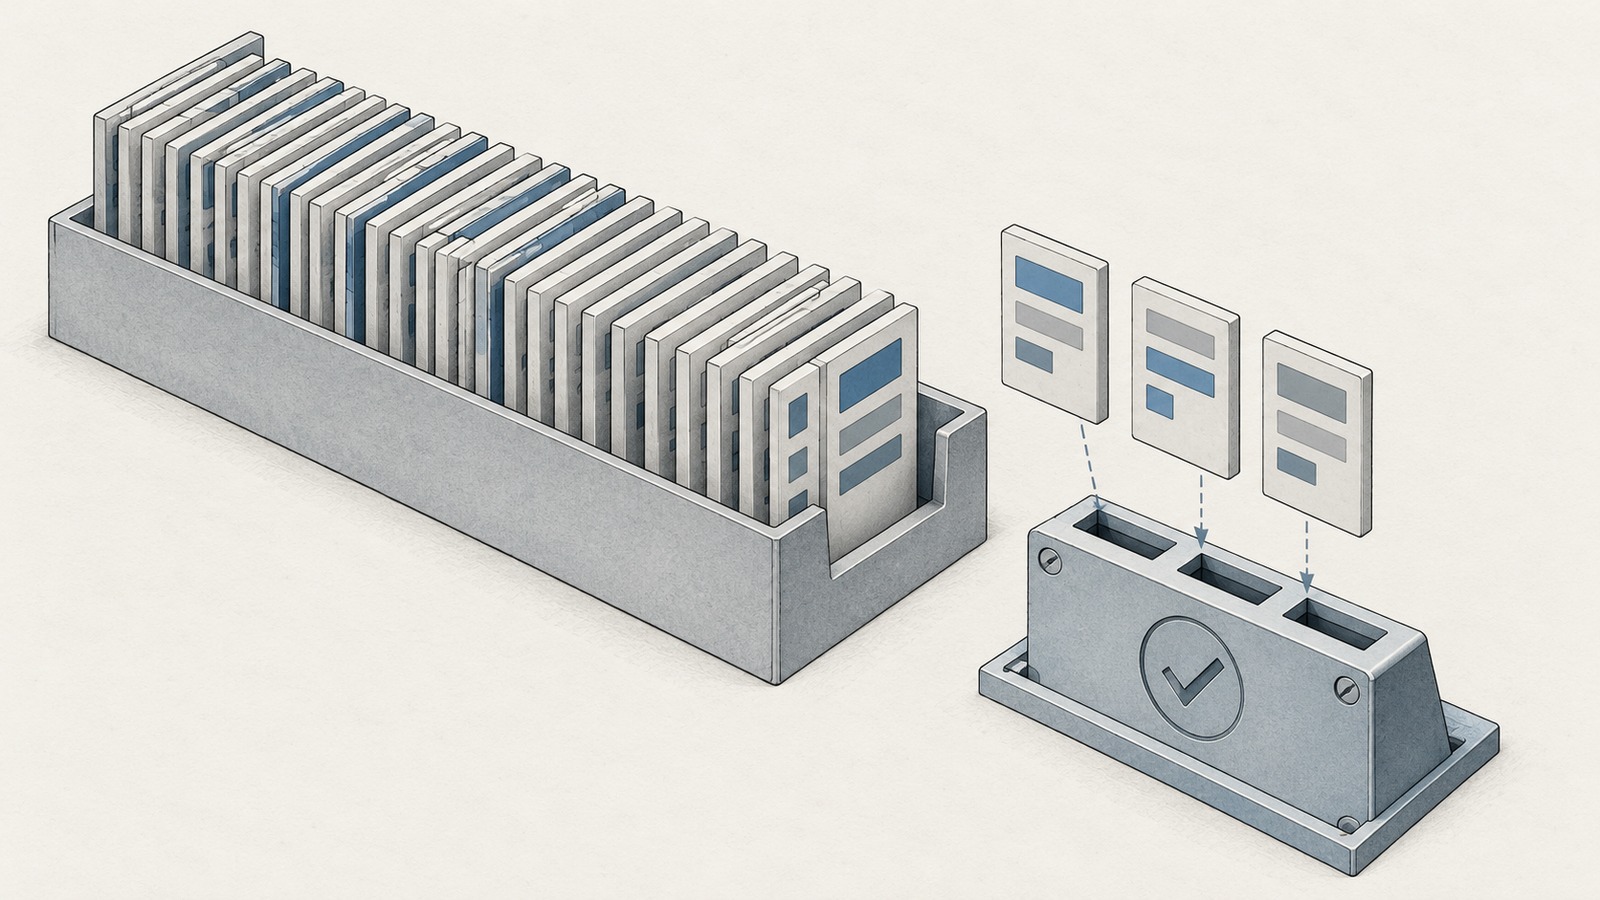
让AI查云资源,难点不只是读懂一句话,而是把问题翻译成系统真正认识的结构。Orca Security在10月13日披露Discovery AI的生产复盘:面对900多种资源模型,团队没有继续把全部定义塞进大模型,而是把查询拆成匹配、检索、选择、生成与验证。这个已投入生产的案例,展示了企业智能体如何从能演示走向可维护。
快速看点:明确的资源标识先走规则快路;有效示例和相关结构限制生成范围;静态与API验证之外,还需要权限约束和专家反馈,不能只凭一句“查询成功”判断交付完成。
900多种模型,指的是资源结构
Orca的Sonar是用于搜索和过滤安全数据的专用查询系统。这里的模型,是云实例、存储桶等资源类型及其字段和关系,不是900个大语言模型。用户查询需要准确指定结构名称、操作符及层级关系;自然语言表达轻松,系统执行却必须十分具体。
团队早期原型将大量结构定义和示例一次性放进提示词,证明自然语言接口有用,却也暴露了上下文冗长和复杂关系容易出错的问题。新的架构不把“窗口装得下”当作设计目标,而是只向生成阶段提供本次问题实际需要的信息。
这种区别也适用于企业数据库、产品目录和内部API。表名存在,并不说明表与表之间可以任意连接;字段看起来相似,也不代表业务意义一样。把全部定义交给模型自由猜测,和把有关的定义先挑出来,再限制它按定义构建结果,是两种不同的交付路径。
不必每次生成,规则与示例先分流
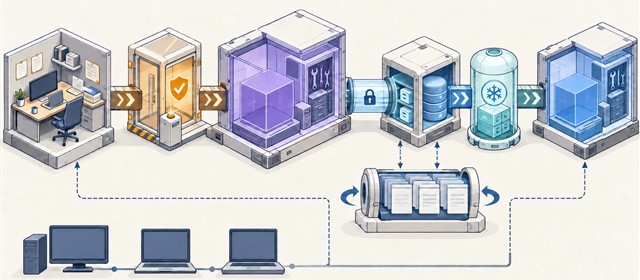
请求先携带用户组织、接入的云环境和必要上下文。对于IP、资源标识等高置信度结构化输入,确定性匹配可以直接形成预定义过滤条件,不必进入大模型推理。没有命中快路的请求,再进行相关性与安全检查,避免离题输入继续消耗后续步骤。
随后,系统召回20个经过验证的相近查询示例,并重排保留5个较相关的例子。足够可靠的匹配可以复用已有过滤条件,其余请求才进入生成。这里检索的是“类似问题如何表达成有效查询”,而不只是寻找一段讲安全概念的文字,RAG的业务对象因此更明确。
模型选择阶段再缩小所需资源结构,生成器拿到相关字段及连接关系。不同步骤可用不同模型承担,查询构建也可以迭代修正。真正可复用的原则是让每一步拥有窄目标和可检查输出,而不是把所有判断都集中到一次长回答里。
验证失败要回到定义,不是再猜一次
生成结果先做静态检查,再通过Sonar API验证。字段、模型和操作符必须能对应已选结构定义;错误信息会标出具体问题并返回生成器。修复次数到达上限仍无有效结果,就返回失败,而不是无休止重试。这样的闭环让失败可见,也让改错有依据。
但格式和语义检查不能替代权限。一个有效查询仍可能超出提问者应看的范围,或把资源关系理解得不完整。企业实施方需要让组织上下文与真实访问控制共同约束查询,把模型筛查作为附加防线,而不是认证与授权的替代品。查数据的助手也不应被直接等同于自动修改云配置的系统。
持续改进依靠领域专家。团队提供标注入口,让产品、支持和安全人员修正查询并补充示例;低置信匹配进入人工处理,新的有效案例再回到检索池。这样,业务专家的修正不只是一次聊天建议,而能成为后续查询可复用的材料。
生产评测也按问题类型、资源家族和复杂度切片,检查正确性、完整性与参考查询的语义一致性。一次总体分数上涨,仍可能掩盖某类多资源查询退步;提示词、模型或召回参数改变后,应回到相同切片观察。这比只在发布前展示几条顺畅演示更接近可靠交付。
小编判断:先减少猜测空间,再谈更强模型
这次新披露的是生产方法,不是把既有产品再次写成今天首发。成本与延迟的前后变化还需要完整样本、任务定义和计费条件才能公平比较;本案例不能证明所有企业只要增加检索就能获得相同收益,也没有给出可替代人工验收的通用准确率保证。
对FDE与企业实施团队,可复制的部分是分流策略、结构筛选、有限修复和专家标注回流。首先找出哪些问题无需生成、哪些结构无需带入、哪些错误必须阻断,再衡量完成率、人工介入和总任务成本。模型变强可以扩大能力,但清楚的业务边界才能让这种能力稳定进入生产。