


 您尚未登录账户
 您的企业账号申请正在审核中


973条线程省64%成本,LangChain把路由器放进Agent
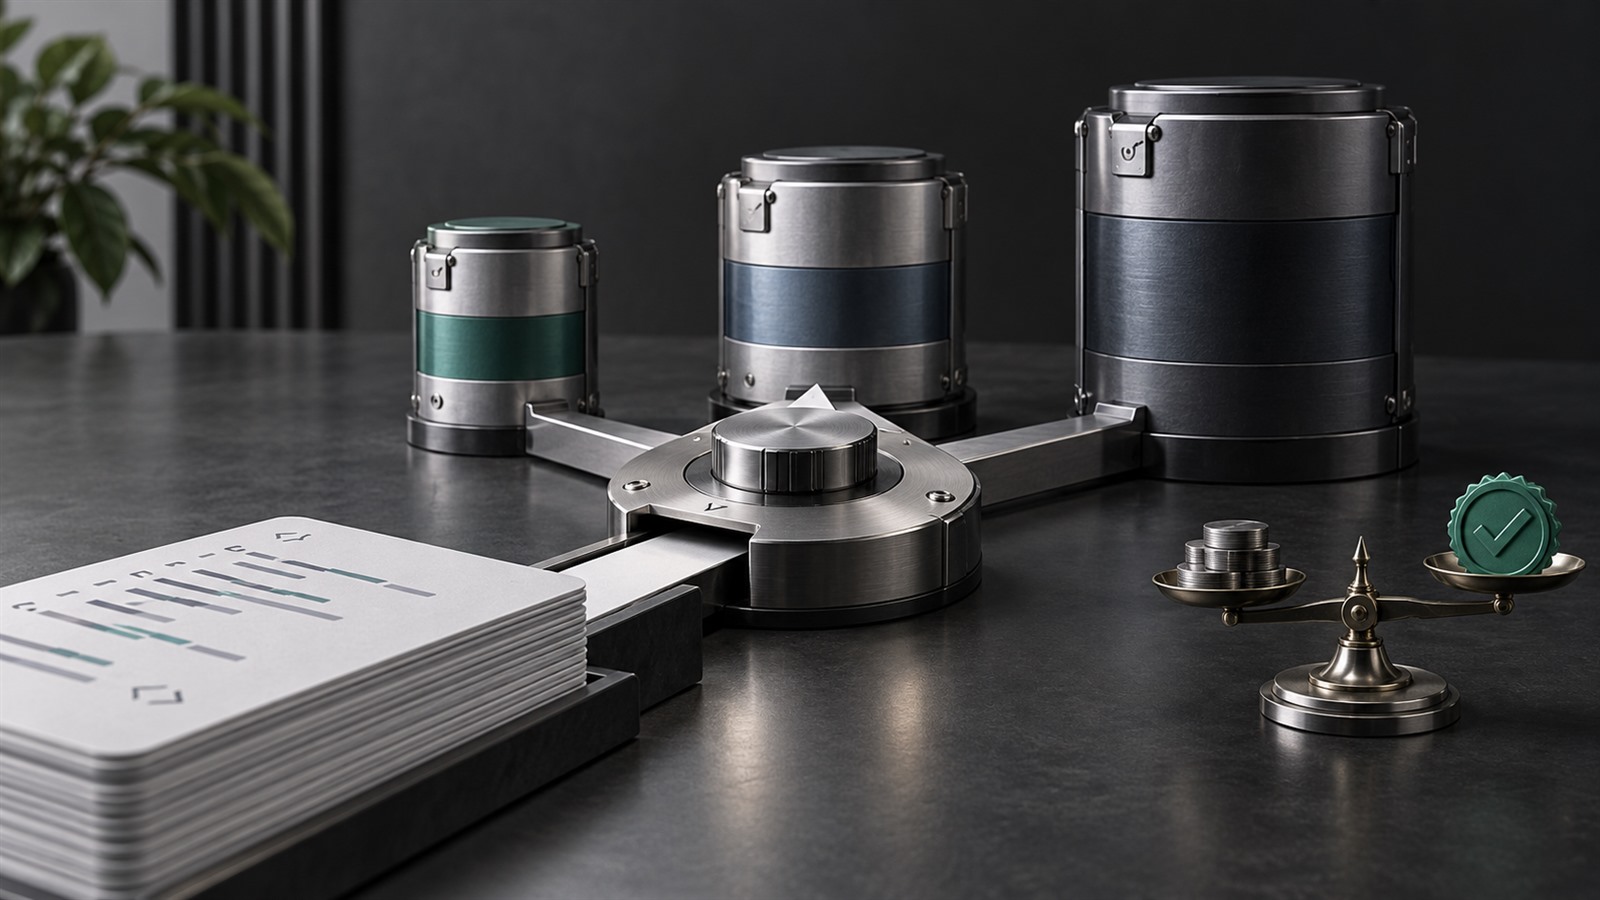
让最强模型处理每一个编码任务,质量未必增加,账单却一定更高。LangChain在Open SWE Agent Harness中完成973条真实线程A/B测试:路由组中位成本为0.94美元,固定使用GPT-6 Astra的对照组为2.61美元,下降64%;合并PR比例为29.2%对27.3%,本次实验没有测到显著质量差异。
路由器放在Harness里,才看得到真正的任务
团队先收集约一周交互轨迹,为任务类型制作标签,再训练路由逻辑。关键选择是把路由放进Agent Harness,而不是放在只看一段提示词的模型网关。Harness知道仓库状态、任务阶段、工具返回和历史尝试,能区分简单修改、常规开发与高难推理,并在运行中重新判断。
这类路由不是一次训练后永久固定。任务分布、模型价格和代码库都会变化,团队需要定期回看误路由案例,更新标签和阈值,并保留每次选择的理由,才能判断节省来自合理分层还是把困难任务错误下放。
路由器在fast、balanced和performance三档之间选择。测试流量中,56%进入balanced,34%进入fast,只有10%进入performance。三个档位的中位线程成本约为0.097、1.50和2.88美元,最便宜与最昂贵之间接近30倍。只要任务分布中存在大量轻量工作,分级本身就有可观节省空间。
成本差距也放大了分类错误的代价:把简单任务误送到最高档会浪费预算,把复杂任务误送到快速档则可能增加重试和人工纠正。路由评测必须把首次选择与整条线程的最终成本一起计算。
973条线程显示省钱,但没有证明模型绝对等价
A/B测试把973条线程近似均分。路由组打开PR的比例为38.9%,固定高性能模型组为39.6%,p值0.82;合并PR比例为29.2%对27.3%,p值0.49。更准确的说法是“未测到可区分差异”,而不是路由组已经被证明与高性能模型完全等价。
如果样本继续扩大,差异仍可能出现;反过来,即便合并率接近,也不代表生成代码的可维护性、审查时间和后续缺陷完全相同。企业应为每个业务结果设定可接受区间,而不是只等一个显著性数字。
成本信号更明确:除中位数下降64%外,平均线程成本下降42%,p90下降37%。这说明路由既削减了典型任务开销,也压低了高成本尾部,但不同统计口径差异很大。企业做预算时,应同时看中位数、均值和尾部,不能把64%直接写进所有场景的财务预测。
一次失败实验提醒:用户抱怨也是上线指标
团队还尝试过全部请求使用快速模型,但工程师很快投诉体验下降,实验不到一天就停止。样本不足,无法形成统计结论,却揭示了自动指标的盲区:PR是否打开、是否合并,并不能完整描述等待感、返工量、代码可读性和人工纠错负担。
本次结果也主要依赖合并PR和较稀疏的用户反馈,缺少完整离线评测、人工介入率与长期维护质量。Open SWE本身仍在活跃开发,官方明确提示存在粗糙边角,正确性和稳定性不作保证。它更适合作为实验Harness,而不是未经验证直接复制的生产模板。
生产试点应先限定仓库、任务和用户群,设置快速停机条件,并让工程师能看到当前模型档位与升级路径。这样,主观体验的恶化可以在统计指标尚未变化前被捕获。
小编判断:模型FinOps必须和任务结果绑在一起
这项实验给企业最实用的启示,是路由不能只按价格表或公开基准做静态选择。团队需要在自己的Harness里记录任务类型、上下文规模、工具失败、重试次数、人工接管和最终业务结果,用真实轨迹建立分层,再以A/B测试验证节省是否换来了隐性返工。
上线时还应设置回退条件:低档模型连续失败、测试不通过或用户主动否决,就升级到更强档位;高性能模型只处理真正需要的尾部任务。能省下成本的不是“永远用便宜模型”,而是让系统知道什么时候便宜足够、什么时候必须为可靠性付费。