


 您尚未登录账户
 您的企业账号申请正在审核中


工具超40个就易选错,Postman把170项能力压到15项
一个成熟平台把170多项能力全部交给大模型,结果并不是“懂得更多”,而是更容易选错工具。10月9日,Postman与AWS联合披露Agent Mode的生产架构:测试中,当模型可见工具超过约40个,选择错误就明显增加。团队最终让根Agent先做检索,把每次请求压缩到约15个候选工具,再交给上下文隔离的子Agent执行。
11年旧平台,难点不是接上模型而是重做语义
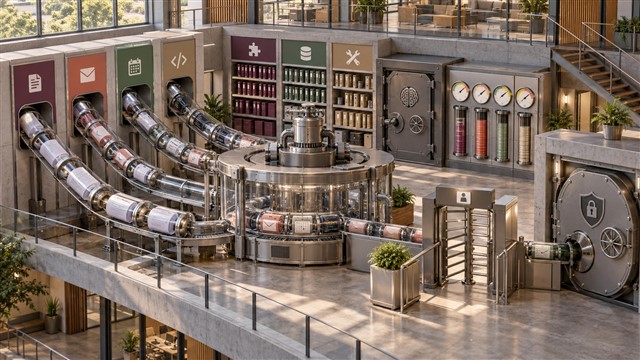
Postman已有11年产品历史,很多数据结构最初服务于界面渲染。页面能正确显示,并不意味着同一份对象适合模型推理:字段可能冗长、关系隐含、重要信息分散在不同视图。团队因此没有把现有前端状态原样塞入提示词,而是建立两类上下文:系统自动收集的“广而浅”信息,以及用户明确选中的“窄而深”材料。
不同数据类型由专用处理器转换,避免一个通用序列化器承担全部语义。这个决定看似增加工程量,实际是在控制幻觉来源:Agent看到的是任务需要的业务对象,而不是为了页面组件方便拼装的展示数据。对拥有多年遗留系统的企业,这往往比换一个更大模型更关键。
这种双层上下文还有一个运营收益:系统可以默认提供安全、低成本的公共背景,只有用户主动选择时才装载更深、更敏感的数据。上下文不再越积越多,也更容易解释一次回答到底使用了哪些业务材料。
根Agent先缩小工具面,子Agent才负责完成任务
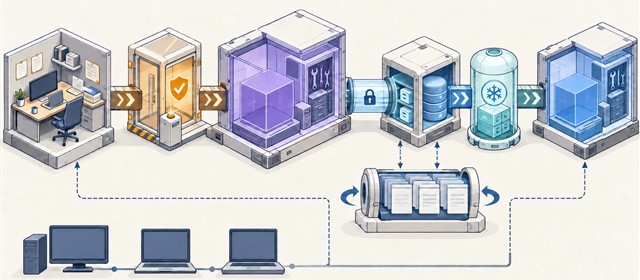
Postman把工具描述制作成向量嵌入,由根Agent依据请求检索相关能力。超过170项的完整工具库不会同时进入模型上下文,约15项候选被传给独立子Agent。这样既减少token占用,也让执行Agent少在相似工具之间犹豫。子Agent上下文彼此隔离,避免一个步骤的长轨迹污染后续判断。
团队还用结构化schema和ClickHouse查询替代大量窄小的只读工具。与其为“查集合”“查请求”“查环境”各造一个接口,不如让Agent在受控查询面上组合条件。可写操作则走另一条路径:凡是改变状态的动作,必须向用户展示并获得批准,读取和执行不再共享同一权限。
这也意味着工具目录需要持续维护。新增能力不能只登记接口名称,还要描述适用任务、权限级别、输入约束和失败结果;否则向量检索即使召回了“相似工具”,也可能在业务语义上选错。
跨区域推理、缓存和隐私必须一起设计
运行层通过Amazon Bedrock调用Claude系列模型,并使用跨区域推理配置提高容量与可用性。提示缓存被拆成稳定核心与变化上下文:核心保留1小时,动态部分保留5分钟,长时缓存点位于短时缓存点之前。这个顺序能让共享指令重复利用,同时避免频繁变化的数据不断击穿缓存。
管理员可以启用Bedrock Guardrails处理PII,模型数据保留则依赖具体模型与配置。跨区域推理提高可用性,也要求企业提前确认允许处理数据的地域、故障切换边界和审计留痕,不能只把它当成容量开关。
官方没有披露Agent Mode活跃用户、任务成功率、延迟、人工介入率或ROI,也没有开放完整实现代码。因此,这是一份生产架构复盘,不是经过独立审计的性能证明;“4000万开发者”只能描述Postman整体社区规模。
小编判断:企业Agent的第一道优化往往是减少选择
这套方案最有价值的地方,不是把更多工具接进模型,而是承认工具面越大,可靠性可能越差。企业实施时应先按任务构建能力目录,记录每个工具的读写级别、数据范围、失败方式和审批要求,再用检索或规则形成最小候选集。路由错误率、工具重试率、审批拒绝率和上下文命中率,都应进入上线指标。
Agent要进入老系统,真正的工程量集中在语义重构、权限隔离和退化路径。模型能力决定上限,有限工具集、确定性审批和可复用缓存才决定日常稳定性。先让系统少做选择,再让它做对选择,是比无限扩充工具清单更现实的生产路线。