


 您尚未登录账户
 您的企业账号申请正在审核中


共用一个MCP入口,Eon仍把生产调查锁在只读边界
给AI接上更多工具,不等于可以放心把生产系统交给它。云数据公司Eon在10月20日披露的一次内部落地,把开发者和运维Agent都接到同一个MCP网关,却没有给双方相同的权限:生产调查保持只读,少量写操作只开放给获准的Agent身份。它解决的首先是接入与授权问题,而不是宣布AI已经能独立修复所有故障。
快速看点:一个入口汇集跨云调查工具;人员与Agent使用不同身份;每次工具调用先过策略检查。大工具目录还要在动态发现、语义搜索和权限管理之间取舍。这是一项已运行数月的工程复盘,不是AgentCore当天才上线。
一个故障,往往要穿过多套系统
Eon的工程团队需要调查AWS、Azure与Google Cloud上的运行问题。排查一个崩溃的Kubernetes容器,可能同时涉及日志、Grafana指标、部署对应的GitHub变更和云服务状态。此前每增加一套工具,就多出一组凭据、一个本地MCP进程以及需要维护的配置。
这类复杂度不只让新人接入变慢,也使内部SRE Agent难以获得与工程师相同的调查上下文。把所有令牌简单复制给Agent虽然方便,却会把原有分散权限一并放大;工具越多,越难回答究竟是谁允许了哪一次调用。
团队考虑过自建集中代理,但那意味着还要自己维护协议转换、会话和授权。最终采用的组合包括AgentCore Gateway、Runtime、Identity与Policy,把统一接入和细粒度控制放到同一条请求链上。业务工具仍有各自的执行位置,并没有变成一个无边界的超级工具。
同一入口,不是同一把万能钥匙
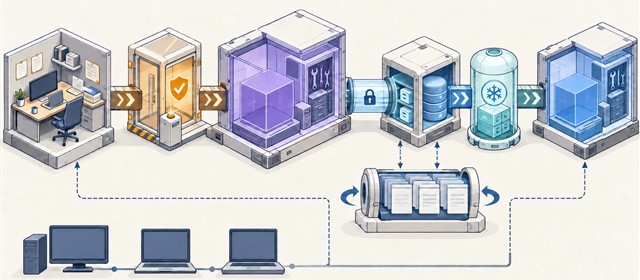
开发者在编程工具中配置一个MCP地址,通过企业单点登录接入;内部Agent则使用自己的机器身份。Cognito承担令牌环节,Gateway据此识别调用主体。两者能访问同一入口,不代表能看到或执行同样的操作。
Eon将Cedar策略放在实际执行的ENFORCE模式下,而非仅记录本应拦截什么。网关在转发每次tools/call之前检查权限,策略按工作角色、身份和工具划界。策略改动经过GitHub变更请求审查,方便保留谁修改了权限的记录。
案例中的生产访问是只读的,并按需审批、审计。写权限限于获准Agent身份可以执行的低影响协作动作,例如为工单或代码变更添加评论;这不能解读为允许Agent改动生产配置、发布代码或自动执行故障恢复。
跨AWS账户的Runtime通过IAM角色信任接入网关,减少逐账户维护网络连接的负担。这里说的是特定AWS账户间的接入设计,不是三家云天然共享身份,也不是所有下游服务都不再需要凭据、网络与安全配置。
工具目录变大后,发现也有代价
Eon称该架构已服务超过100名开发者、处理约一万次会话。规模带来的一个具体问题是工具定义预先索引后,相关策略占用接近配额。团队为工具量大的目标采用DYNAMIC目录模式,在收到请求时再向MCP服务获取能力列表。
动态模式并非免费升级。由于工具没有在网关侧预先索引,这些目标不能使用网关的语义工具搜索。需要相关能力的目标继续采用默认模式;两类目标混用,而不是为了减少目录负担就关闭所有预索引。
部分MCP服务暴露的操作远超单个角色所需,Eon又在Runtime侧增加包装层过滤工具目录。减少展示噪声有助于选工具,但目录过滤不能代替调用时授权。真正能否执行,仍应由经过验证的身份和策略决定。
另一个障碍来自OAuth会话衔接。常用MCP客户端期待的state保护机制,与该案例采用的服务端会话绑定方式存在适配工作,团队增加API Gateway中间层处理。一个统一URL只是交付结果,背后仍有协议兼容和测试成本。
小编判断:先证明越权被拒,再谈节省多少
这份复盘的价值在于公开了中央网关的实际边界:工具发现、身份验证、授权和执行是不同环节,不能只靠模型提示词承诺“不要修改生产”。网关集中化减少重复配置,也会让策略错误影响更多调用,因此负向权限测试应与接入一起交付。
案例没有提供可供独立复算的故障恢复时长、调查准确率或全链路成本实验。接入更快不能自动推导出故障修复更快,工具可达也不等于Agent判断正确。企业评估时应把访问准备、调查质量与恢复结果分开计量,不照搬一个效率百分比。
可复用的起点,是选一条真实但只读的调查流程,固定允许调用的工具,测试普通人员、获准Agent和未获准身份各能做什么;再验证凭据过期、目标失联和策略变更后的行为。只有拒绝路径和审计记录同样清楚,统一入口才算完成治理,而不只是完成连通。