


 您尚未登录账户
 您的企业账号申请正在审核中


百万输入0.15美元,MiniMax更新低价Agent模型
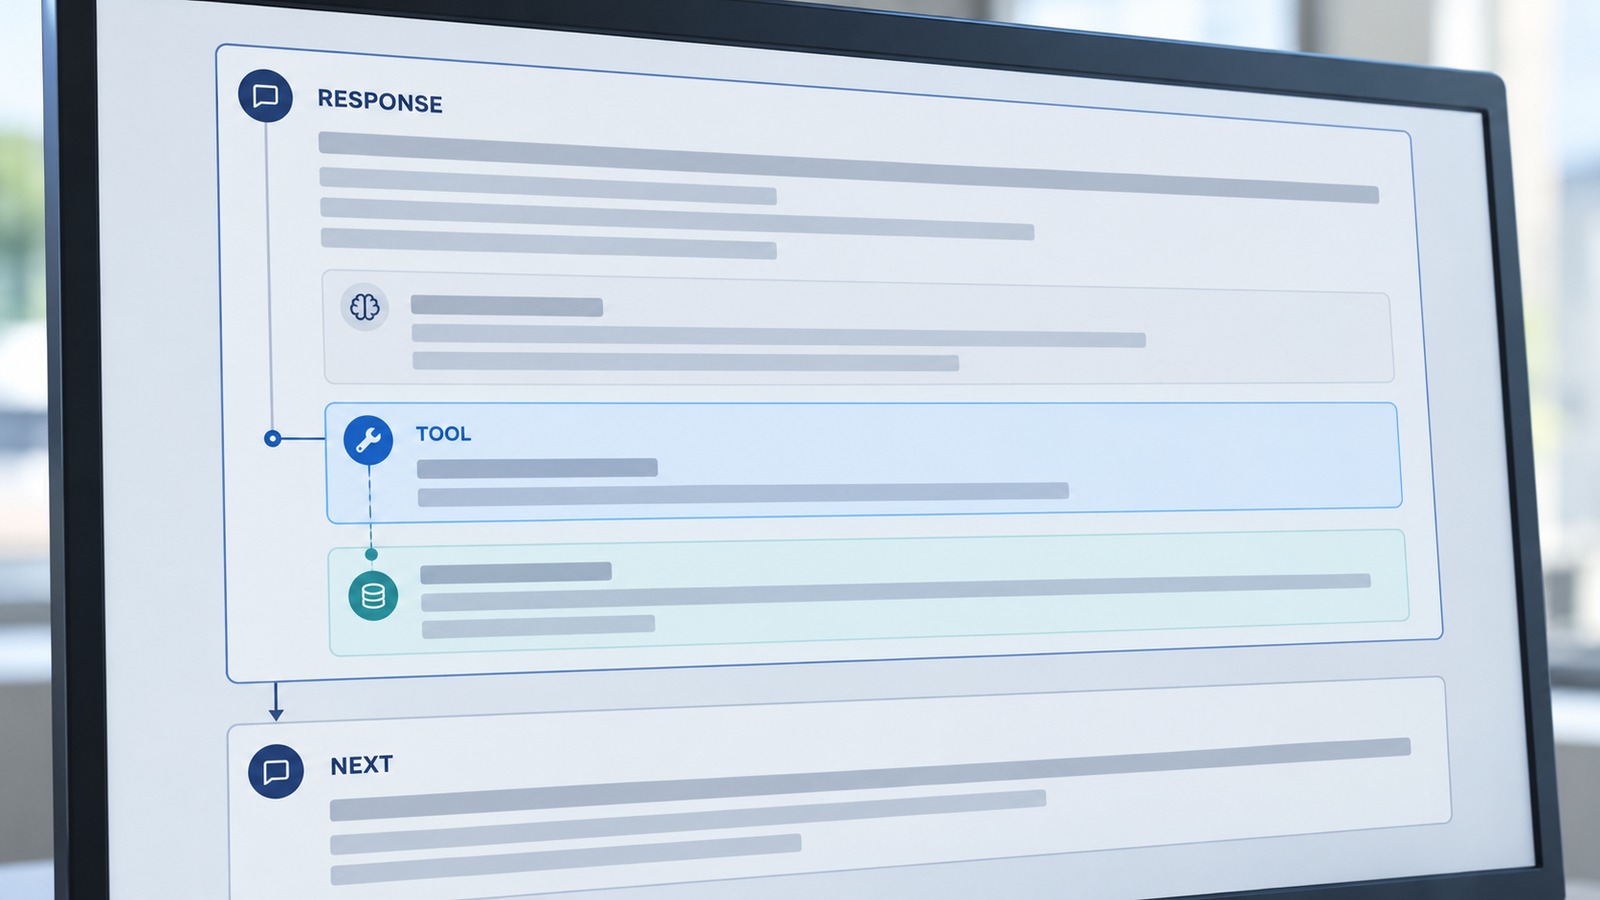
每百万输入token收费0.15美元,听起来足以让企业多开几个Agent。但MiniMax在10月19日推出的M3.1 Flash,真正需要接入团队注意的,不只是单价:简单工具调用可以直接执行而不生成思考字段,多轮任务却仍要求保留模型返回的完整消息。少存一个字段,可能省不了多少费用,反而破坏后续工具链的连续性。
快速看点:新模型已进入MiniMax API、M Plan和MiniMax Code;输入、输出与缓存命中按不同价格计算;权重仍计划后续发布,不能把API可用写成已经开放权重。对企业而言,单次生成便宜与一项业务真正低成本完成,仍是两道题。
先算清三种token,再谈任务成本
当前标准定价以每百万token为单位:输入0.15美元,输出0.60美元,缓存输入0.015美元。三者不是同一项优惠。输入是送进模型的内容,输出是生成的内容,缓存价格只适用于符合缓存计费条件的输入;不能把最低一档价格套到所有请求,也不能直接换算成每千字成本。
用一个简化例子看,如果一次任务累计消耗100万普通输入token和10万输出token,只计算这两项模型费用,结果为0.15加0.06,共0.21美元。这个数不包含外部工具、运行环境、失败重试和人工检查,实际账单还要按真实计费项目核算,也不能假设所有历史内容都会命中缓存。
Agent任务往往不是一次问答。搜索、读文件、生成代码和等待工具结果都可能触发下一次请求,旧上下文也会反复参与计算。因此,合理比较对象应是同一类任务在相同验收标准下的完成成本,而不只是把不同模型的输入价摆在一张表里。企业还应记录失败后重跑的次数与范围。
没有思考字段,不一定是接口出错
MiniMax的工具调用文档明确,M3.1 Flash采用按需思考:简单工具调用可能直接返回工具动作,没有thinking块或reasoning_content字段。客户端应先检查字段是否存在,不能因为它缺失就把合法响应当成异常,再自动补发同一个有副作用的操作。
但按需思考不等于调用方可以任意裁剪消息。多轮工具交互需要把完整assistant响应追加到历史中,包括实际返回的推理相关字段与tool_calls;采用另一种兼容消息格式时,也要保留完整内容块,而不是只抽取屏幕上显示的最终文字。这是模型状态衔接问题,不是要求把所有内部字段展示给终端用户。
这一要求对现有Agent框架尤其重要。有些中间层为了统一多个模型,只保存content文本;另一些会把工具调用转换成自己的摘要。如果转换过程丢掉调用标识、参数或返回结构,下一轮就可能失去上下文。接入测试应覆盖工具成功、失败、空结果和连续多轮,而不只检查一条天气查询。
上线范围明确,性能口径还要分开
发布公告称M3.1 Flash已经可通过MiniMax API、M Plan及MiniMax Code使用,并说明模型权重会在之后发布。这意味着开发者能够选择托管接口接入,但不能据此认定已经具备可下载权重、可离线运行或可在企业私有机房直接部署的同等条件。
MiniMax同时给出了推理速度、任务费用以及多项Agent和编程基准结果。这些数字属于供应商报告,涉及特定任务、执行框架与测量方式。当前可检查的价格和工具调用文档,能支持接口及计费事实,却不能独立证明所有企业工作流都会获得相同降本或提速,因此不宜直接当作预算承诺。
软件研发、财务文件处理和销售运营虽然都可能用到工具,但验收对象不同。代码任务需要测试与依赖检查,财务内容需要核对数据和授权,运营任务可能涉及给客户发送消息。模型能在基准中调用工具,不等于某个企业流程已经具备可以放心全自动运行的控制措施。
迁移时还应把模型调用与外部动作分开记账、分开恢复。读取失败可以重新获取,发送邮件、变更订单等动作则需要先核对上次是否生效。即便模型请求价格很低,也不应把无限重试当作可靠性策略;否则最昂贵的部分可能不在token账单,而在错误操作后的修复。
小编判断:低价更值得拿来做严格评测
M3.1 Flash的价值,在于降低一批Agent任务进入测试和持续运行的模型费用门槛,而不是取消交付验证。对已有工具链的团队,先确认完整消息如何存储、字段缺失如何处理、工具结果如何接回,再比较同一任务的质量、重试和人工介入,通常比立刻扩大全自动执行范围更有意义。
比较方案时,可以同时保留一个低价模型和原有基线,把真实失败样本、长对话与权限边界放进固定任务集。只有在结果质量、执行可控与单项任务成本一起改善时,便宜才真正变成交付优势。价格可以很快改变,可靠的消息契约与操作边界则需要在系统中长期保留。